O caminho desta parte
- Escalonar para o gradientea curvatura da perda; uma só taxa de aprendizado
- Escolher a potênciaBox-Cox, Yeo-Johnson, quantis
- Codificar para o modeloa coluna descartada; centenas de níveis; target encoding
- Imputar pelas outras colunasKNNImputer, IterativeImputer; conferir os valores
- Montar a receitao mapa, coluna a coluna
Um vale comprido ou uma tigela redonda
Com perda quadrática, a curvatura em cada direção é dada pela variância dos atributos: os autovalores de \(M^\top M / n\), com \(M\) a matriz centrada (idade, tarifa) de \(n\) linhas.
| bruta | 208,62; 2798,59 | razão 13,4 |
| padronizada | 0,9; 1,1 | razão 1,2 |
Uma taxa de aprendizado segura na direção íngreme se arrasta na direção plana.
Deixe os dados escolherem a potência
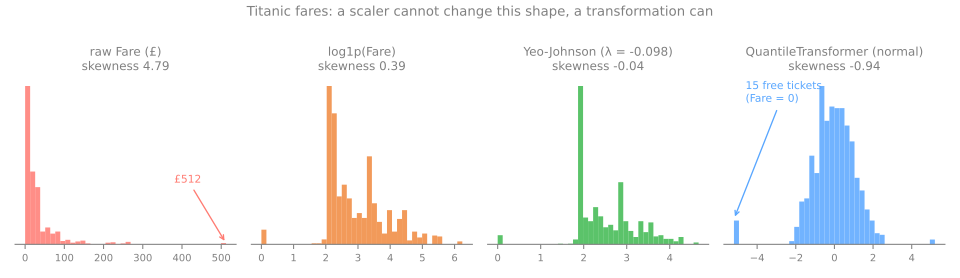
Box-Cox
\(x' = (x^\lambda - 1)/\lambda\), com \(\lambda = 0\) significando \(\log x\); \(\lambda\) por máxima verossimilhança. Exige \(x > 0\): recusa os 15 bilhetes gratuitos.
Yeo-Johnson
aceita zero e negativos. \(\lambda = -0{,}098\), perto de um log → assimetria −0,04.
QuantileTransformer
troca cada valor pelo seu posto → −0,94; os 15 bilhetes gratuitos se empilham em −5,20.
PowerTransformer padroniza a saída por padrão (forma, depois escala). Os quantis guardam só a ordem.One-hot e o intercepto: a coluna descartada
| porto | intercepto | C | Q | S | C + Q + S |
|---|---|---|---|---|---|
| S | 1 | 0 | 0 | 1 | 1 |
| C | 1 | 1 | 0 | 0 | 1 |
| S | 1 | 0 | 0 | 1 | 1 |
| Q | 1 | 0 | 1 | 0 | 1 |
| S | 1 | 0 | 0 | 1 | 1 |
| C | 1 | 1 | 0 | 0 | 1 |
As três colunas de porto sempre somam a coluna do intercepto: posto 3 para 4 colunas.
Os pesos não são únicos: somar 5 aos três pesos de porto e subtrair 5 do intercepto dá as mesmas previsões.
drop='first' remove C, a referência: posto 3 para 3 colunas; cada coeficiente se lê "em comparação com Cherbourg".
drop='first' para modelos lineares com intercepto e sem penalidade. Mantenha todas as colunas para árvores, k-NN (k vizinhos mais próximos) e modelos regularizados: para uma distância, "referência" e "desconhecida" seriam ambas 0 0.Alta cardinalidade e target encoding
Ticket tem 681 valores distintos para 891 linhas: o one-hot criaria 681 colunas quase só de zeros, sobreajuste garantido.
- Primeiro procure a estrutura escondida: a letra do deck em
Cabin, o título emName(Mr, Miss, Mrs, Master...). - Depois agrupe os níveis raros:
min_frequency=10mantém 4 títulos e junta os outros 13. - Target encoding: trocar cada categoria pela média do alvo naquela categoria. Uma coluna só, qualquer que seja a cardinalidade.
O target encoding vaza
| codificação de puro ruído | treino | teste |
|---|---|---|
| média ingênua por categoria | 0,775 | 0,505 |
TargetEncoder (com cross-fitting) | 0,496 | 0,505 |
- A maioria dos bilhetes aparece uma ou duas vezes, então o valor codificado de uma linha é, em boa parte, o próprio rótulo dela: o modelo aprende a ler a resposta, não a prevê-la.
- Cross-fitting: o
fit_transformcodifica cada fold com médias dos outros folds, de modo que nenhuma linha vê o próprio rótulo; as categorias raras são puxadas para a média global.
fit_transform no treino, transform no teste. Opções sem o alvo: codificação por frequência, hashing.KNNImputer, à mão
Mr. James Moran pagou £8,46 e não tem idade. O imputador procura os \(k = 2\) passageiros de tarifa mais próxima e tira a média das idades deles.
| passageiro | idade | tarifa | |tarifa − 8,46| | |
|---|---|---|---|---|
| 3 | 26 | £7,93 | 0,5 | |
| 1 | 22 | £7,25 | 1,2 | |
| 4 | 35 | £53,10 | 44,6 | |
| 2 | 38 | £71,28 | 62,8 |
Imputar a partir das outras colunas
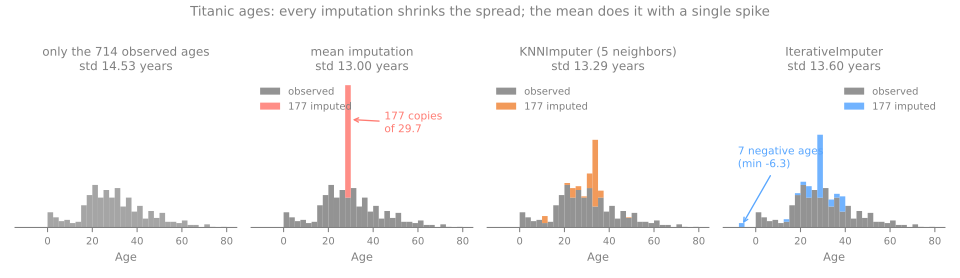
KNNImputer
média das \(k\) linhas mais parecidas. Com classe, irmãos e pais: desvio 13,29, nenhuma idade impossível.
IterativeImputer
uma regressão de cada coluna sobre as outras, em ciclos (MICE, imputação múltipla por equações encadeadas). Produziu 7 idades negativas: não sabe que idade é positiva.
O mapa do pré-processamento
Por coluna: ausentes → forma → escala, toda etapa ajustada nas linhas de treino. Clique nas respostas para montar a receita.
Quais famílias se importam com qual etapa
| família de modelos | escala | forma | codificação | valores faltantes |
|---|---|---|---|---|
| k-NN, k-means, SVM, PCA | obrigatória | ajuda | one-hot | precisam ser imputados |
| regressão linear/logística, redes neurais | obrigatória | ajuda | one-hot, drop='first' sem penalidade | precisam ser imputados |
| árvores, florestas aleatórias, gradient boosting | desnecessária | desnecessária | códigos ordinais servem | as árvores do scikit-learn aceitam NaN |
SVM: máquina de vetores de suporte; PCA: análise de componentes principais; NaN: not a number, o valor ausente.
Resumo
- Escalonar também deixa a perda redonda: uma só taxa de aprendizado para todos os pesos.
- Deixe os dados escolherem a potência: o Yeo-Johnson aceita zeros; \(\lambda\) se aprende no treino.
drop='first'só para modelos lineares com intercepto e sem penalidade.- Centenas de níveis: estrutura, níveis raros agrupados, target encoding com cross-fitting.
- Imputadores que usam as outras colunas espalham os palpites; confira o que eles inventam.
Um único objeto, um modelo caixa-preta e imputadores mais espertos: passos 7 a 9
- Passo 7: toda estatística num único
ColumnTransformer: 12 colunas, nenhumNaN, nenhum texto. - Passo 8: um k-NN usado como caixa-preta, com e sem escalonamento. Passo 9: imputadores que usam as outras colunas.
- Continue no notebook do lab, na mesma sessão.
- Simulações: forma antes da escala (passo 8) e um imputador mais esperto dentro do pipeline (passo 9).
Ritmo: passo 7 em 5 min; passo 8 e a primeira simulação em 10 min; passo 9 e a segunda em 10 min.