O algoritmo só enxerga números
Ele minimiza o custo com os números que você entregou. Se estiverem mal preparados, minimiza a coisa errada, com toda a convicção.
escalas incompatíveis
a coluna com os maiores números domina distâncias e penalidades
Fare vai de 0 a 512, SibSp de 0 a 8
texto
não existe aritmética com "female"
Sex, Embarked, Cabin, Ticket, Name
buracos
a maioria das implementações recusa NaN (not a number, o valor ausente)
Age falta em 19,9%, Cabin em 77,1%
Cada etapa é medida em poucos números que dá para conferir na calculadora e depois no Titanic (891 passageiros da viagem de 1912). A EDA (análise exploratória de dados) olhava a tabela; esta aula a muda.
O caminho desta parte
- Escalonara unidade decide a distância; quatro escalonadores
- Ajustar só no treinofit uma vez nas linhas de treino, transform no resto
- Corrigir a formaassimetria; um log, não um escalonador
- Codificar categoriasordinal, one-hot, categorias inéditas
- Imputar faltantespor que falta; um valor; uma flag
Três passageiros, à mão
| passageiro | idade | tarifa | |
|---|---|---|---|
| A | Braund, Mr. Owen Harris (3ª classe) | 22,0 | £7,25 |
| B | Connors, Mr. Patrick | 70,5 | £7,75 |
| C | Pears, Mrs. Thomas (1ª classe) | 22,0 | £66,60 |
Em unidades brutas, o senhor de 70 anos ganha
| par | diferença de idade | diferença de tarifa | distância |
|---|---|---|---|
| A–B | 48,5 anos | £0,50 | \(\sqrt{48{,}5^2 + 0{,}5^2} = 48{,}50\) |
| A–C | 0 anos | £59,35 | \(\sqrt{0^2 + 59{,}35^2} = 59{,}35\) |
48,5 anos é um número menor que 59,35 libras. Nada diz que um ano e uma libra deveriam pesar o mesmo: é só o que acontece quando se subtraem números brutos.
Padronizado, a ordem se inverte
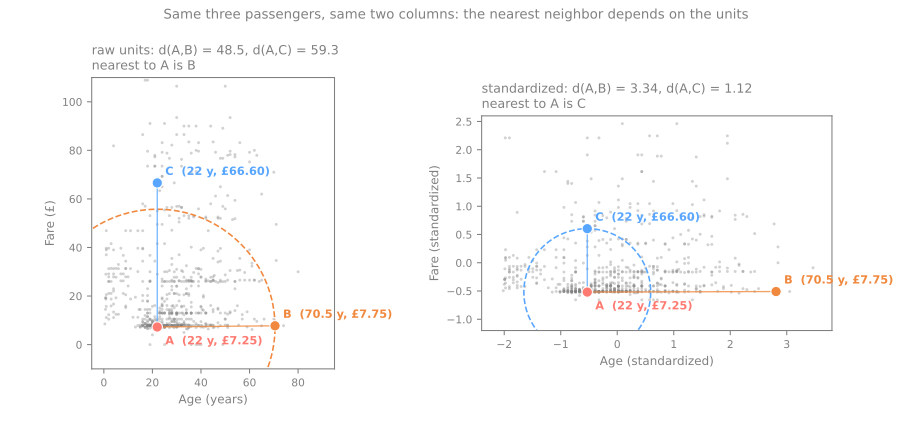
A–B: \(48{,}5 / 14{,}52 = \mathbf{3{,}34}\) desvios
A–C: \(59{,}35 / 52{,}88 = \mathbf{1{,}12}\) desvio
\(\mu\) e \(\sigma\) calculados sobre os 714 passageiros com idade conhecida.
Simulador: a unidade decide os vizinhos
Preveja. Deslize a unidade da renda de milhares para centavos. Os 5 vizinhos mais próximos do ponto vermelho continuam os mesmos? Depois aperte padronizar.
Qual coluna manda na distância?
Para duas linhas sorteadas, a diferença ao quadrado esperada numa coluna é o dobro da variância dela: a fatia de cada coluna na distância é a fatia dela na variância total. Titanic, quatro colunas numéricas:
| coluna | bruta | padronizada | |
|---|---|---|---|
Fare | 92,9% | 25% | |
Age | 7,0% | 25% | |
SibSp | 0,0% | 25% | |
Parch | 0,0% | 25% |
Quais modelos se importam com a escala
se importam
- baseados em distância: k-NN, k-means, SVMs (máquinas de vetores de suporte) com kernel
- baseados em variância: a PCA (análise de componentes principais); o atributo de maior escala vence por padrão
- treinados por gradiente e penalizados: regressão linear e logística, redes neurais, Ridge/Lasso
não se importam
Árvores, florestas aleatórias, gradient boosting: cortam um atributo de cada vez ("Age < 12?").
Qualquer transformação crescente move o limiar, mas manda as mesmas linhas para cada lado.
Quatro escalonadores: \(x' = (x - \text{centro}) / \text{espalhamento}\)
| escalonador | fórmula | centro | espalhamento | resultado |
|---|---|---|---|---|
StandardScaler | \((x - \mu) / \sigma\) | média | desvio padrão | média 0, desvio 1 |
MinMaxScaler | \((x - x_{\min}) / (x_{\max} - x_{\min})\) | mínimo | amplitude | valores em \([0, 1]\) |
RobustScaler | \((x - \text{mediana}) / \text{IQR}\) | mediana | IQR \(= Q_3 - Q_1\) | mediana 0, IQR 1 |
MaxAbsScaler | \(x / \max \lvert x \rvert\) | nenhum (0 continua 0) | maior \(\lvert x \rvert\) | valores em \([-1, 1]\) |
Quatro escalonadores, passo a passo
Cinco rendas familiares, em milhares de R$: 1, 2, 3, 4 e 40. Preveja. Qual escalonador vai manter as quatro famílias comuns mais espalhadas e qual vai espremê-las?
Mesma geometria, peso diferente ao lado das outras colunas
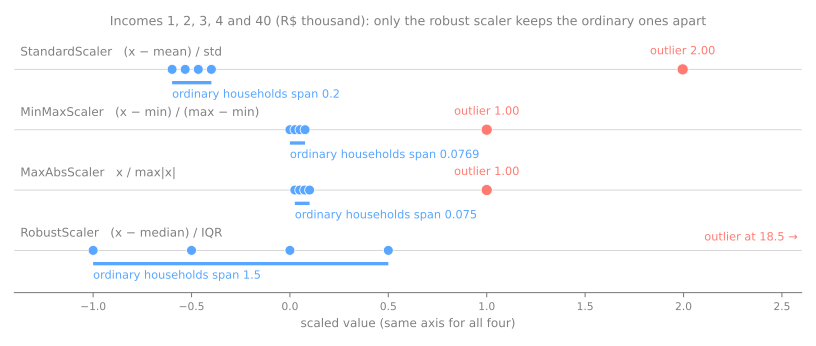
Dentro da coluna, as famílias comuns sempre ocupam os mesmos 8% da amplitude: uma transformação linear não muda proporções. O que muda é o tamanho das diferenças entre elas comparado com as outras colunas; é isso que uma distância soma.
MinMaxScaler, ao lado de uma coluna de idade com desvio 1, duas famílias comuns parecem quase idênticas em renda e a idade decide tudo.Escolhendo um escalonador
| escalonador | efeito dos outliers | uso típico |
|---|---|---|
StandardScaler | moderado: eles inflam \(\sigma\) | o padrão: modelos lineares, SVM, PCA, redes neurais |
MinMaxScaler | forte: um valor extremo comprime todo o resto | quando é preciso um intervalo fixo (pixels) |
RobustScaler | fraco: eles apenas ficam longe | colunas com outliers que você decidiu manter |
MaxAbsScaler | forte, como o min-max | dados esparsos: zeros continuam zeros |
- Normalização é ambíguo (min-max? "deixar com cara de normal"? o
Normalizerdo scikit-learn reescala cada linha). Escreva a fórmula. - Um valor novo fora da amplitude do treino sai do intervalo: uma renda de 80 vira \((80-1)/39 = 2{,}03\) no min-max.
Ajuste no treino, transforme todo o resto
Uma média ou um desvio padrão é parâmetro do modelo tanto quanto um peso.
fit
aprende as estatísticas e as guarda (mean_, scale_)
transform
aplica as estatísticas guardadas, congeladas
fit_transform
os dois, nos mesmos dados
fit uma vez, nas linhas de treino. Validação, teste e produção só veem transform. A mesma regra vale para toda etapa desta aula: escalonadores, codificadores, imputadores.Quatro jeitos de chamar o escalonador, passo a passo
Idades de treino 20, 25, 30, 35, 40; passageiros novos de 60 e 70 anos. Preveja. Se alguém chamar StandardScaler().fit_transform(test) nas duas linhas novas, que valores recebem 60 e 70?
Atributos assimétricos: o escalonador não muda a forma
Tarifas do Titanic: metade custou menos de £14,46, três custaram £512 e 15 bilhetes foram gratuitos. Assimetria \(= \frac{1}{n}\sum z_i^3\), a média dos z-scores ao cubo dos \(n\) valores: 0 se simétrica, positiva com cauda longa à direita.
StandardScaler?| tarifa | assimetria |
|---|---|
| bruta | 4,79 |
| padronizada | 4,79 |
| raiz quadrada | 2,09 |
\(\log(1 + x)\), np.log1p | 0,39 |
É preciso uma transformação não linear. O log transforma multiplicações em somas (£8 → £80 e £50 → £500 viram passos iguais); log1p porque \(\log 0 = -\infty\). Ordem: forma, depois escala; confira a assimetria depois.
Codificação: três tipos de categoria
nominal
sem ordem: porto, cor, cidade
→ one-hot
ordinal
com ordem real: classe do bilhete, escolaridade, tamanho P < M < G
→ inteiros nessa ordem
binária
duas categorias: Sex
→ uma coluna 0/1
O atalho tentador: o OrdinalEncoder numera os portos em ordem alfabética, Cherbourg = 0, Queenstown = 1, Southampton = 2.
Códigos ou one-hot, linha a linha
Os três portos, codificados duas vezes. Preveja. Com códigos inteiros, que dois portos uma distância põe mais longe um do outro? E com one-hot?
Uma inclinação não cabe em dois degraus
sobrevivência por porto
| C (código 0) | 0,554 |
| Q (código 1) | 0,390 |
| S (código 2) | 0,337 |
Degraus de 16,4 e 5,3 pontos. Um modelo linear dá à coluna de códigos um único coeficiente; os dois degraus são obrigados a ser iguais.
o que fazer
O one-hot dá a cada porto o seu coeficiente; nenhum alfabeto decide a ordem.
Árvores são a exceção: cortes em 0,5 e 1,5 isolam cada código, então inteiros servem para elas.
Ordinal: você declara a ordem
OrdinalEncoder().fit(levels).categories_
# ['bachelor', 'high school', 'master']   ordem alfabética!
OrdinalEncoder(categories=[['high school', 'bachelor', 'master']])
# agora os códigos seguem a ordem real: 0, 1, 2
O alfabeto põe high school (ensino médio) entre bachelor (graduação) e master (mestrado).
Pclass já vem como 1, 2, 3. Ordinal (uma coluna) ou nominal (três colunas one-hot) é uma escolha de modelagem: a ordinal supõe que ir da 1ª para a 2ª importa tanto quanto ir da 2ª para a 3ª.One-hot: uma categoria que o treino nunca viu
Treinado nos portos S, C, S, Q, S, C. Chegam dois passageiros novos: um de Q, outro de Belfast (B).
| porto novo | Embarked_C | Embarked_Q | Embarked_S | padrão |
|---|---|---|---|---|
| Q | 0 | 1 | 0 | tudo certo |
| B | 0 | 0 | 0 | ValueError: a previsão cai |
handle_unknown='ignore', B vira 0 0 0, "nenhuma das categorias que conheço". É comum na prática: uma categoria rara pode simplesmente não cair na divisão de treino.Valores faltantes: por que falta?
| mecanismo | o que significa | exemplo no Titanic |
|---|---|---|
| MCAR, ausência completamente aleatória (missing completely at random) | não depende de nada | os 2 Embarked faltantes, plausivelmente |
| MAR, ausência aleatória condicional (missing at random) | depende de outras colunas observadas | Age, que falta mais na 3ª classe |
| MNAR, ausência não aleatória (missing not at random) | depende do próprio valor que falta | Cabin: sem cabine própria |
Age faltante, por classe
1ª 13,9% · 2ª 6,0% · 3ª 27,7%
sobrevivência
idade registrada 40,6% · idade faltante 29,4%
dropna() custaria 177 linhas (19,9%), concentradas na 3ª classe: os passageiros que mais morreram ficariam sub-representados.Imputação pela média, passo a passo
Seis valores, dois faltando: 2, 4, ?, 6, ?, 8. Preveja. Depois de preencher os dois buracos com a média, a variância sobe, fica em 5 ou cai?
Guarde o fato de que faltava
imp = SimpleImputer(strategy='median', add_indicator=True)
imp.get_feature_names_out()   # ['Age' 'missingindicator_Age']
# passageiro 1: [22, 0]    passageiro 6: [28, 1]
A idade faltante anda junto com menor sobrevivência (29,4% contra 40,6%). A flag custa uma coluna e deixa o modelo decidir se a ausência informa algo. Para categorias: uma categoria própria, 'unknown'.
Resumo
- Unidades brutas decidem distâncias por acidente: escalone o que distâncias, variâncias e penalidades usam.
- Escalonadores diferem no centro e no espalhamento; um outlier define a escala de todos menos o
RobustScaler. - Ajuste no treino, transforme todo o resto.
- Um escalonador não conserta a forma:
log1p, depois escala. - One-hot para nominais, ordem declarada para ordinais;
handle_unknown='ignore'. - Pergunte por que falta; preencher encolhe o espalhamento; guarde uma flag.
| sintoma | o que fazer |
|---|---|
| uma coluna decide todos os vizinhos | padronizar as colunas numéricas |
| colunas de teste escalonadas com média exatamente 0 | o escalonador viu o teste: ajustar só no treino |
Preparando o Titanic, coluna por coluna: passos 1 a 6
- Inventário, dividir primeiro (712 de treino, 179 de teste), por que falta
Age, imputá-la, one-hot deSex,EmbarkedePclass, escalonar os números. - Notebook do lab: abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook).
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: a lei do encolhimento, em buracos que você faz (passo 4) e de quem são os vizinhos? (passo 6).
Ritmo: passos 1 a 3 em 8 min; passo 4 e a primeira simulação em 10 min; passos 5 e 6 e a segunda em 12 min.