O algoritmo só enxerga números
Ele minimiza o custo com os números que você entregou. Se estiverem mal preparados, minimiza a coisa errada, com toda a convicção.
escalas incompatíveis
a coluna com os maiores números domina distâncias e penalidades
Fare vai de 0 a 512, SibSp de 0 a 8
texto
não existe aritmética com "female"
Sex, Embarked, Cabin, Ticket, Name
buracos
a maioria das implementações recusa NaN (not a number, o valor ausente)
Age falta em 19,9%, Cabin em 77,1%
O plano: escala → forma → codificação → imputação, cada uma medida num exemplo pequeno e depois no Titanic (891 passageiros da viagem de 1912). A EDA (Análise Exploratória de Dados) olhava a tabela; esta aula a muda.
O caminho desta aula
- Escalonara unidade decide a distância; quatro escalonadores
- Ajustar só no treinofit uma vez nas linhas de treino, transform no resto
- Corrigir a formalog, Box-Cox, Yeo-Johnson
- Codificar categoriasordinal, one-hot, target encoding
- Imputar faltantespor que falta; um valor, outras colunas, um indicador
Três passageiros, à mão
| passageiro | idade | tarifa | |
|---|---|---|---|
| A | Braund, Mr. Owen Harris (3ª classe) | 22,0 | £7,25 |
| B | Connors, Mr. Patrick | 70,5 | £7,75 |
| C | Pears, Mrs. Thomas (1ª classe) | 22,0 | £66,60 |
Em unidades brutas, o senhor de 70 anos ganha
| par | diferença de idade | diferença de tarifa | distância |
|---|---|---|---|
| A–B | 48,5 anos | £0,50 | \(\sqrt{48{,}5^2 + 0{,}5^2} = 48{,}50\) |
| A–C | 0 anos | £59,35 | \(\sqrt{0^2 + 59{,}35^2} = 59{,}35\) |
48,5 anos é um número menor que 59,35 libras. Nada diz que um ano e uma libra deveriam pesar o mesmo: é só o que acontece quando se subtraem números brutos.
Padronizado, a ordem se inverte
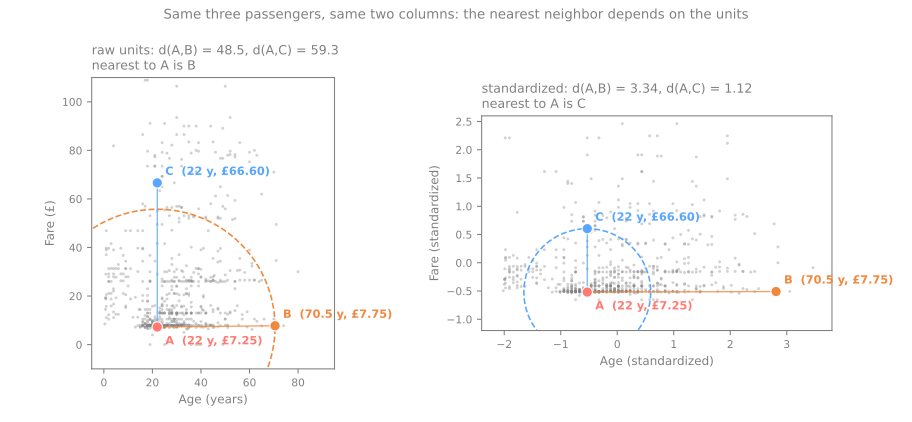
A–B: \(48{,}5 / 14{,}52 = \mathbf{3{,}34}\) desvios
A–C: \(59{,}35 / 52{,}88 = \mathbf{1{,}12}\) desvio
\(\mu\) e \(\sigma\) calculados sobre os 714 passageiros com idade conhecida.
Simulador: a unidade decide os vizinhos
Prever. Deslize a unidade da renda de milhares para centavos. Os 5 vizinhos mais próximos do ponto vermelho continuam os mesmos? Depois aperte padronizar.
Qual coluna manda na distância?
Para duas linhas sorteadas, a diferença ao quadrado esperada numa coluna é o dobro da variância dela: a fatia de cada coluna na distância é a fatia dela na variância total.
fatia da distância quadrática (bruta)
Fare | 92,9% |
Age | 7,0% |
SibSp, Parch | 0,0% |
Um k-NN (k vizinhos mais próximos) nas colunas brutas é, na prática, um k-NN na tarifa. Padronizado: 25% cada.
um olhar adiante: gradiente descendente
Com perda quadrática, a curvatura em cada direção é dada pela variância dos atributos. Idade e tarifa:
| bruta | 208,62; 2798,59 | razão 13,4 |
| padronizada | 0,9; 1,1 | razão 1,2 |
Um vale comprido e estreito: uma taxa segura na direção íngreme se arrasta na direção plana.
Quais modelos se importam com a escala
se importam
- baseados em distância: k-NN, k-means, SVMs (máquinas de vetores de suporte) com kernel
- baseados em variância: a PCA (análise de componentes principais); o atributo de maior escala vence por padrão
- treinados por gradiente e penalizados: regressão linear e logística, redes neurais, Ridge/Lasso
não se importam
Árvores, florestas aleatórias, gradient boosting: cortam um atributo de cada vez ("Age < 12?").
Qualquer transformação crescente move o limiar, mas manda as mesmas linhas para cada lado.
Quatro escalonadores: \(x' = (x - \text{centro}) / \text{espalhamento}\)
| escalonador | fórmula | centro | espalhamento | resultado |
|---|---|---|---|---|
StandardScaler | \((x - \mu) / \sigma\) | média | desvio padrão | média 0, desvio 1 |
MinMaxScaler | \((x - x_{\min}) / (x_{\max} - x_{\min})\) | mínimo | amplitude | valores em \([0, 1]\) |
RobustScaler | \((x - \text{mediana}) / \text{IQR}\) | mediana | IQR \(= Q_3 - Q_1\) | mediana 0, IQR 1 |
MaxAbsScaler | \(x / \max \lvert x \rvert\) | nenhum (0 continua 0) | maior \(\lvert x \rvert\) | valores em \([-1, 1]\) |
À mão: uma coluna com um outlier
Cinco famílias, renda mensal em milhares de reais: 1, 2, 3, 4 e 40.
- média \(\mu = 10\); \(\sigma = \sqrt{(81+64+49+36+900)/5} = \sqrt{226} = 15{,}03\) (o scikit-learn divide por \(n\))
- mínimo 1, máximo 40, amplitude 39
- mediana 3; \(Q_1 = 2\), \(Q_3 = 4\), logo IQR = 2
Primeira família (renda 1): padrão \((1-10)/15{,}03 = -0{,}599\) · min-max \(0\) · robusto \((1-3)/2 = -1\) · max-abs \(1/40 = 0{,}025\)
Quem define a escala é o outlier
| bruto | Standard | MinMax | Robust | MaxAbs |
|---|---|---|---|---|
| 1 | −0,599 | 0,000 | −1,0 | 0,025 |
| 2 | −0,532 | 0,026 | −0,5 | 0,050 |
| 3 | −0,466 | 0,051 | 0,0 | 0,075 |
| 4 | −0,399 | 0,077 | 0,5 | 0,100 |
| 40 | 1,996 | 1,000 | 18,5 | 1,000 |
Largura das quatro famílias comuns:
- Standard: 0,2 (o outlier infla \(\sigma\): 15,03 contra 1,12 sem ele)
- MinMax, MaxAbs: < 0,08 (o outlier é o máximo)
- Robust: 1,5; o outlier fica longe, em 18,5
As estatísticas aprendidas ficam em atributos cujo nome termina em sublinhado: mean_, scale_, center_.
Mesma geometria, peso diferente ao lado das outras colunas
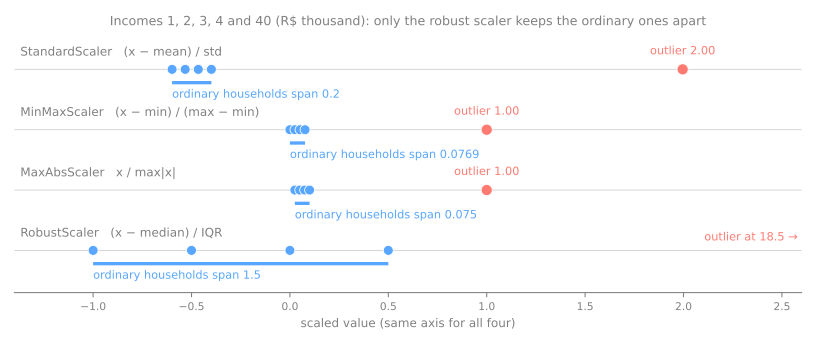
Dentro da coluna, as famílias comuns sempre ocupam os mesmos 8% da amplitude: uma transformação linear não muda proporções. O que muda é o tamanho das diferenças entre elas comparado com as outras colunas; é isso que uma distância soma.
MinMaxScaler, ao lado de uma coluna de idade com desvio 1, duas famílias comuns parecem quase idênticas em renda e a idade decide tudo.Escolhendo um escalonador
| escalonador | efeito dos outliers | uso típico |
|---|---|---|
StandardScaler | moderado: eles inflam \(\sigma\) | o padrão: modelos lineares, SVM, PCA, redes neurais |
MinMaxScaler | forte: um valor extremo comprime todo o resto | quando é preciso um intervalo fixo (pixels) |
RobustScaler | fraco: eles apenas ficam longe | colunas com outliers que você decidiu manter |
MaxAbsScaler | forte, como o min-max | dados esparsos: zeros continuam zeros |
- Normalização é ambíguo (min-max? "deixar com cara de normal"? o
Normalizerdo scikit-learn reescala cada linha). Escreva a fórmula. - Um valor novo fora da amplitude do treino sai do intervalo: uma renda de 80 vira \((80-1)/39 = 2{,}03\) no min-max.
Ajuste no treino, transforme todo o resto
Uma média ou um desvio padrão é parâmetro do modelo tanto quanto um peso. fit aprende e guarda, transform aplica e fit_transform faz os dois nos mesmos dados.
idades de treino
20, 25, 30, 35, 40
média 30, desvio 7,07
passageiros novos
60 e 70
StandardScaler().fit_transform(test) nas duas linhas novas. Que valores recebem 60 e 70?Quatro situações
| o que o código faz | 60 e 70 viram | o que deu errado |
|---|---|---|
certo: transform(test) | \((60-30)/7{,}07 = 4{,}24\); 5,66 | nada: "muito mais velho que qualquer um do treino" |
| reajustar nas 2 linhas de teste | −1, +1 (média 65, espalhamento 5) | −1 significava 22,9 anos: o de 60 virou alguém de 23 |
| reajustar numa única linha | 0 | todo passageiro vira "perfeitamente médio" |
| ajustar antes da divisão | aprende média 40, desvio 17,11 | ele vaza: a avaliação fica otimista |
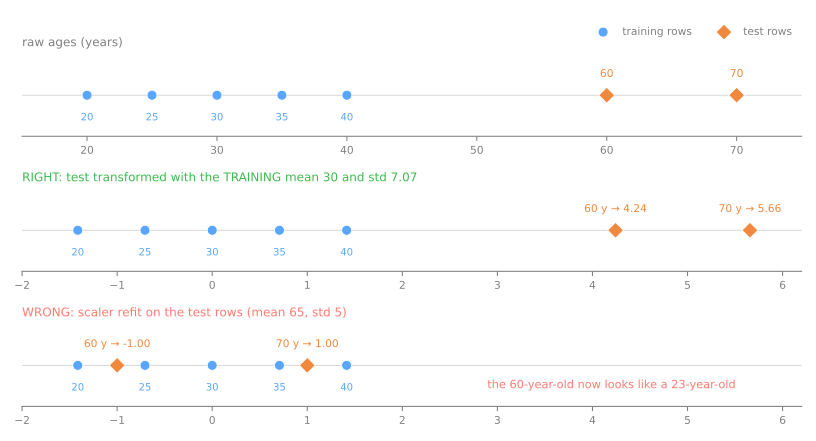
fit uma vez, nas linhas de treino. Validação, teste e produção só veem transform.Atributos assimétricos: o escalonador não muda a forma
Tarifas do Titanic: metade custou menos de £14,46, três custaram £512 e 15 bilhetes foram gratuitos. Assimetria \(= \frac{1}{n}\sum z_i^3\): 0 se simétrica, positiva com cauda longa à direita.
StandardScaler?| tarifa | assimetria |
|---|---|
| bruta | 4,79 |
| padronizada | 4,79 |
| raiz quadrada | 2,09 |
\(\log(1 + x)\), np.log1p | 0,39 |
É preciso uma transformação não linear. O log transforma multiplicações em somas (£8 → £80 e £50 → £500 viram passos iguais); log1p porque \(\log 0 = -\infty\).
Deixe os dados escolherem a potência
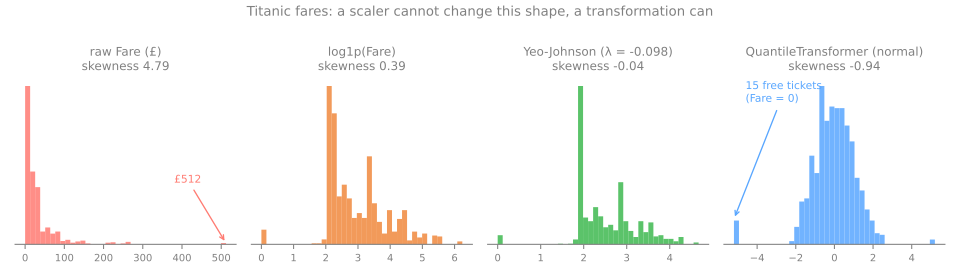
Box-Cox
\(x' = (x^\lambda - 1)/\lambda\), com \(\lambda = 0\) significando \(\log x\); \(\lambda\) por máxima verossimilhança. Exige \(x > 0\): recusa os bilhetes gratuitos.
Yeo-Johnson
aceita zero e negativos. \(\lambda = -0{,}098\), perto de um log → assimetria −0,04.
QuantileTransformer
troca cada valor pelo seu posto → −0,94; os 15 bilhetes gratuitos se empilham em −5,20.
Codificação: três tipos de categoria
nominal
sem ordem: porto, cor, cidade
→ one-hot
ordinal
com ordem real: classe do bilhete, escolaridade, tamanho P < M < G
→ inteiros nessa ordem
binária
duas categorias: Sex
→ uma coluna 0/1
OrdinalEncoder numera os portos em ordem alfabética: Cherbourg = 0, Queenstown = 1, Southampton = 2. Em que uma distância passa a acreditar?Códigos inteiros inventam distâncias
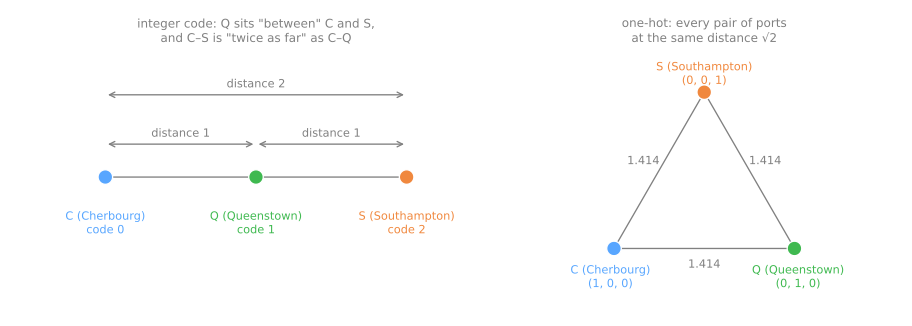
Códigos: Q fica "entre" C e S; C–S fica "duas vezes mais longe" que C–Q. One-hot: todo par a \(\sqrt{1^2+1^2} = 1{,}414\).
Sobrevivência por porto: C 0,554, Q 0,390, S 0,337. Degraus de 16,4 e 5,3 pontos: uma única inclinação sobre os códigos não representa os dois.
Ordinal: você declara a ordem
OrdinalEncoder().fit(levels).categories_
# ['bachelor', 'high school', 'master']   ordem alfabética!
OrdinalEncoder(categories=[['high school', 'bachelor', 'master']])
# agora os códigos seguem a ordem real: 0, 1, 2
O alfabeto põe high school (ensino médio) entre bachelor (graduação) e master (mestrado).
Pclass já vem como 1, 2, 3. Ordinal (uma coluna) ou nominal (três colunas one-hot) é uma escolha de modelagem: a ordinal supõe que ir da 1ª para a 2ª importa tanto quanto ir da 2ª para a 3ª.One-hot: duas opções práticas
categorias inéditas
Treinado em S, C, Q; chega um passageiro que embarcou em Belfast (B).
Padrão: ValueError, a previsão cai.
handle_unknown='ignore': B vira 0 0 0, "nenhuma das categorias que conheço".
drop='first'
C + Q + S = 1 em toda linha: é a coluna do intercepto. Posto 3 para 4 colunas, então os pesos não são únicos.
Descartar C (a referência) restaura o posto completo.
drop='first' para modelos lineares com intercepto e sem penalidade. Mantenha todas as colunas para árvores, k-NN e modelos regularizados.Alta cardinalidade e target encoding
Ticket tem 681 valores distintos para 891 linhas: o one-hot criaria 681 colunas quase só de zeros, sobreajuste garantido.
- Primeiro procure a estrutura escondida: a letra do deck em
Cabin, o título emName(Mr, Miss, Mrs, Master...). - Depois agrupe os níveis raros:
min_frequency=10mantém 4 títulos e junta os outros 13. - Target encoding: trocar cada categoria pela média do alvo naquela categoria. Uma coluna só, qualquer que seja a cardinalidade.
O target encoding vaza
| codificação de puro ruído | treino | teste |
|---|---|---|
| média ingênua por categoria | 0,775 | 0,505 |
TargetEncoder (com cross-fitting) | 0,496 | 0,505 |
- A maioria dos bilhetes aparece uma ou duas vezes, então o valor codificado de uma linha é, em boa parte, o próprio rótulo dela: o modelo aprende a ler a resposta, não a prevê-la.
- Cross-fitting: o
fit_transformcodifica cada fold com médias dos outros folds, de modo que nenhuma linha vê o próprio rótulo; as categorias raras são puxadas para a média global.
fit_transform no treino, transform no teste. Opções sem o alvo: codificação por frequência, hashing.Valores faltantes: por que falta?
| mecanismo | o que significa | exemplo no Titanic |
|---|---|---|
| MCAR, ausência completamente aleatória | não depende de nada | os 2 Embarked faltantes, plausivelmente |
| MAR, ausência aleatória condicional | depende de outras colunas observadas | Age, que falta mais na 3ª classe |
| MNAR, ausência não aleatória | depende do próprio valor que falta | Cabin: sem cabine própria |
Age faltante, por classe
1ª 13,9% · 2ª 6,0% · 3ª 27,7%
sobrevivência
idade registrada 40,6% · idade faltante 29,4%
dropna() custaria 177 linhas (19,9%), concentradas na 3ª classe: os passageiros que mais morreram ficariam sub-representados.Preencher com um único valor encolhe a variância
Seis valores, dois faltando: 2, 4, ?, 6, ?, 8. Média observada 5, variância \((9+1+1+9)/4 = 5\).
Os 5 imputados não somam nada aos desvios ao quadrado, mas somam à contagem: \(20/6 = 3{,}33\), a variância antiga vezes \(4/6\), a fração de valores observados.
idades do Titanic
desvio 14,53 → 13,00, exatamente o previsto \(\times\sqrt{713/890}\)
o custo
177 passageiros dividem uma mesma idade inventada, 29,7
Imputar a partir das outras colunas
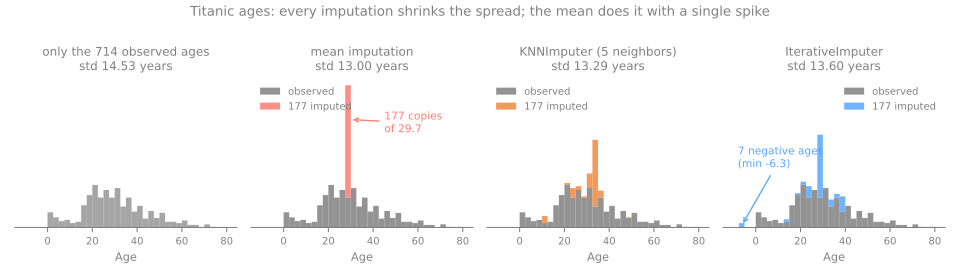
KNNImputer
média das \(k\) linhas mais parecidas (precisa de escalas comparáveis). Mr. James Moran, tarifa £8,46, sem idade: tarifas mais próximas £7,925 (26 anos) e £7,25 (22) → 24. A média diz 30,25.
IterativeImputer
uma regressão de cada coluna sobre as outras, em ciclos (MICE, imputação por equações encadeadas). Produziu 7 idades negativas: não sabe que idade é positiva.
Guarde o fato de que faltava
imp = SimpleImputer(strategy='median', add_indicator=True)
imp.get_feature_names_out()   # ['Age' 'missingindicator_Age']
# passageiro 1: [22, 0]    passageiro 6: [28, 1]
A idade faltante anda junto com menor sobrevivência (29,4% contra 40,6%). A flag custa uma coluna e deixa o modelo decidir se a ausência informa algo. Para categorias: uma categoria própria, 'unknown'.
O mapa do pré-processamento
Por coluna: ausentes → forma → escala, toda etapa ajustada nas linhas de treino. Clique nas respostas para montar a receita.
Quais famílias se importam com qual etapa
| família de modelos | escala | forma | codificação | valores faltantes |
|---|---|---|---|---|
| k-NN, k-means, SVM, PCA | obrigatória | ajuda | one-hot | precisam ser imputados |
| regressão linear/logística, redes neurais | obrigatória | ajuda | one-hot, drop='first' sem penalidade | precisam ser imputados |
| árvores, florestas aleatórias, gradient boosting | desnecessária | desnecessária | códigos ordinais servem | as árvores do scikit-learn aceitam NaN |
Lab: preparando o Titanic para um modelo
- Inventário:
Survivedé o alvo,PassengerIdsai,Pclassé uma categoria guardada como número. - Dividir primeiro: 712 de treino, 179 de teste, estratificado.
- Imputar
Age(mediana), codificarSex,Embarked,Pclass(one-hot), escalonar os números. - Tudo num único
ColumnTransformer: 12 colunas, nenhumNaN, nenhum texto.
Notebook do lab (Jupyter ou Colab, Arquivo → Fazer upload de notebook).
Mesmo modelo, mesmos dados, outro escalonador
| colunas numéricas | acurácia de teste |
|---|---|
| baseline (sempre "não sobreviveu") | 0,615 |
| k-NN, sem escalonamento | 0,676 |
k-NN, StandardScaler | 0,821 |
k-NN, MinMaxScaler | 0,804 |
k-NN, RobustScaler | 0,771 |
Sem escalonamento, os vizinhos são escolhidos quase só pela tarifa (93,1% da distância).
179 passageiros de teste: cada um vale 0,56 ponto, então o ranking entre escalonadores não é confiável.
Resumo
- Unidades brutas decidem distâncias por acidente: escalone o que distâncias, variâncias e gradientes usam.
- Escalonadores diferem no centro e no espalhamento; outliers definem a escala, menos no
RobustScaler. - Um escalonador não conserta a forma: log1p, Yeo-Johnson, depois escala.
- One-hot para nominais, ordem declarada para ordinais; target encoding só com cross-fitting.
- Pergunte por que falta; a imputação encolhe o espalhamento; guarde uma flag.
- Ajuste no treino, transforme todo o resto.