O ponto de partida: árvores são instáveis
- Na aula de árvores de decisão, árvores reajustadas em reamostras dos mesmos e-mails começavam por perguntas diferentes.
- Acurácias parecidas, mas duas árvores discordavam em 11,8% dos e-mails.
- E o voto de 50 delas acertou 0,950, mais que a melhor árvore (0,919).
A ideia de Breiman (bagging, 1996; random forests, 2001): não combater a variância de uma árvore, mas tirar a média de muitas árvores diferentes e deixar os erros se cancelarem.
O caminho desta parte
- Por que a média funcionaa variância de uma média e seu piso ρσ²
- Bootstrap e baggingreamostrar, crescer árvores fundas, votar
- Descorrelacionar as árvoressortear
max_featurescandidatos a cada divisão - Validar out-of-bago erro out-of-bag (OOB); quantas árvores
Cada etapa responde a uma pergunta: por que a média erra menos que seus membros? → de onde vêm muitas árvores diferentes? → como deixar as árvores menos parecidas? → como avaliar sem um conjunto de validação?
Etapa 1 · por que a média erra menos que seus membros?
Por que a média funciona — e onde para
\[ \operatorname{Var}\Big(\frac{1}{n}\sum_{i=1}^n X_i\Big) = \rho\,\sigma^2 + \frac{1-\rho}{n}\,\sigma^2 \]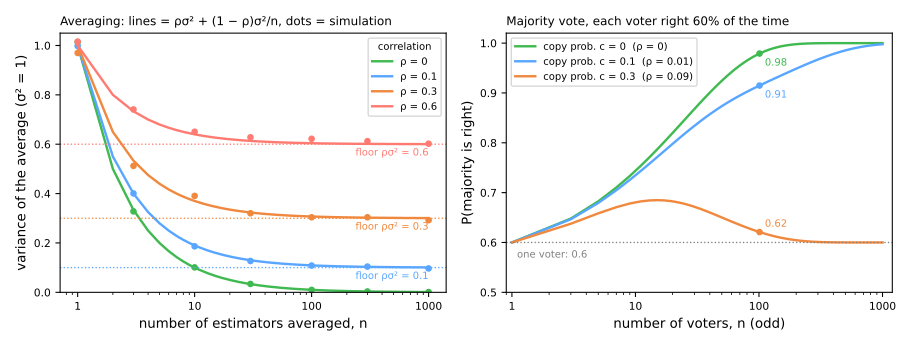
- O segundo termo some com \(n\) grande.
- O primeiro, \(\rho\sigma^2\), não depende de \(n\): é o erro que todos compartilham.
- Com \(\rho = 0{,}3\): 10 membros levam a variância de 1 para 0,37; 100, só até 0,31.
Uma floresta precisa de membros razoáveis (\(\sigma^2\) pequeno) e pouco correlacionados (\(\rho\) pequeno).
Etapa 2 · de onde vêm muitas árvores diferentes?
O bootstrap: muitos conjuntos de treino a partir de um
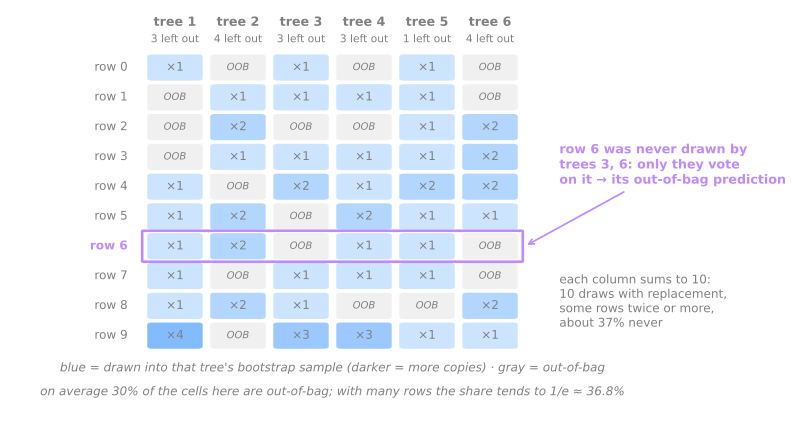
- Sorteie \(n\) linhas com reposição: algumas entram várias vezes, outras nenhuma.
- Cada linha fica de fora com probabilidade \((1 - 1/n)^n \to 1/e \approx 36{,}8\%\).
Bagging: bootstrap aggregating
Cresça \(B\) árvores (cada uma na sua própria amostra bootstrap, em geral até a profundidade máxima) e faça a média das previsões (regressão) ou deixe-as votar (classificação).
Bagging: viés baixo, metade da variância
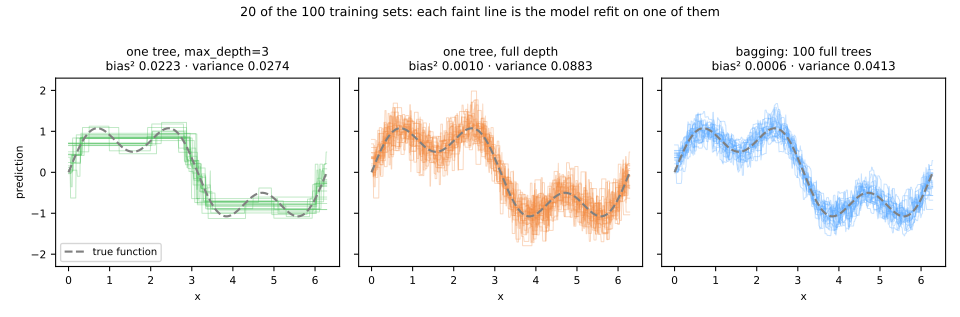
| viés² | variância | |
|---|---|---|
| árvore, prof. 3 | 0,0223 | 0,0274 |
| árvore completa | 0,0010 | 0,0883 |
| bagging, 100 | 0,0006 | 0,0413 |
Podar troca variância por viés. O bagging recusa a troca: mantém o viés da árvore completa e corta a variância pela metade.
O voto suaviza a fronteira
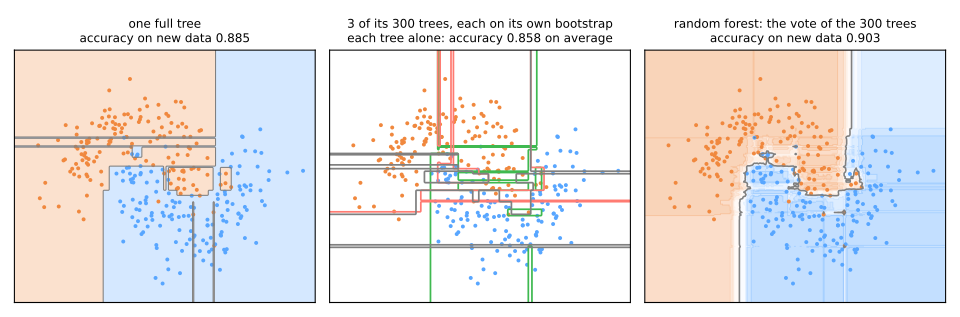
Cada árvore da floresta é pior que a árvore única (0,858 contra 0,885), mas o voto acerta 0,903: as ilhas de cada árvore ficam em lugares diferentes e perdem no voto.
Simulador: por que a média de árvores funciona
Preveja. Leve as árvores de 1 a 60. As árvores individuais (esquerda) melhoram? O erro do voto continua caindo?
O que a média não faz
- Não melhora as árvores: cada uma continua tão trêmula quanto a primeira; o que melhora é a média.
- Não remove viés: a média de árvores rasas continua rasa.
- Não remove a variância compartilhada \(\rho\sigma^2\): passado um ponto, mais árvores não acrescentam nada.
n_estimators é uma questão de orçamento, não de ajuste: mais nunca é pior, só mais lento.Etapa 3 · como deixar as árvores menos parecidas?
Random forest: sortear os candidatos de cada divisão
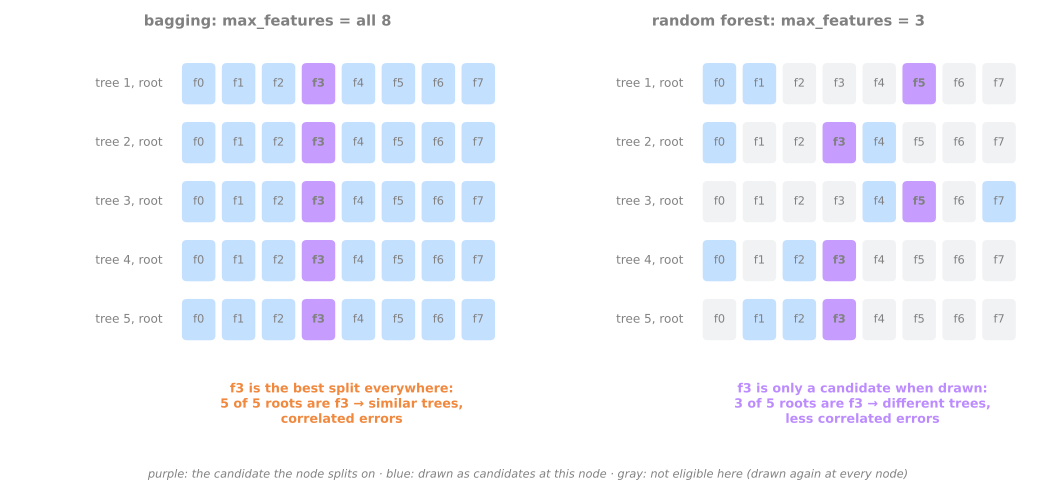
Em cada divisão, só max_features atributos sorteados são elegíveis. Árvores mais fracas, mas menos parecidas.
Força contra correlação, nos dígitos
| max_features | mesma raiz | correlação | erro de 1 árvore | erro da floresta |
|---|---|---|---|---|
| 64 (bagging) | 66% | 0,304 | 0,195 | 0,053 |
| 20 | 24% | 0,233 | 0,215 | 0,027 |
| 8 = \(\sqrt{64}\) | 10% | 0,198 | 0,249 | 0,023 |
| 1 | 4% | 0,133 | 0,375 | 0,030 |
Árvores piores, floresta mais de duas vezes melhor: \(\rho\) menor compensa \(\sigma^2\) maior. Com 1 atributo as árvores ficam fracas demais. Padrão: \(\sqrt{d}\) na classificação.
Etapa 4 · como avaliar sem um conjunto de validação?
Out-of-bag: validação de graça
- Cada árvore não viu ~37% das linhas. Para cada linha, só as árvores que não a viram votam.
- Contando os erros em todas as linhas: o erro OOB, sem nenhum ajuste extra.
| dígitos, 500 árvores | acurácia | custo |
|---|---|---|
| out-of-bag | 0,975 | 1 ajuste |
| CV 5-fold | 0,977 ± 0,007 | 5 ajustes |
| teste (450 imagens) | 0,976 | — |
Para comparar com outros modelos, que não têm OOB, use a mesma CV para todos.
Quantas árvores?
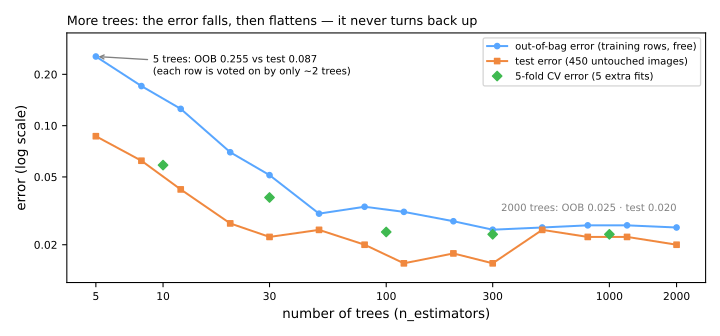
O erro cai, estaciona e nunca volta a subir. Só leia o OOB com algumas dezenas de árvores: com 5, cada linha tem uns 2 votos e o erro OOB (0,255) é muito pior que o de teste (0,087).
Resumo
- A média corta variância até o piso \(\rho\sigma^2\).
- O bootstrap dá a cada árvore uma amostra diferente; ~37% das linhas ficam de fora.
- Bagging: árvores fundas em amostras bootstrap, com média — viés baixo, variância cortada.
max_features: árvores piores, menos correlacionadas, floresta melhor.- OOB: validação de graça; mais árvores nunca pioram, só custam tempo.
| sintoma | o que fazer |
|---|---|
| curva OOB estacionou | parar de acrescentar árvores |
| estacionou alto demais | árvores mais fundas, outro max_features, atributos melhores |
Lab fundamental · cerca de 40 min, em duplas
Um filtro de spam: da árvore à floresta, passos 1 a 7
- Spambase: 4.601 e-mails, 57 frequências de palavras e caracteres.
- Uma árvore, bagging, random forest e Extra-Trees nos mesmos folds; o OOB contra a CV; quantas árvores.
- Notebook no Colab: nada para baixar. Salve uma cópia no seu Drive.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: a floresta é melhor que as próprias árvores? (passo 4) e árvores rasas, quantas forem (passo 7).
Ritmo: passos 1 a 3 em 10 min; passos 4 e 5 e a primeira simulação em 15 min; passos 6 e 7 e a segunda em 15 min.