O caminho desta parte
- O que dá errado2% de fraude: acurácia alta, recall baixo; o problema é o modelo ou o limiar?
- Três remédiospesos de classe, limiar deslocado, reamostragem e SMOTE (Synthetic Minority Over-sampling Technique)
- Lado a ladocinco abordagens na mesma divisão, uma curva só
- Duas armadilhasreamostrar antes da divisão; probabilidades distorcidas
O que dá errado
Triagem de fraude simulada: 20.000 transações, cerca de 2% fraudulentas, divisão estratificada.
| valor | |
|---|---|
| acurácia do dummy que nunca sinaliza | 0,9805 |
| acurácia do modelo | 0,9838 |
| transações sinalizadas em 0,5 | 23 de 4.000 (78 fraudes reais) |
| recall | 0,231 |
| ROC AUC (área sob a curva ROC) | 0,930 |
O diagnóstico importa
- A transação mediana recebe probabilidade 0,003; 60 das 78 fraudes ficam abaixo de 0,5.
- Isso é honesto: com taxa base de 2%, mesmo uma transação suspeita costuma ser mais provavelmente legítima do que não.
Cada remédio age numa parte diferente — alguns mudam o ponto de operação, outros a ordenação — e é fácil confundi-los.
Três lugares para intervir
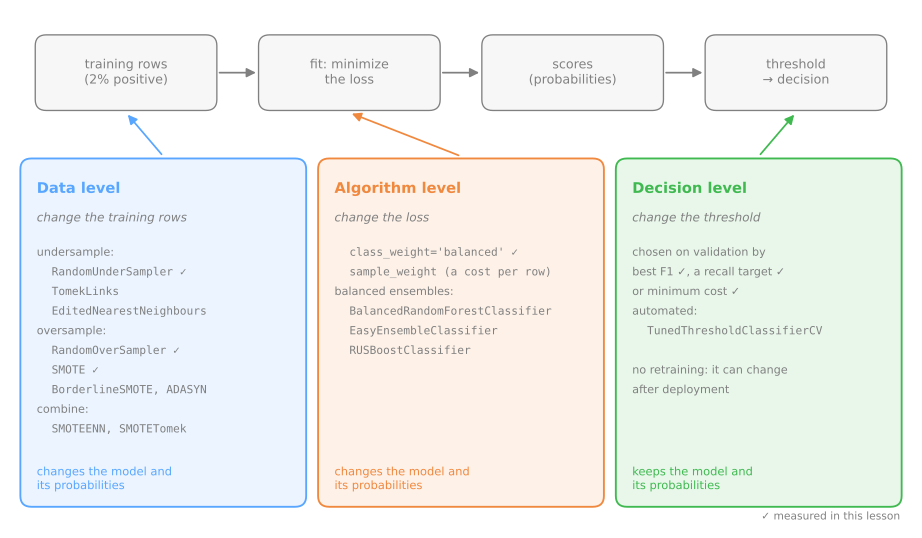
Os dois primeiros níveis mudam o modelo e suas probabilidades; o terceiro só muda a decisão. ✓ = medido nesta aula.
Remédio 1: pesos de classe
\[ w_c = \frac{n}{k \cdot n_c} \qquad w_0 = \frac{12000}{2 \times 11767} = 0{,}510 \qquad w_1 = \frac{12000}{2 \times 233} = 25{,}751 \]| AUC | AP | sinalizadas | recall | precisão | |
|---|---|---|---|---|---|
| sem pesos | 0,930 | 0,459 | 23 | 0,231 | 0,783 |
| balanced | 0,929 | 0,460 | 673 | 0,821 | 0,095 |
\(n\) linhas, \(k = 2\) classes, \(n_c\) linhas da classe \(c\). AP = precisão média (average precision), o resumo da curva precisão–recall.
O que os pesos fizeram com os escores
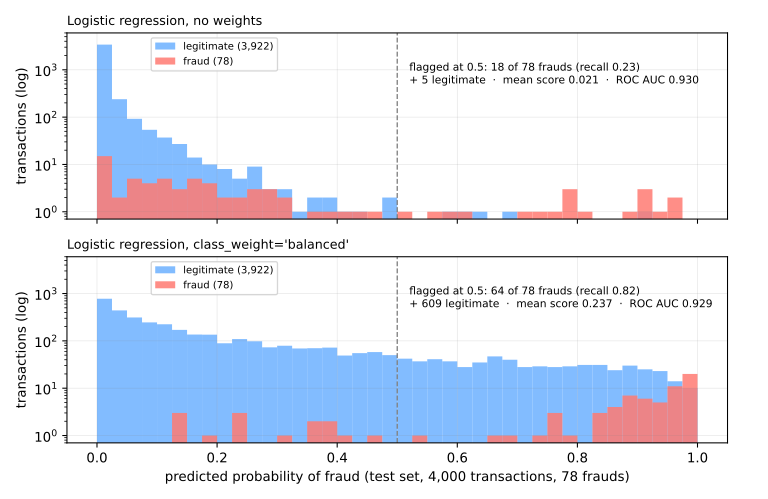
Mesmo modelo, mesma separação: todos os escores apenas se deslocaram para a direita.
class_weight='balanced' é, na prática, um limiar deslocado.Remédio 2: mover o limiar
Se os pesos deslocam o intercepto, dá para deslocar o limiar diretamente e não retreinar nada:
| sinalizadas | recall | precisão | |
|---|---|---|---|
| sem pesos, \(t = 0{,}0194\) (prevalência do treino) | 685 | 0,833 | 0,095 |
| balanced, \(t = 0{,}5\) | 673 | 0,821 | 0,095 |
Remédio 3: reamostragem
- Subamostragem: descarta linhas da maioria. Rápida, joga informação fora (11.534 de 11.767).
- Sobreamostragem: duplica a minoria. Cada fraude se repete ~50 vezes; modelos flexíveis decoram as cópias.
- SMOTE: cria pontos novos entre um ponto da minoria e um de seus vizinhos da minoria.
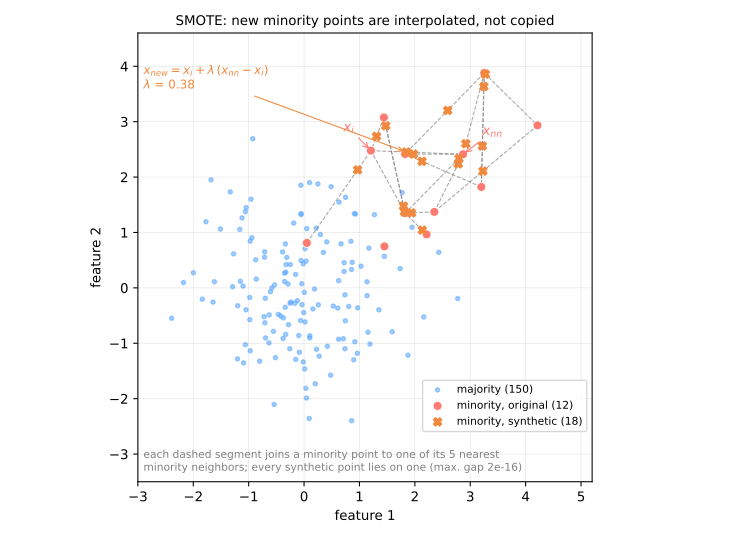
imblearn.pipeline, que pula o amostrador no predict.As cinco abordagens, lado a lado
| modelo | AUC | AP | R@0,5 | F1@0,5 | F1 ajustado | \(t\) |
|---|---|---|---|---|---|---|
| sem pesos | 0,930 | 0,459 | 0,231 | 0,356 | 0,449 | 0,22 |
| pesos balanced | 0,929 | 0,460 | 0,821 | 0,170 | 0,439 | 0,91 |
| subamostragem | 0,931 | 0,464 | 0,833 | 0,166 | 0,467 | 0,94 |
| sobreamostragem | 0,929 | 0,461 | 0,821 | 0,169 | 0,437 | 0,91 |
| SMOTE | 0,929 | 0,453 | 0,821 | 0,176 | 0,462 | 0,94 |
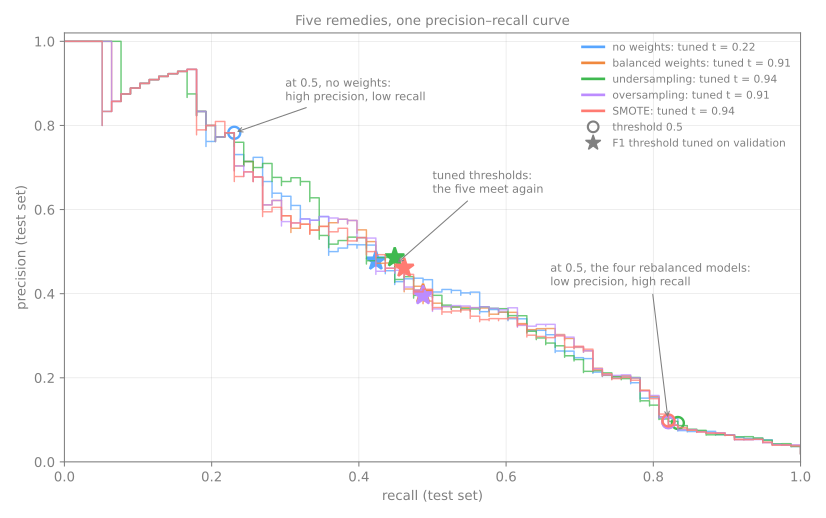
- Ordenação idêntica nas cinco: AUC 0,929–0,931, AP 0,453–0,464. Nenhum remédio ensinou algo novo sobre fraude.
- R = recall; F1 = média harmônica de precisão e recall.
- No limiar ajustado (o de melhor F1 na validação) as diferenças somem: F1 entre 0,44 e 0,47. Mesmo ponto de operação, números diferentes no mostrador.
Cinco remédios, uma curva
A ordem importa: dividir, depois reamostrar
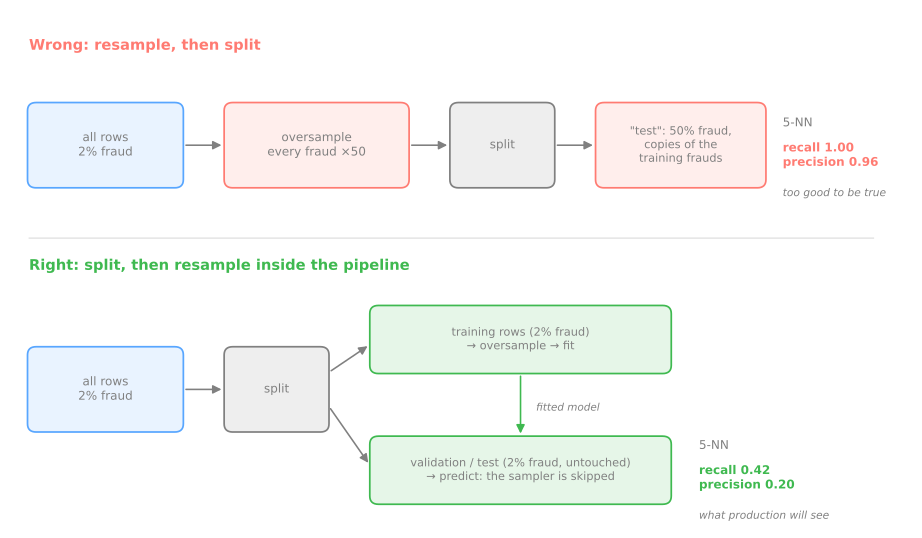
Armadilha 1: reamostrar antes de dividir
| amostrador + modelo | errado: R / P | certo: R / P |
|---|---|---|
| sobreamostragem + k-NN (5 vizinhos) | 1,00 / 0,96 | 0,42 / 0,20 |
| sobreamostragem + logística | 0,82 / 0,84 | 0,82 / 0,09 |
| SMOTE + k-NN | 1,00 / 0,92 | 0,56 / 0,12 |
- o teste está contaminado: cada fraude existe ~50 vezes, então quase toda fraude do "teste" tem cópias idênticas no treino; o k-NN as encontra;
- o teste não tem mais a prevalência real: 50% de fraudes em vez de 2%, então a precisão de 0,84 não diz nada sobre produção.
Armadilha 2: probabilidades distorcidas
| probabilidade média | |
|---|---|
| taxa real de fraude no teste | 0,0195 |
| modelo sem pesos | 0,0206 |
| pesos balanced | 0,2370 |
| SMOTE | 0,2227 |
| balanced, corrigido | 0,0208 |
Uma ordem sensata de ataque
Remédios, limiar e o único teste: passos 6 a 11
- Mesmo notebook do Colab, a partir do passo 6. Sessão nova? Ambiente de execução → Executar anteriores.
- A meta foi declarada no começo do lab fundamental: recall ≥ 0,80 nos casos malignos, com a melhor precisão.
- Simulações: o limiar que imita os pesos (passo 6) e comparar no limiar justo (passo 8).
- Passos 9 a 11: escolher modelo e limiar, o teste único e a escada grosseira de um k-NN.
Ritmo: passos 6 e 7 com a simulação em 15 min; passo 8 e a simulação em 10 min; passos 9 a 11 em 10 min.