O caminho desta parte
- O truque do kernelmapas de atributos, o kernel, RBF (função de base radial)
- Ajustar C e γdois botões acoplados; escalonar é obrigatório
- Ler a saídaescores, probabilidades, multiclasse
- Quando usarcusto de treino, o perfil prático
Um mapa de atributos torna os dados separáveis
Preveja. Doze pontos numa reta, os de fora \(+1\) e os de dentro \(-1\). Qual a melhor acurácia de um único limiar em \(x\)?
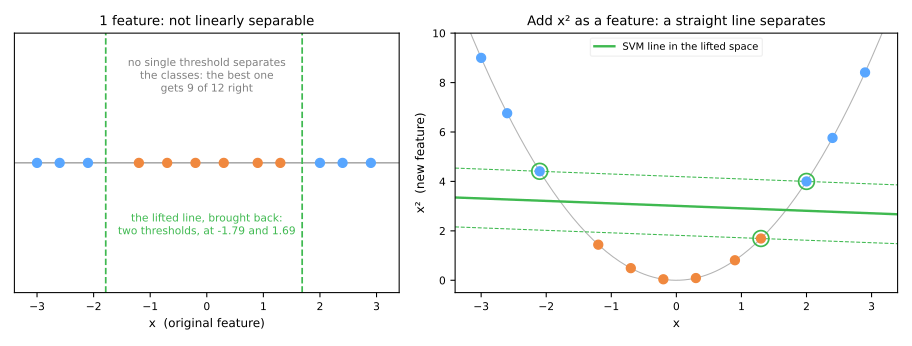
- Doze pontos numa reta, os de fora \(+1\): nenhum limiar em \(x\) passa de 0,75.
- Acrescente a coluna \(x^2\) e uma SVM linear simples acerta 1,00.
O kernel: um produto interno sem o mapa
O dual e a previsão tocam os dados só por produtos internos:
\[ f(x) = \sum_{i \in \text{SV}} \alpha_i y_i \, \langle x_i, x \rangle + b \qquad\Rightarrow\qquad K(u, v) = \langle \phi(u), \phi(v) \rangle \]SV: vetores de suporte; \(\alpha_i\): os seus pesos no dual; \(\phi\): o mapa de atributos; \(K\): o kernel.
Pelo mapa
\(\phi(v) = (v_1^2,\ \sqrt2 v_1 v_2,\ v_2^2)\), \(u = (1,2)\), \(v = (3,1)\):
\(\phi(u)\cdot\phi(v) = 9 + 12 + 4 = \mathbf{25}\)
Pelo kernel
\(u \cdot v = 5\), então \(K(u,v) = 5^2 = \mathbf{25}\)
Um produto escalar de 2 termos e um quadrado, por maior que seja o mapa.
| linear | \(u^\top v\) | melhor para dados esparsos de alta dimensão (texto) |
| polinomial | \((\gamma u^\top v + r)^p\) | \(p\): grau; \(r\) = coef0 (use 1 para incluir os graus menores) |
| RBF | \(\exp(-\gamma \lVert u - v \rVert^2)\) | o padrão; espaço de dimensão infinita; \(\gamma\) define o alcance |
O RBF é uma semelhança
Preveja. Três pontos numa reta, em 0, 1 e 3. Quando o \(\gamma\) cresce, a semelhança entre 0 e 3 sobe ou cai?
\(K(0, 1)\): o kernel RBF entre os pontos em 0 e em 1, \(e^{-\gamma \cdot 1^2}\); \(K(0, 3) = e^{-\gamma \cdot 3^2}\). O \(\gamma\) define a rapidez com que a semelhança some com a distância.
| \(\gamma\) | K(0, 1) | K(0, 3) |
|---|---|---|
| 0,1 | 0,905 | 0,407 |
| 0,5 | 0,607 | 0,011 |
| 2 | 0,135 | 0,000 |
Kernels comparados
Preveja. Círculos e luas, CV (validação cruzada) 5-fold. Quanto a SVM linear acerta nos círculos?
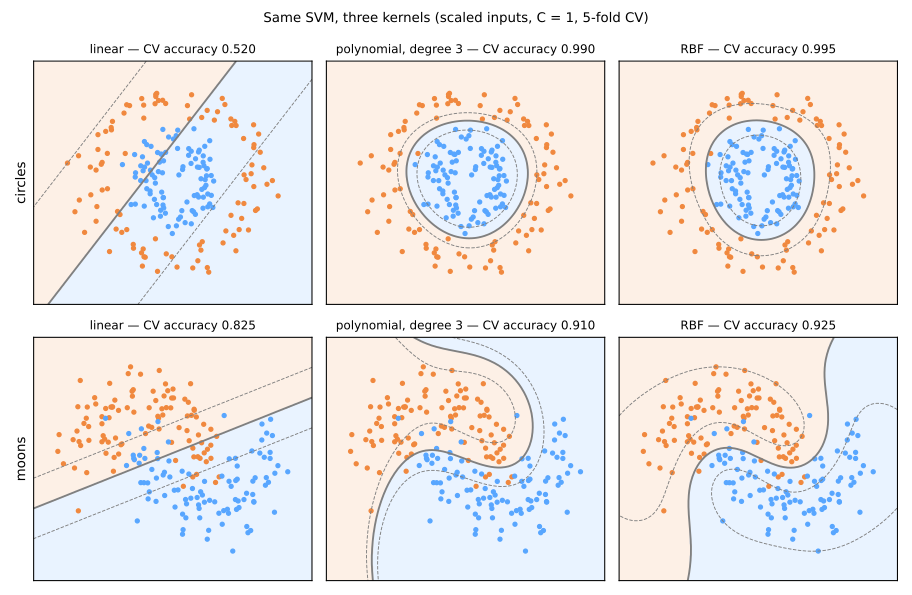
| círculos | luas | |
|---|---|---|
| linear | 0,520 | 0,825 |
| poly, grau 3 | 0,990 | 0,910 |
| RBF | 0,995 | 0,925 |
C e γ juntos
Preveja. \(C\): preço de uma violação; \(\gamma\): alcance de cada vetor de suporte. Qual canto sobreajusta?
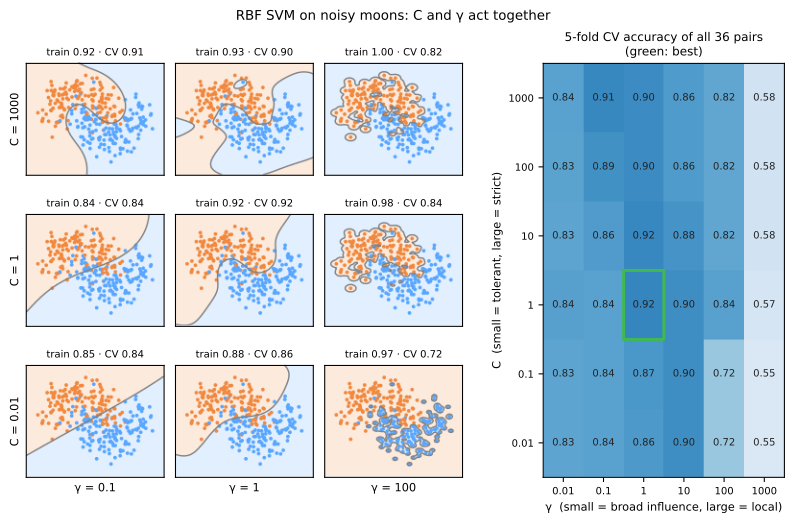
- \(\gamma\) pequeno: cada vetor de suporte alcança o plano inteiro → fronteira quase reta, 0,83–0,84 para todo \(C\);
- \(\gamma\) grande: cada vetor de suporte é uma ilha → treino quase perfeito, CV desaba para 0,55–0,58;
- a boa diagonal: \(C\) grande com \(\gamma\) pequeno ou \(C\) pequeno com \(\gamma\) maior.
Leia o vencedor com o seu ruído: com desvio de 0,022 entre folds, "0,920 em \(C = 1, \gamma = 1\)" é uma boa escolha, não um ótimo comprovado.
Escalonar é obrigatório
Preveja. O wine tem um atributo na casa das centenas (a prolina). O que acontece com a SVM RBF sem escalonar?
| desvios dos atributos | sem scaler | com scaler | |
|---|---|---|---|
| wine | 0,124 a 314,0 | 0,657 | 0,983 |
| breast cancer | 0,003 a 568,9 | 0,921 | 0,977 |
- O kernel RBF mede distância euclidiana ao quadrado: um atributo medido em milhares domina um medido em frações, exatamente como no k-NN.
gamma='scale'não resolve: ele divide pela variância de todos os atributos juntos, adaptando o \(\gamma\) à escala geral, não às diferenças entre atributos.
Escores, probabilidades e multiclasse
Preveja. Transformando os escores em probabilidades de Platt, a ROC AUC sobe, cai ou fica igual?
decision_function basta para a ROC
- a saída natural é \(f(x)\): uma distância com sinal em unidades de meia-margem, \(\pm 1\) nas bordas da rua;
- não é probabilidade, mas ordena — e ordenar é tudo de que a ROC AUC (área sob a curva ROC) e a AP (precisão média) precisam;
- ROC AUC de \(f(x)\): 0,9927; das probabilidades de Platt: 0,9927.
A sigmoide de Platt é monótona: acrescenta calibração, não discriminação. E custa 5 ajustes a mais.
Multiclasse: um-contra-um
- a
SVCtreina \(k(k-1)/2\) SVMs binárias — 45 para 10 dígitos — e prevê por maioria; - cada uma vê só as linhas dos seus dois dígitos, cerca de um quinto dos dados;
- a
LinearSVCusa um-contra-o-resto: 10 classificadores.
Nos dígitos, padronizar até custa um pouco (0,987 cru contra 0,981): os pixels já estão na mesma unidade.
Quando a SVM deixa de ser prática
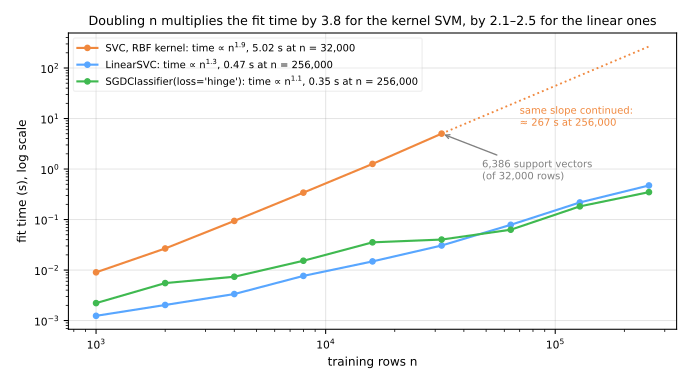
- com \(n\) linhas de treino, o ajuste custa de \(n^2\) a \(n^3\); dobrar o \(n\) multiplica o tempo por 3,8;
- 32.000 linhas ≈ 5 s; 256.000 ≈ 4,5 min, para um par \((C, \gamma)\); ×125 numa grade de 25 com CV 5-fold.
SVC(kernel="linear") | 0,979 |
LinearSVC() | 0,955 |
SGDClassifier(hinge) | 0,949 |
SVC, um-contra-o-resto | 0,952 |
LinearSVC, um-contra-um | 0,979 |
Nos dígitos, a diferença é um-contra-um contra um-contra-o-resto, não o solver.
Perfil prático
| SVM (RBF) | Regressão logística | k-NN | |
|---|---|---|---|
| fronteira | qualquer forma suave | linear | qualquer forma, local |
| o que guarda | os vetores de suporte | \(w, b\) | o treino inteiro |
| hiperparâmetros | \(C\) e \(\gamma\), acoplados | \(C\) | \(k\), distância |
| probabilidades | não; Platt depois | sim, nativas | frações de voto |
| custo de treino | \(\sim n^2\) a \(n^3\) | \(\sim n\) | nenhum |
| recorra a ela quando | \(n\) pequeno/médio, fronteira não linear, muitos atributos | precisa de probabilidades ou explicações | problemas minúsculos, baselines |
O kernel e o ajuste: passos 5 a 9
- Mesmo notebook do Colab, a partir do passo 5. Sessão nova? Ambiente de execução → Executar anteriores.
- Ligar o RBF sem ajuste nenhum já leva a acurácia de 0,886 para 0,939; o ajuste de \(C\) e \(\gamma\) leva a 0,954.
- Simulações: o que o γ faz, visto de dentro (passo 6) e escalonar num conjunto já normalizado (passo 7).
- Passos 8 e 9: rivais ajustados nos mesmos folds e o teste único.
Ritmo: passos 5 e 6 com a simulação em 15 min; passo 7 e a simulação em 10 min; passos 8 e 9 em 10 min.