O caminho desta parte
- A rua mais largamuitas retas separam; a margem escolhe
- Geometria à mãomargem com sinal, o problema de otimização, vetores de suporte
- Margem suave e Cfolga, perda hinge, o que o C compra
Muitas retas separam — qual escolher?
Preveja. As três retas da esquerda acertam todos os pontos de treino. Em qual você confiaria para um ponto novo?
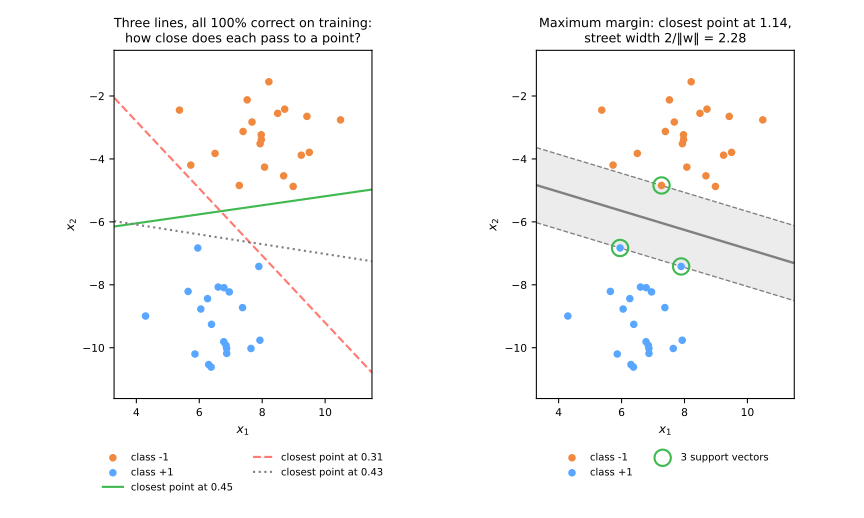
- As três da esquerda têm 100% de acurácia no treino e passam a 0,31–0,45 de algum ponto.
- A de margem máxima mantém todo ponto a pelo menos 1,14; a rua tem 2,28 de largura.
A margem com sinal
As SVMs usam \(y \in \{-1, +1\}\), o que torna central uma grandeza:
\[ m = y \cdot f(x), \qquad f(x) = w^\top x + b \]\(x\): um ponto; \(y\): o seu rótulo; \(w\): o vetor de pesos, perpendicular à fronteira; \(b\): o intercepto. A fronteira é \(f(x) = 0\).
\(m > 0\): o ponto está do lado certo; \(m\) grande: está longe da fronteira.
E a distância de um ponto ao hiperplano:
\[ \text{distância}(x) = \frac{\lvert w^\top x + b \rvert}{\lVert w \rVert} \]O problema de otimização
\[ \min_{w, b} \; \tfrac{1}{2}\lVert w \rVert^2 \quad \text{sujeito a} \quad y_i(w^\top x_i + b) \geq 1 \;\; \forall i \]\((x_i, y_i)\): o \(i\)-ésimo ponto de treino e o seu rótulo. A restrição diz: todo ponto do lado certo e fora da rua.
- maximizar a rua \(2/\lVert w \rVert\) é minimizar \(\lVert w \rVert\);
- é um programa quadrático convexo: um único ótimo global, sem inicialização aleatória, sem taxa de aprendizado.
Seis pontos, resolvidos à mão
| ponto | \(x_1\) | \(x_2\) | \(y\) |
|---|---|---|---|
| A | 0 | 0 | −1 |
| B | 1 | 0 | −1 |
| C | 0 | 1 | −1 |
| D | 2 | 2 | +1 |
| E | 3 | 2 | +1 |
| F | 2 | 3 | +1 |
Por simetria, \(w = (a, a)\). Os negativos mais próximos (B, C) estão em \(x_1 + x_2 = 1\); o positivo mais próximo (D) em 4. A fronteira fica no meio, em 2,5:
\[ 4a + b = 1,\quad a + b = -1 \;\Rightarrow\; a = \tfrac{2}{3},\; b = -\tfrac{5}{3} \] \[ \lVert w \rVert = 0{,}943 \quad\Rightarrow\quad \text{rua} = 2{,}121 \]A biblioteca confirma: w = [0.667 0.667], b = −1.667, largura 2,121, vetores de suporte B, C e D.
Só os vetores de suporte importam
Preveja. Apague E e reajuste; depois apague D e reajuste. Qual das duas remoções move a reta?
\[ w = \sum_i \alpha_i \, y_i \, x_i, \qquad \alpha_i = 0 \;\text{ para todo ponto além da margem} \]\(\alpha_i \geq 0\): um peso por ponto de treino, encontrado pelo solver. Aqui \(\alpha_i y_i = -\tfrac{2}{9}\) para B e C, \(\tfrac{4}{9}\) para D e 0 para A, E e F: \( w = -\tfrac{2}{9}(1, 0) - \tfrac{2}{9}(0, 1) + \tfrac{4}{9}(2, 2) = (\tfrac{2}{3}, \tfrac{2}{3}) \).
| ponto removido | \(w\) | largura |
|---|---|---|
| E = (3, 2) — não é vetor de suporte | (0,667; 0,667) | 2,121 (igual) |
| D = (2, 2) — é vetor de suporte | (0,5; 0,5) | 2,828 |
Classes que se sobrepõem: margem suave
\[ \min_{w,b,\xi} \; \tfrac{1}{2}\lVert w \rVert^2 + C \sum_i \xi_i \quad \text{com} \quad y_i f(x_i) \geq 1 - \xi_i, \; \xi_i \geq 0 \]\(\xi_i\): a folga, quanto o ponto \(i\) passou da borda da sua rua; \(C\): o preço de uma unidade de folga; \(m_i = y_i f(x_i)\), a sua margem com sinal.
A folga mais barata é \(\xi_i = \max(0,\, 1 - m_i)\) — a perda hinge. Substituindo:
\[ \min_{w,b} \; \tfrac{1}{2}\lVert w \rVert^2 + C \sum_i \max(0,\, 1 - y_i f(x_i)) \]Hinge contra log loss
Preveja. Quatro pontos da classe \(+1\), avaliados com a solução dos seis pontos. Quais não custam nada na hinge? E na log loss?
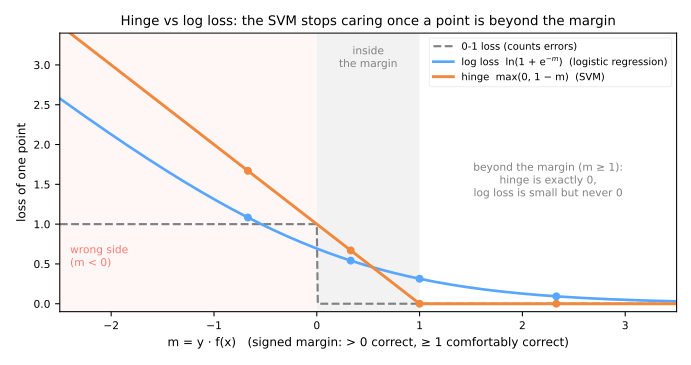
| ponto | \(m = y f(x)\) | hinge | log loss |
|---|---|---|---|
| (3, 3) | 2,333 | 0,000 | 0,093 |
| (2, 2) | 1,000 | 0,000 | 0,313 |
| (1,5; 1,5) | 0,333 | 0,667 | 0,540 |
| (1; 0,5) | −0,667 | 1,667 | 1,081 |
As duas são convexas, por isso dá para otimizá-las com confiança. A hinge é, além disso, uma cota superior da perda 0-1; a log loss, com o logaritmo natural, não chega a ser: fica abaixo de 1 para \(-0{,}54 < m \leq 0\).
O que o C faz, medido
| \(C\) | largura da rua | vetores de suporte | treino | CV (validação cruzada) |
|---|---|---|---|---|
| 0,001 | 9,23 | 78 | 0,99 | 1,000 |
| 0,01 | 5,13 | 27 | 1,00 | 0,990 |
| 0,1 | 2,63 | 12 | 1,00 | 1,000 |
| 1 | 1,33 | 6 | 1,00 | 0,990 |
| 100 | 0,39 | 3 | 1,00 | 0,990 |
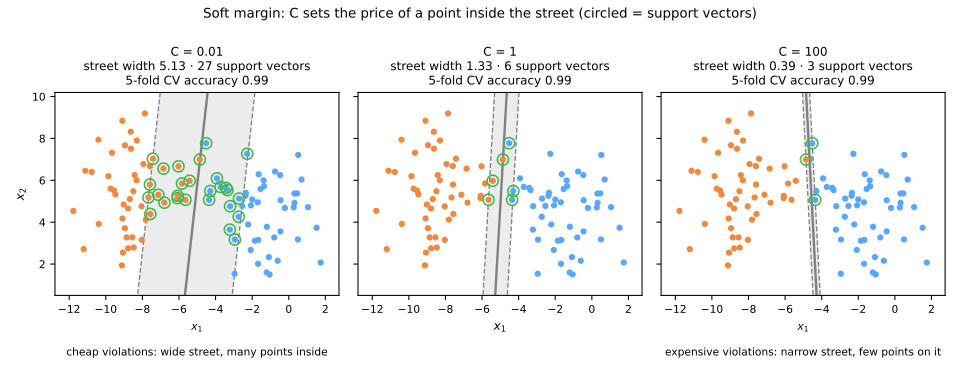
Simulador: o que o C compra
Preveja. Deslize o \(C\) de pequeno a grande. O que acontece com a largura da rua e com o número de vetores de suporte? Depois arraste um ponto longe da rua: a reta se move?
A SVM linear em cinco linhas
- A margem é a régua: a rua de largura \(2/\lVert w \rVert\).
- Maximizar a rua = minimizar \(\lVert w \rVert\), com \(y_i f(x_i) \geq 1\). Convexo: um ótimo global.
- Só os vetores de suporte importam: \(\alpha_i = 0\) além da margem.
- A margem suave cobra \(C\) por violação; a folga é a perda hinge.
- O \(C\) é o mesmo da logística: pequeno = forte regularização = rua larga.
| sintoma | o que fazer |
|---|---|
| quase todo ponto é vetor de suporte | aumentar o \(C\) |
| 3 vetores de suporte e treino 1,00 | diminuir o \(C\); olhar a CV |
| a fronteira linear não serve | o kernel, na parte avançada |
Radar: modelos lineares, passos 1 a 4
- Ionosphere: 351 retornos de radar, 34 atributos, 64% "bons". Pequeno, de alta dimensão e com fronteira não linear.
- Notebook no Colab: nada para baixar. Salve uma cópia no seu Drive.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: só os vetores de suporte importam e o C muda a largura da rua (passo 4).
Ritmo: passos 1 a 3 em 10 min; passo 4 e as duas simulações em 20 min.