U4.1 Bag-of-Words
O jeito mais simples de transformar um documento em vetor (e ainda um dos mais usados) é contar as palavras. Cada palavra do vocabulário vira uma coluna e cada documento, uma linha; a célula guarda quantas vezes aquela palavra aparece naquele documento. Nada é aprendido além do vocabulário; não há modelo nem treino. A visão geral mostrou como o texto é cortado em tokens; esta página monta a matriz de contagens a partir desses tokens, à mão e com o scikit-learn, mede quão esparsa ela fica e mostra o que ela descarta. A próxima página muda o peso dessas mesmas contagens.
Todo número abaixo sai do código ao lado; as figuras são geradas por pequenos scripts Python guardados junto desta página.
A página segue um pipeline em quatro etapas, desenhado abaixo: 1. contar as palavras, transformando cada documento numa linha de contagens; 2. comparar dois sacos com o cosseno; 3. o que o saco perde (a ordem das palavras) e como os n-gramas recuperam parte dela; 4. um corpus real, onde a matriz é quase toda zero e as palavras mais frequentes dizem pouco. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Contar as palavrasa matriz de contagens, CountVectorizer, contagem ou presença
- Comparar dois sacossimilaridade de cosseno: o ângulo, não a distância
- O que o saco perdea ordem das palavras; n-gramas de palavras e de caracteres
- Um corpus realesparsidade e o que as contagens brutas põem em primeiro lugar
Slides
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
Contagens, à mão
Etapa 1. Três documentos curtos, os mesmos da visão geral:
from sklearn.feature_extraction.text import CountVectorizer

docs = ["O gato comeu o peixe.",
        "O cachorro comeu a ração do gato.",
        "Gato dorme, gato sonha."]
analyzer = CountVectorizer().build_analyzer()
for d in docs:
    print(analyzer(d))
['gato', 'comeu', 'peixe']
['cachorro', 'comeu', 'ração', 'do', 'gato']
['gato', 'dorme', 'gato', 'sonha']
O vocabulário é o conjunto de tokens distintos, em ordem alfabética: cachorro, comeu, do, dorme, gato, peixe, ração, sonha, 8 palavras. Cada documento vira um vetor de 8 contagens:
À mão: d1 tem um 1 sob comeu, gato e peixe; d2, um 1 sob cada uma das suas cinco palavras; d3, um 2 sob gato e um 1 sob dorme e sonha.
| cachorro | comeu | do | dorme | gato | peixe | ração | sonha | |
|---|---|---|---|---|---|---|---|---|
| d1 | 0 | 1 | 0 | 0 | 1 | 1 | 0 | 0 |
| d2 | 1 | 1 | 1 | 0 | 1 | 0 | 1 | 0 |
| d3 | 0 | 0 | 0 | 1 | 2 | 0 | 0 | 1 |
O CountVectorizer monta a mesma matriz:
import numpy as np
import pandas as pd

bow = CountVectorizer()
X = bow.fit_transform(docs)
print(pd.DataFrame(X.toarray(), columns=bow.get_feature_names_out(), index=['d1', 'd2', 'd3']))
print(type(X).__name__, X.shape, 'non-zeros:', X.nnz)
print(bow.vocabulary_)
    cachorro  comeu  do  dorme  gato  peixe  ração  sonha
d1         0      1   0      0     1      1      0      0
d2         1      1   1      0     1      0      1      0
d3         0      0   0      1     2      0      0      1
csr_matrix (3, 8) non-zeros: 11
{'gato': 4, 'comeu': 1, 'peixe': 5, 'cachorro': 0, 'ração': 6, 'do': 2, 'dorme': 3, 'sonha': 7}
vocabulary_ é o dicionário de palavra para coluna que o fit aprendeu. O nome "bag" (saco) é literal: despeje as palavras de um documento num saco e sacuda: só as contagens sobrevivem. A expressão é antiga: Harris (1954) já argumentava que "a língua não é apenas um saco de palavras". A recuperação de informação representa documentos assim desde os anos 1960. Salton, Wong & Yang (1975) tornaram explícita a visão geométrica: documentos são pontos num espaço com um eixo por palavra; documentos parecidos são pontos próximos.
fit aprende o vocabulário, transform só o aplica
Como os escalonadores e codificadores de Pré-processamento, um vetorizador é uma etapa ajustada. O fit fixa o vocabulário; o transform conta só as palavras que estão nele:
new = bow.transform(["O gato comeu o gato.",
                     "O cachorro latiu.",
                     "Um felino adormeceu."])
print(new.toarray())
"latiu" não tem coluna e é descartada sem aviso; "um felino adormeceu" é feita só de palavras nunca vistas e vira o vetor nulo. Quando você divide os dados em treino e teste, ajuste o vetorizador só nos documentos de treino, como faria com um escalonador: palavras que só existem no teste não podem definir as colunas.
Contagem ou presença: binary=True
Às vezes o fato de a palavra aparecer importa mais do que quantas vezes ela aparece. binary=True troca toda contagem por 1:
O 2 de d3 sob gato virou 1. Em textos curtos (títulos, tweets, consultas de busca), em que uma palavra raramente se repete, as duas versões são quase idênticas. Em documentos longos, as contagens deixam uma única palavra muito repetida dominar o vetor; o lab mede qual versão acha melhor os posts parecidos.
Comparando dois sacos
Etapa 2. Quando os documentos viram vetores, "quão parecidos são estes dois documentos?" vira geometria. Para texto, a medida padrão é o cosseno do ângulo entre os dois vetores:
Para contagens, ele vai de 0 (nenhuma palavra em comum) a 1 (as mesmas palavras nas mesmas proporções). À mão, com a tabela acima: d1 e d2 compartilham comeu e gato, então \(x_1 \cdot x_2 = 1 + 1 = 2\); \(\lVert x_1 \rVert = \sqrt{3}\) e \(\lVert x_2 \rVert = \sqrt{5}\), logo \(\cos = 2 / \sqrt{15} = 0{,}516\). d1 e d3 compartilham só gato, com contagem 2 em d3: \(\cos = 2 / (\sqrt{3}\sqrt{6}) = 0{,}471\).
from sklearn.metrics.pairwise import cosine_similarity

print(pd.DataFrame(cosine_similarity(X), index=['d1', 'd2', 'd3'], columns=['d1', 'd2', 'd3']).round(3))
Por que o ângulo e não a distância comum (euclidiana)? Porque o comprimento de um documento não é o assunto dele. Cole d1 duas vezes e compare o resultado com d1:
C2 = bow.transform(["O gato comeu o peixe.",
                    "O gato comeu o peixe. O gato comeu o peixe."]).toarray()
print(C2)
print(f"euclidean distance {np.linalg.norm(C2[0] - C2[1]):.3f} · cosine similarity {cosine_similarity(C2)[0, 1]:.3f}")
Os dois textos dizem a mesma coisa. A distância euclidiana, \(\sqrt{3} = 1{,}732\), cresce com a diferença de comprimento; o cosseno só olha a direção e dá 1. É por isso que a busca de vizinhos mais próximos e o agrupamento de textos usam metric='cosine' ou dividem antes cada linha pelo seu comprimento (o que o vetorizador do TF-IDF faz por padrão).
A ordem das palavras se perde
Etapa 3. O saco guarda quais palavras aparecem, não onde. Duas frases de sentidos opostos:
pair = ["O cachorro mordeu o homem.",
        "O homem mordeu o cachorro."]
for ngrams in [(1, 1), (1, 2)]:
    cv = CountVectorizer(ngram_range=ngrams)
    P = cv.fit_transform(pair)
    print(ngrams, list(cv.get_feature_names_out()))
    print('   ', P.toarray().tolist(), f" cosine {cosine_similarity(P)[0, 1]:.2f}")
(1, 1) ['cachorro', 'homem', 'mordeu']
    [[1, 1, 1], [1, 1, 1]]  cosine 1.00
(1, 2) ['cachorro', 'cachorro mordeu', 'homem', 'homem mordeu', 'mordeu', 'mordeu cachorro', 'mordeu homem']
    [[1, 1, 1, 0, 1, 0, 1], [1, 0, 1, 1, 1, 1, 0]]  cosine 0.60
Com palavras sozinhas, as duas frases são o mesmo vetor: quem mordeu quem desapareceu. Acrescentar bigramas (pares de tokens vizinhos, ngram_range=(1, 2)) recupera a ordem local: "cachorro mordeu" e "mordeu homem" só aparecem na primeira frase, "homem mordeu" e "mordeu cachorro" só na segunda. O cosseno cai para 0,60. O preço são mais colunas, quase todas raras. Repare também que o bigrama junta tokens que ficam vizinhos depois da tokenização: o artigo "o" foi descartado, então "mordeu o homem" deu "mordeu homem".
n-gramas de caracteres
Os n-gramas também podem ser tirados de caracteres. analyzer='char_wb' corta cada palavra, com espaços nas bordas, em pedaços sobrepostos de algumas letras. Duas formas da mesma palavra, que são colunas sem relação num saco de palavras, passam a compartilhar a maioria dos pedaços:
for pair in [("sábado", "sábados"), ("gato", "gatos"), ("gato", "pato")]:
    cv = CountVectorizer(analyzer='char_wb', ngram_range=(3, 3))
    P = cv.fit_transform(pair)
    shared = sorted(set(cv.build_analyzer()(pair[0])) & set(cv.build_analyzer()(pair[1])))
    print(f"{pair[0]:7s} / {pair[1]:8s} cosine {cosine_similarity(P)[0, 1]:.2f}   shared trigrams: {shared}")
sábado  / sábados  cosine 0.77   shared trigrams: [' sá', 'ado', 'bad', 'sáb', 'ába']
gato    / gatos    cosine 0.67   shared trigrams: [' ga', 'ato', 'gat']
gato    / pato     cosine 0.50   shared trigrams: ['ato', 'to ']
"sábado" e "sábados" agora têm cosseno 0,77, sem stemmer nenhum. Os n-gramas de caracteres toleram plurais, conjugações e erros de digitação, o que ajuda com textos curtos e ruidosos. A última linha mostra o custo: "gato" e "pato" também dão 0,50, porque compartilham a grafia, não o sentido.
Esparsidade
Etapa 4. Os três documentos preencheram 11 de 24 células. Um corpus de verdade: a parte de treino do 20 Newsgroups (Lang, 1995), 11.314 posts de 20 grupos de discussão da Usenet, sem cabeçalhos, assinaturas e respostas citadas:
from sklearn.datasets import fetch_20newsgroups

news = fetch_20newsgroups(subset='train', remove=('headers', 'footers', 'quotes'))
Xn = CountVectorizer().fit_transform(news.data)
cells = Xn.shape[0] * Xn.shape[1]
print(Xn.shape, f"non-zeros: {Xn.nnz:,}  ->  {1 - Xn.nnz / cells:.2%} zeros")
print(f"distinct words per post (median): {np.median(np.diff(Xn.indptr)):.0f}")
print(f"memory as a dense float64 array: {cells * 8 / 1e9:.1f} GB")
print(f"memory as a sparse CSR matrix:   {(Xn.data.nbytes + Xn.indices.nbytes + Xn.indptr.nbytes) / 1e6:.1f} MB")
(11314, 101631) non-zeros: 1,103,627  ->  99.90% zeros
distinct words per post (median): 61
memory as a dense float64 array: 9.2 GB
memory as a sparse CSR matrix:   13.3 MB
Um post típico usa 61 das 101.631 colunas. Guardada como um array comum, a matriz ocuparia 9,2 GB; o scikit-learn a devolve no formato CSR (linhas esparsas comprimidas), que guarda só os valores não nulos e as posições de suas colunas: 13,3 MB, cerca de 700 vezes menos. É por isso que os vetorizadores devolvem matrizes esparsas e que o .toarray() fica restrito a exemplos pequenos.
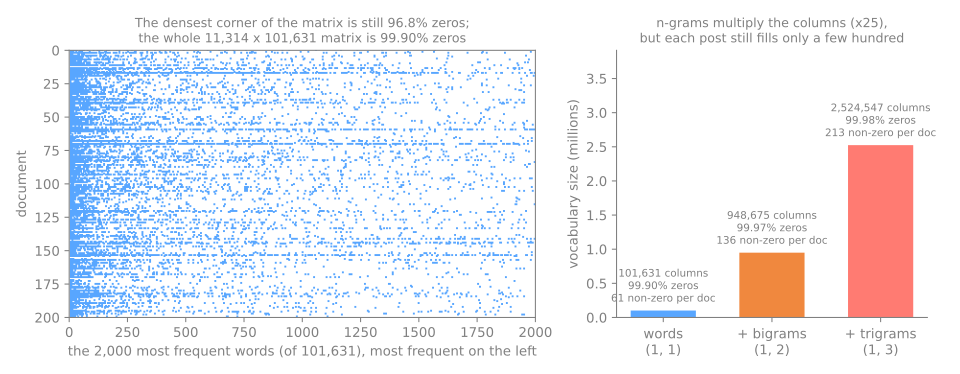
O painel da direita é o preço dos n-gramas no corpus inteiro: os bigramas multiplicam as colunas por 9, os trigramas por 25, enquanto cada post preenche só algumas centenas delas. A maioria dos pares de palavras aparece uma vez no corpus inteiro. min_df=2 (mantém só os termos presentes em pelo menos 2 documentos) ou max_features controlam o tamanho.
O que as contagens brutas põem em primeiro lugar
Some cada coluna e ordene: quais palavras um bag-of-words considera mais importantes?
for params in [{}, {'stop_words': 'english'}]:
    cv = CountVectorizer(**params)
    Xc = cv.fit_transform(news.data)
    freq = np.asarray(Xc.sum(axis=0)).ravel()
    top = np.argsort(-freq)[:8]
    print(params, list(cv.get_feature_names_out()[top]))
    print(f"    '{cv.get_feature_names_out()[top[0]]}' occurs {freq[top[0]]:,} times, in {(Xc[:, top[0]] > 0).sum():,} posts")
{} ['the', 'ax', 'to', 'of', 'and', 'in', 'is', 'that']
    'the' occurs 106,381 times, in 9,475 posts
{'stop_words': 'english'} ['ax', 'max', 'people', 'like', 'don', 'just', 'know', 'use']
    'ax' occurs 62,387 times, in 20 posts
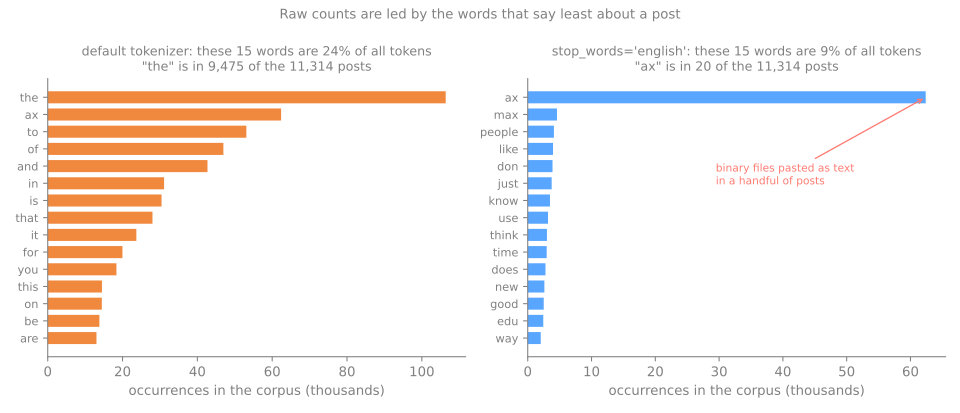
Duas lições numa figura. À esquerda, as colunas com as maiores contagens são the, to, of, and: palavras presentes em quase todo post ("the" em 9.475 dos 11.314), que não dizem nada sobre o assunto. Uma lista de stop words do inglês as remove. À direita, o novo líder é "ax": 62.387 ocorrências, em só 20 posts. Esses posts contêm arquivos binários colados como texto, em que "ax" se repete milhares de vezes. As contagens brutas deixam um único documento estranho dominar uma coluna inteira. Os dois problemas têm a mesma cura, que é o assunto da próxima página: pesar cada palavra pelo número de documentos que a contêm, não só pelo número de vezes que ela aparece.
Simulador: monte o saco você mesmo
Digite um documento por linha e veja o vocabulário e a matriz de contagens se atualizarem. As regras são as do scikit-learn: minúsculas, tokens de duas ou mais letras ou dígitos, stop words removidas antes dos bigramas. Os presets reproduzem os exemplos desta página.
O que testar:
- ordem: as duas primeiras frases recebem vetores idênticos (o simulador avisa "d1 = d2"). Marque incluir bigramas e elas se separam;
- sábado/sábados: três frases sobre a mesma coisa; as formas no singular, no plural e com maiúscula das mesmas palavras caem em colunas diferentes quando você desmarca minúsculas;
- binário: no preset da aula, só d3 muda (gato 2 → 1).
Exercícios
- À mão, calcule o cosseno entre d2 e d3 da tabela acima e confira o valor 0,365.
- Acrescente o documento "O peixe dorme." aos três da aula. Quantas colunas o vocabulário tem agora? Escreva a nova linha à mão e depois confira com o
CountVectorizer. - Um post de 300 palavras e um de 30 palavras falam do mesmo assunto. Por que a distância euclidiana entre eles pode ser grande enquanto o cosseno é alto? O que muda se você usar
binary=True? - Com
ngram_range=(1, 3), quantas colunas os três documentos da aula produzem? Conte à mão primeiro.
Lab: bag-of-words em posts reais
Quatro newsgroups da coleção 20 Newsgroups (computação gráfica, beisebol, eletrônica e cristianismo), cerca de 2.100 posts. O lab monta a matriz de contagens, olha o que ela contém e mede como cada escolha (stop words, min_df, binary, bigramas, n-gramas de caracteres) muda a resposta a uma pergunta: os posts mais parecidos falam do mesmo assunto? Usa só o scikit-learn e roda em bem menos de um minuto.
Rode os blocos em ordem, numa mesma sessão. Para trabalhar direto nele, baixe o notebook do lab e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook).
Passo 1 — carregar os posts
import numpy as np
import pandas as pd
from sklearn.datasets import fetch_20newsgroups

cats = ['comp.graphics', 'rec.sport.baseball', 'sci.electronics', 'soc.religion.christian']
raw = fetch_20newsgroups(subset='train', categories=cats,
                         remove=('headers', 'footers', 'quotes'), random_state=0)
keep = [i for i, t in enumerate(raw.data) if len(t.split()) >= 20]   # descarta posts vazios ou muito curtos
docs = [raw.data[i] for i in keep]
y = raw.target[keep]
names = np.array(raw.target_names)

print(f"{len(raw.data)} posts downloaded, {len(docs)} kept")
print(pd.Series(names[y]).value_counts().sort_index())
print(f"words per post: median {np.median([len(d.split()) for d in docs]):.0f}")
print(' '.join(docs[0].split())[:160])
2371 posts downloaded, 2116 kept
comp.graphics             521
rec.sport.baseball        495
sci.electronics           535
soc.religion.christian    565
Name: count, dtype: int64
words per post: median 97
Their phone number is 1-800-377-9777. The last catalog shows three Oaks jerseys: 36 Home, 42 Home, 39 Home - they're each $165.00. All their merchandise is hand
Dos 2.371 posts, 2.116 têm pelo menos 20 palavras depois de retirados cabeçalhos, assinaturas e respostas citadas; muitos dos outros ficam vazios. Os quatro grupos são equilibrados (495 a 565 posts) e um post mediano tem 97 palavras. Retirar os cabeçalhos importa: eles trazem endereços de e-mail e organizações, então qualquer método que compare posts poderia casar os remetentes em vez do assunto. O primeiro post, sobre camisas de beisebol, mostra como é um documento: informal, com números e preços.
Passo 2 — a matriz de contagens
from sklearn.feature_extraction.text import CountVectorizer

counts = CountVectorizer()
C = counts.fit_transform(docs)
vocab = counts.get_feature_names_out()
freq = np.asarray(C.sum(axis=0)).ravel()

print(C.shape, f"{1 - C.nnz / (C.shape[0] * C.shape[1]):.2%} zeros")
print(f"distinct words per post (median): {np.median(np.diff(C.indptr)):.0f}")
print('10 most frequent words:', list(vocab[np.argsort(-freq)[:10]]))
print(f"words seen only once: {(freq == 1).mean():.0%} of the vocabulary")
(2116, 25715) 99.62% zeros
distinct words per post (median): 67
10 most frequent words: ['the', 'to', 'of', 'and', 'is', 'in', 'that', 'it', 'for', 'you']
words seen only once: 45% of the vocabulary
Como ler:
- 2.116 posts × 25.715 palavras, 99,62% de zeros: um post mediano usa 67 palavras distintas de 25.715.
- As dez palavras mais frequentes são todas palavras funcionais: "the", "to", "of" estão em quase todo post e não dizem nada sobre o assunto.
- 45% do vocabulário aparece uma vez no corpus inteiro: a cauda longa de nomes, números, erros de digitação e palavras raras que a lei de Zipf prevê (visão geral).
Passo 3 — do que cada newsgroup fala
cv_stop = CountVectorizer(stop_words='english')
S = cv_stop.fit_transform(docs)
words = cv_stop.get_feature_names_out()
for c in range(4):
    total = np.asarray(S[y == c].sum(axis=0)).ravel()      # soma as linhas de um grupo
    print(f"{names[c]:24s}", list(words[np.argsort(-total)[:8]]))
comp.graphics            ['image', 'graphics', 'edu', 'jpeg', 'file', 'use', 'data', 'files']
rec.sport.baseball       ['year', 'game', 'good', 'team', 'think', 'don', '00', 'just']
sci.electronics          ['use', 'like', 'power', 'don', 'wire', 'ground', 'used', 'know']
soc.religion.christian   ['god', 'jesus', 'people', 'church', 'think', 'does', 'know', 'believe']
Sem as stop words do inglês, somar as linhas de cada grupo dá um retrato legível dele: image, graphics, jpeg, file para gráficos; game, team, year para beisebol; power, wire, ground para eletrônica; god, jesus, church, believe para cristianismo. O bag-of-words carrega, sim, o assunto. Carrega também um ruído que a lista de stop words não pega: "don" (o que o tokenizador deixa de "don't"), "think", "just", "use", "edu" (dos endereços de e-mail) e "00" (das estatísticas de beisebol) são frequentes em alguns grupos sem falar de nada.
Passo 4 — encolhendo o vocabulário
for params in [{}, {'stop_words': 'english'}, {'min_df': 2}, {'stop_words': 'english', 'min_df': 2},
               {'max_df': 0.5}]:
    cv = CountVectorizer(**params).fit(docs)
    print(f"{str(params):42s} {len(cv.vocabulary_):6d} columns")

cv_half = CountVectorizer(max_df=0.5).fit(docs)
print('dropped by max_df=0.5:', sorted(set(vocab) - set(cv_half.vocabulary_)))
{}                                          25715 columns
{'stop_words': 'english'}                   25411 columns
{'min_df': 2}                               12297 columns
{'stop_words': 'english', 'min_df': 2}      12001 columns
{'max_df': 0.5}                             25703 columns
dropped by max_df=0.5: ['and', 'be', 'for', 'have', 'in', 'is', 'it', 'of', 'that', 'the', 'this', 'to']
Os botões agem em pontas opostas da escala de frequência:
- a lista de stop words remove só 304 colunas (25.715 → 25.411), mas são as palavras mais frequentes;
min_df=2remove mais da metade do vocabulário (→ 12.297): palavras presentes num único post, que não ajudam a comparar dois posts;max_df=0.5descarta as palavras presentes em mais da metade dos posts. Aqui são só 12 palavras, todas funcionais ("and", "the", "of", ...): uma lista de stop words aprendida dos próprios dados, sem escolher uma língua.
Passo 5 — comparando posts: contagens, presença, stop words
from sklearn.neighbors import NearestNeighbors

def agreement(V, k=5):
    """Fração dos k posts mais próximos (cosseno) de cada post que vêm do mesmo newsgroup."""
    nn = NearestNeighbors(n_neighbors=k + 1, metric='cosine').fit(V)
    _, idx = nn.kneighbors(V)
    return (y[idx[:, 1:]] == y[:, None]).mean()

print(f"chance level: {np.sum(np.bincount(y) ** 2) / len(y) ** 2:.3f}")
for params in [{}, {'binary': True}, {'stop_words': 'english'}, {'stop_words': 'english', 'binary': True}]:
    V = CountVectorizer(**params).fit_transform(docs)
    print(f"{str(params):42s} agreement {agreement(V):.3f}")
chance level: 0.251
{}                                         agreement 0.490
{'binary': True}                           agreement 0.650
{'stop_words': 'english'}                  agreement 0.793
{'stop_words': 'english', 'binary': True}  agreement 0.768
Um jeito de avaliar uma representação sem treinar modelo nenhum: para cada post, ache os seus 5 posts mais próximos pelo cosseno e conte quantos vêm do mesmo newsgroup. Escolher vizinhos ao acaso daria 0,251 (a chance de dois posts aleatórios serem do mesmo grupo).
- Contagens brutas: 0,490. Os posts ficam "perto" quando usam the, to, of em proporções parecidas, o que tem pouco a ver com o assunto.
binary=True: 0,650. A presença limita o peso de uma palavra funcional repetida; com isso, o escore dá um salto.- Sem stop words: 0,793. Tirar as palavras funcionais é o que mais ajuda. Sem elas, as contagens (0,793) ficam um pouco à frente da presença (0,768): quando as palavras que sobram falam de algo, repeti-las é informativo.
A página de TF-IDF vai além, pesando cada palavra pelo número de posts que a contêm em vez de remover uma lista fixa.
Passo 6 — n-gramas de palavras e de caracteres
for params in [{'stop_words': 'english', 'min_df': 2},
               {'stop_words': 'english', 'min_df': 2, 'ngram_range': (1, 2)},
               {'analyzer': 'char_wb', 'ngram_range': (3, 5), 'min_df': 2}]:
    V = CountVectorizer(**params).fit_transform(docs)
    print(f"{str(params):70s} {V.shape[1]:6d} columns · agreement {agreement(V):.3f}")
{'stop_words': 'english', 'min_df': 2}                                  12001 columns · agreement 0.793
{'stop_words': 'english', 'min_df': 2, 'ngram_range': (1, 2)}           25184 columns · agreement 0.793
{'analyzer': 'char_wb', 'ngram_range': (3, 5), 'min_df': 2}             94920 columns · agreement 0.529
Os bigramas dobram o vocabulário (12.001 → 25.184 colunas) e não mudam a concordância (0,793 nos dois casos): distinguir beisebol de eletrônica é questão de vocabulário, que as palavras sozinhas já capturam. Os n-gramas de 3 a 5 caracteres dão 94.920 colunas e uma concordância pior (0,529): seus pedaços são compartilhados por palavras de todos os assuntos e incluem os pedaços das palavras funcionais que a lista de stop words tinha removido. Eles compensam em outros cenários: textos curtos e ruidosos, erros de digitação, línguas de morfologia rica.
Passo 7 — o saco não distingue um post de suas palavras embaralhadas
rng = np.random.default_rng(0)
analyzer = counts.build_analyzer()
shuffled = [' '.join(rng.permutation(analyzer(d))) for d in docs[:3]]
print(shuffled[0][:120])

A = counts.transform(docs[:3])
B = counts.transform(shuffled)
print('same count vectors:', (A != B).nnz == 0)
42 couple merchandise last wool 165 on 800 if call shows number also replica home jackets three even and they 39 afford
same count vectors: True
O primeiro post com as palavras embaralhadas fica ilegível, mas seu vetor de contagens é idêntico ao do original, assim como os dos dois posts seguintes: (A != B).nnz == 0 confere que nenhuma célula difere. Tudo o que um bag-of-words sabe sobre um documento sobrevive a um embaralhamento aleatório de suas palavras.
Sua vez
- Posts mais parecidos. Escolha um post, calcule
cosine_similarity(V[i], V)com a melhor representação do passo 5 e imprima os três posts mais parecidos com seus newsgroups. Faça o mesmo com as contagens brutas. Quais palavras tornam "parecidos" os vizinhos das contagens brutas? - Sua própria lista de stop words. Acrescente à lista do inglês do scikit-learn as palavras da lista
max_df=0.5do passo 4 e as palavras frequentes e sem assunto do passo 3 ("don", "just", "think"). Depois, rode o passo 5 de novo. A concordância sobe? - Português. Escreva cinco frases curtas em português sobre dois assuntos diferentes e monte o saco delas com e sem a lista mínima de stop words da visão geral. Quais palavras o tokenizador padrão descarta antes de qualquer lista de stop words?
- Embaralhado com bigramas. Repita o passo 7 com
CountVectorizer(ngram_range=(1, 2)). Os vetores continuam iguais? Por quê?
Material de aula
Notebook do lab
O lab desta página como notebook, pronto para o Jupyter ou o Colab: notebook do lab.
Referências
- Harris, Z. S. "Distributional Structure." Word 10, no. 2–3 (1954): 146–162 — onde aparece "language is not merely a bag of words". DOI
- Salton, G.; Wong, A.; Yang, C. S. "A Vector Space Model for Automatic Indexing." Communications of the ACM 18, no. 11 (1975): 613–620 — documentos como vetores, um eixo por termo. DOI
- Lang, K. "NewsWeeder: Learning to Filter Netnews." Proceedings of ICML (1995): 331–339 — a origem da coleção 20 Newsgroups. DOI
- Manning, C. D.; Raghavan, P.; Schütze, H. Introduction to Information Retrieval. Cambridge University Press (2008) — capítulo 2 (tokens e termos) e capítulo 6 (o modelo de espaço vetorial). Texto completo