O caminho desta parte
- Pedaços de palavrasn-gramas de caracteres: plurais, erros de digitação, rimas
- Um corpus real99,90% de zeros, formato CSR, o preço dos n-gramas
- O que as contagens põem em primeiropalavras que estão em toda parte, um documento estranho
Cada etapa responde a uma pergunta: e se contarmos pedaços de palavras? → como é um corpus real em contagens? → quais palavras as contagens brutas põem em primeiro?
Etapa 1 · e se contarmos pedaços de palavras?
n-gramas de caracteres
analyzer='char_wb' corta cada palavra, com espaços nas bordas, em pedaços sobrepostos de 3 letras.
| par | cosseno | trigramas compartilhados |
|---|---|---|
| sábado / sábados | 0,77 | ' sá', 'ado', 'bad', 'sáb', 'ába' |
| gato / gatos | 0,67 | ' ga', 'ato', 'gat' |
| gato / pato | 0,50 | 'ato', 'to ' |
Toleram plurais, conjugações e erros de digitação, sem stemmer nenhum. O custo: "gato" e "pato" compartilham a grafia, não o sentido.
Etapa 2 · como é um corpus real em contagens?
Esparsidade: um corpus de verdade
20 Newsgroups, parte de treino: 11.314 posts, sem cabeçalhos, assinaturas e respostas citadas.
Preveja. O vocabulário tem 101.631 palavras. Que fração das células é zero?
zeros
99,90%
um post mediano usa 61 colunas
como array denso
9,2 GB
float64
como CSR esparsa
13,3 MB
cerca de 700 vezes menos
Por que os vetorizadores devolvem matrizes esparsas
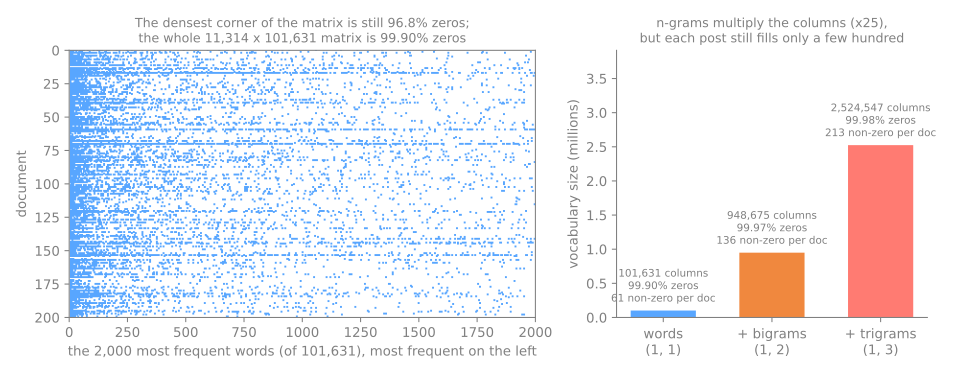
O formato CSR (linhas esparsas comprimidas) guarda só os valores não nulos e suas colunas. Os bigramas multiplicam as colunas por 9 e os trigramas por 25; min_df=2 ou max_features controlam o tamanho. O .toarray() fica restrito a exemplos pequenos.
Etapa 3 · quais palavras as contagens brutas põem em primeiro?
O que as contagens brutas põem em primeiro lugar
Some cada coluna dos 11.314 posts e ordene.
Preveja. Qual palavra vem primeiro? E depois de remover as stop words do inglês?
| vetorizador | palavras do topo | a líder |
|---|---|---|
| padrão | the, ax, to, of, and, in, is, that | "the": 106.381 vezes, em 9.475 posts |
stop_words='english' | ax, max, people, like, don, just, know, use | "ax": 62.387 vezes, em 20 posts |
Dois problemas, uma cura
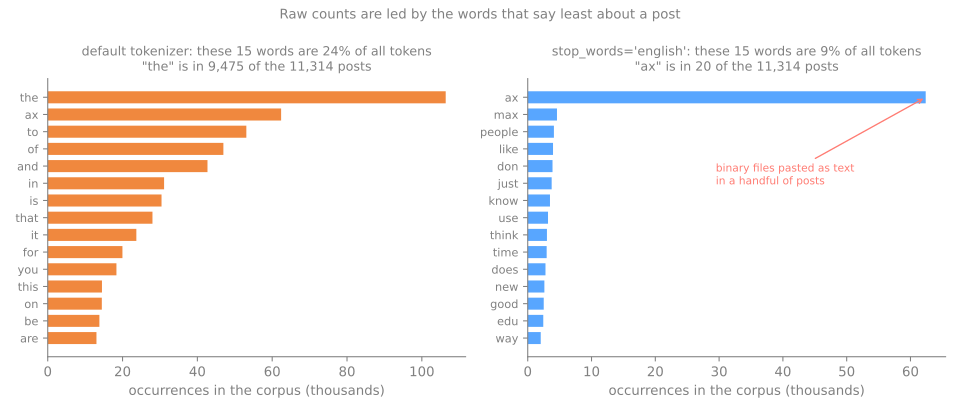
- Palavras presentes em quase todo post não dizem nada sobre o assunto.
- "ax" se repete milhares de vezes em 20 posts com arquivos binários colados como texto: um único documento estranho domina uma coluna.
A cura, na próxima página (E2.2 TF-IDF): pesar cada palavra por quantos documentos a contêm, não só por quantas vezes ela aparece.
Resumo
- Os n-gramas de caracteres casam pedaços da grafia: plurais e erros de digitação se aproximam; as rimas também.
- Uma matriz de contagens real tem 99,90% de zeros; o CSR guarda só os não nulos (13,3 MB em vez de 9,2 GB).
- Os n-gramas multiplicam as colunas e a maioria das novas aparece num único post: o
min_dfas controla. - As contagens brutas são lideradas por palavras que estão em toda parte ("the") ou por um documento estranho ("ax").
A seguir: o TF-IDF (frequência do termo × frequência inversa nos documentos) pesa cada palavra pelo número de documentos que a contêm.
Lab avançado · cerca de 15 min, em duplas
O que o saco não enxerga, passos 6 e 7
- Continue no mesmo notebook e na mesma sessão dos passos 1 a 5.
- Passo 6: n-gramas de palavras e de caracteres, avaliados pela concordância de vizinhos.
- Passo 7: um post com as palavras embaralhadas tem exatamente o mesmo vetor de contagens.
- Simulação: quão raros são os n-gramas? (passo 6).
- O notebook do lab, a partir do passo 6.
Ritmo: passo 6 e a simulação em 10 min; passo 7 em 5 min.