A ideia
uma coluna
para cada palavra do vocabulário
uma linha
para cada documento
uma célula
quantas vezes aquela palavra aparece naquele documento
O caminho desta aula
- Contar as palavrasa matriz de contagens, CountVectorizer, contagem ou presença
- Comparar dois sacossimilaridade de cosseno: o ângulo, não a distância
- O que o saco perdea ordem das palavras; n-gramas de palavras e de caracteres
- Um corpus realesparsidade e o que as contagens brutas põem em primeiro lugar
Três documentos, cortados em tokens
"O gato comeu o peixe."               ['gato', 'comeu', 'peixe']
"O cachorro comeu a ração do gato."   ['cachorro', 'comeu', 'ração', 'do', 'gato']
"Gato dorme, gato sonha."             ['gato', 'dorme', 'gato', 'sonha']
Contagens, à mão
O vocabulário, em ordem alfabética: 8 palavras.
| cachorro | comeu | do | dorme | gato | peixe | ração | sonha | |
|---|---|---|---|---|---|---|---|---|
| d1 | 0 | 1 | 0 | 0 | 1 | 1 | 0 | 0 |
| d2 | 1 | 1 | 1 | 0 | 1 | 0 | 1 | 0 |
| d3 | 0 | 0 | 0 | 1 | 2 | 0 | 0 | 1 |
O CountVectorizer monta a mesma matriz
bow = CountVectorizer()
X = bow.fit_transform(docs)
print(type(X).__name__, X.shape, 'non-zeros:', X.nnz)
print(bow.vocabulary_)
csr_matrix (3, 8) non-zeros: 11
{'gato': 4, 'comeu': 1, 'peixe': 5, 'cachorro': 0, 'ração': 6, 'do': 2, 'dorme': 3, 'sonha': 7}
O fit aprende o vocabulário, o transform só o aplica
O vetorizador acima foi ajustado nos três documentos. Agora, três documentos novos:
- "O gato comeu o gato."
- "O cachorro latiu."
- "Um felino adormeceu."
Palavras nunca vistas não têm coluna
[[0 1 0 0 2 0 0 0]
 [1 0 0 0 0 0 0 0]
 [0 0 0 0 0 0 0 0]]
- "latiu" é descartada sem aviso.
- "um felino adormeceu" é feita só de palavras nunca vistas: vira o vetor nulo.
Contagem ou presença: binary=True
[[0 1 0 0 1 1 0 0]
 [1 1 1 0 1 0 1 0]
 [0 0 0 1 1 0 0 1]]
O 2 de d3 sob gato virou 1.
textos curtos
títulos, tweets, consultas: uma palavra raramente se repete, então as duas versões são quase idênticas
documentos longos
as contagens deixam uma única palavra muito repetida dominar o vetor
Comparando dois sacos: o cosseno
\[ \cos(x_a, x_b) = \frac{x_a \cdot x_b}{\lVert x_a \rVert\, \lVert x_b \rVert} \]Para contagens: de 0 (nenhuma palavra em comum) a 1 (as mesmas palavras nas mesmas proporções).
À mão, depois conferido
d1, d2: \(x_1 \cdot x_2 = 1 + 1 = 2\)
\[ \cos = \frac{2}{\sqrt{3}\,\sqrt{5}} = 0{,}516 \]d1, d3: só gato, contagem 2 em d3
\[ \cos = \frac{2}{\sqrt{3}\,\sqrt{6}} = 0{,}471 \]
       d1     d2     d3
d1  1.000  0.516  0.471
d2  0.516  1.000  0.365
d3  0.471  0.365  1.000
cosine_similarity(X)
Por que o ângulo e não a distância?
Cole d1 duas vezes e compare o resultado com d1:
"O gato comeu o peixe."                          [0 1 0 0 1 1 0 0]
"O gato comeu o peixe. O gato comeu o peixe."    [0 2 0 0 2 2 0 0]
distância euclidiana
cosseno
O comprimento de um documento não é o assunto dele
metric='cosine' ou dividem antes cada linha pelo seu comprimento (o que o vetorizador do TF-IDF faz por padrão).A ordem das palavras se perde
- "O cachorro mordeu o homem."
- "O homem mordeu o cachorro."
| atributos | vetores | cosseno |
|---|---|---|
| palavras sozinhas (3 colunas) | [1, 1, 1] e [1, 1, 1] | 1,00 |
| + bigramas (7 colunas) | "cachorro mordeu", "mordeu homem" só na primeira; "homem mordeu", "mordeu cachorro" só na segunda | 0,60 |
Os bigramas recuperam a ordem local, com um preço
- Com palavras sozinhas, as duas frases são o mesmo vetor: quem mordeu quem desapareceu.
ngram_range=(1, 2)acrescenta pares de tokens vizinhos e o cosseno cai para 0,60.- O preço: mais colunas, quase todas raras.
n-gramas de caracteres
analyzer='char_wb' corta cada palavra, com espaços nas bordas, em pedaços sobrepostos de 3 letras.
| par | cosseno | trigramas compartilhados |
|---|---|---|
| sábado / sábados | 0,77 | ' sá', 'ado', 'bad', 'sáb', 'ába' |
| gato / gatos | 0,67 | ' ga', 'ato', 'gat' |
| gato / pato | 0,50 | 'ato', 'to ' |
Esparsidade: um corpus de verdade
20 Newsgroups, parte de treino: 11.314 posts, sem cabeçalhos, assinaturas e respostas citadas.
zeros
como array denso
como CSR esparsa
Por que os vetorizadores devolvem matrizes esparsas
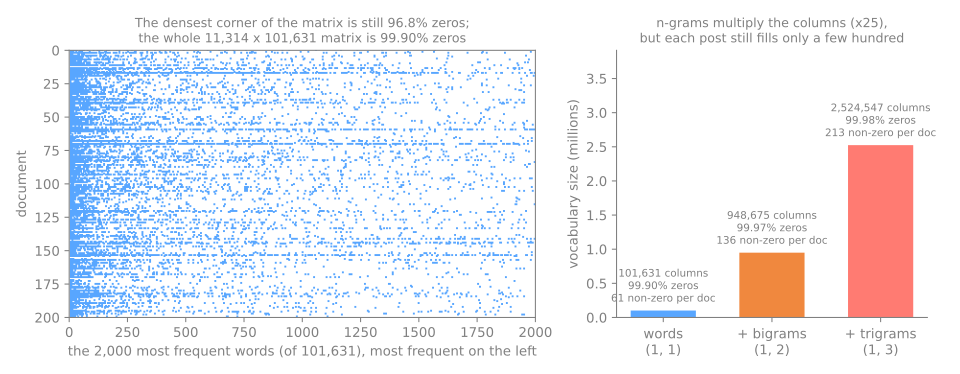
O formato CSR (linhas esparsas comprimidas) guarda só os valores não nulos e suas colunas. Os bigramas multiplicam as colunas por 9 e os trigramas por 25; min_df=2 ou max_features controlam o tamanho. O .toarray() fica restrito a exemplos pequenos.
O que as contagens brutas põem em primeiro lugar
Some cada coluna dos 11.314 posts e ordene.
| vetorizador | palavras do topo | a líder |
|---|---|---|
| padrão | the, ax, to, of, and, in, is, that | "the": 106.381 vezes, em 9.475 posts |
stop_words='english' | ax, max, people, like, don, just, know, use | "ax": 62.387 vezes, em 20 posts |
Dois problemas, uma cura
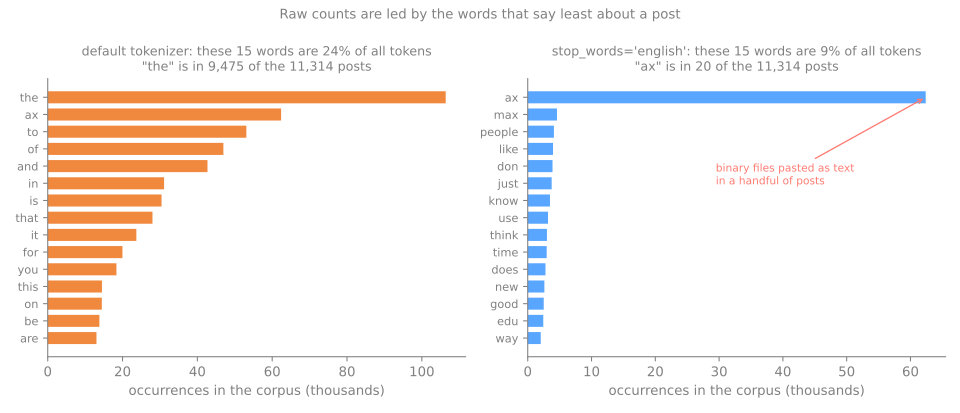
- Palavras presentes em quase todo post não dizem nada sobre o assunto.
- "ax" se repete milhares de vezes em 20 posts com arquivos binários colados como texto: um único documento estranho domina uma coluna.
Simulador: monte o saco você mesmo
Preveja. Carregue o preset ordem: as duas primeiras frases vão receber vetores diferentes? Depois marque incluir bigramas.
Resumo
- Um documento vira as contagens das suas palavras, uma coluna por palavra do vocabulário.
- O
fitfixa o vocabulário; palavras nunca vistas são descartadas. Ajuste só no treino. - Compare documentos pelo cosseno: comprimento não é assunto.
- A ordem se perde; bigramas e n-gramas de caracteres recuperam um pouco, com muito mais colunas.
- A matriz tem 99,90% de zeros: o armazenamento esparso é obrigatório.
- As contagens brutas são lideradas por palavras que estão em toda parte ou num único documento estranho.
Bag-of-words em posts reais
- Quatro newsgroups (computação gráfica, beisebol, eletrônica e cristianismo), cerca de 2.100 posts.
- Uma pergunta: os posts mais parecidos são sobre o mesmo assunto?
- Passos: carregar os posts · a matriz de contagens · do que cada newsgroup fala · encolhendo o vocabulário · contagens, presença, stop words · n-gramas de palavras e de caracteres · o saco não distingue um post de suas palavras embaralhadas.
- Baixe o notebook do lab e abra no Jupyter ou no Colab.