E2.4 Sentence Embeddings
Os word embeddings dão a cada palavra um vetor denso, mas a maioria das tarefas é sobre textos: achar a pergunta frequente que responde a uma dúvida, agrupar chamados de suporte, recuperar os documentos que atendem a uma consulta. Esta página trata de um vetor por frase ou documento curto, construído de modo que o cosseno entre dois deles acompanhe a proximidade dos seus significados.
Primeiro, a resposta mais simples (a média dos vetores das palavras) é construída à mão e suas falhas são medidas: a ordem das palavras e a negação desaparecem; toda frase acaba parecida com todas as outras. Depois vêm os embeddings contextuais: um Transformer calcula o vetor de cada palavra a partir da frase inteira em volta dela, de modo que "bank" ao lado de "river" (rio) e "bank" ao lado de "loan" (empréstimo) recebem vetores diferentes. O Sentence-BERT treina uma rede dessas para que um único vetor resuma uma frase; a biblioteca sentence-transformers reduz isso a uma chamada de uma linha. Com ela: TF-IDF, média de vetores de palavras e sentence embeddings comparados nos mesmos pares, modelos em inglês e multilíngues comparados em português, busca semântica como vizinhos mais próximos, frases agrupadas com k-means e os detalhes práticos (limite de tamanho, custo, escolha do modelo). A visão geral põe TF-IDF e sentence embeddings lado a lado em busca e classificação; esta página mostra o que há dentro da caixa. Todo número abaixo sai do código ao lado.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Como obter um vetor por frase cujo cosseno acompanhe o significado e como buscar com ele? | Como os vetores de frase se comportam quando são agrupados e postos em produção? |
| conteúdo | a média de vetores de palavras e o que ela perde, embeddings contextuais, Sentence-BERT, TF-IDF contra média contra sentence embeddings, modelos para outras línguas, busca semântica como vizinhos mais próximos | agrupar frases, normalizar e codificar uma vez, o limite de tamanho, custo, escolha do modelo, índices vetoriais |
| lab em aula | ASSIN 2: avaliar, comparar e buscar, passos 1 a 5 | grupos, um mapa e os números práticos, passos 6 a 8 |
| ao final, você sabe | dizer por que a média perde a ordem e a negação; explicar o que "contextual" quer dizer; codificar, normalizar e comparar frases; medir a concordância com pessoas (Spearman); montar uma busca semântica | ler grupos de embeddings sem confiar neles às cegas; evitar o corte silencioso; estimar a memória e o custo; escolher um modelo para uma língua e uma tarefa |
Os dois labs usam o mesmo notebook do lab, para abrir no Colab (File → Upload notebook) ou no Jupyter: a parte fundamental vai do passo 1 ao 5; a avançada, do 6 ao 8. No Colab, rode !pip install sentence-transformers na primeira célula.
Abordagem fundamental
Uma pergunta guia esta parte: como transformar uma frase inteira num vetor, de modo que o cosseno entre duas frases acompanhe o quanto seus significados se parecem? A resposta óbvia, tirar a média dos vetores das palavras, é construída à mão e suas falhas são medidas; os embeddings contextuais e o Sentence-BERT corrigem a maioria delas e a busca semântica mostra para que servem os vetores.
Esta parte segue um caminho em quatro etapas, desenhado abaixo: 1. tirar a média das palavras, o vetor de frase mais simples, e o que ele perde; 2. palavras em contexto, em que um Transformer dá a cada palavra um vetor que depende da frase; 3. um vetor por frase, com o Sentence-BERT, comparado ao TF-IDF e à média, e em outras línguas; 4. buscar, a busca semântica como vizinhos mais próximos. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Média das palavrasmédia dos vetores GloVe; ordem e negação somem
- Palavras em contextoTransformers: uma palavra, vários vetores
- Um vetor por fraseSentence-BERT contra TF-IDF e média; outras línguas
- Buscarbusca semântica é k vizinhos mais próximos
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. Dos vetores de palavras a um vetor de frase
A média, à mão
Etapa 1. Uma frase é uma sequência de palavras e cada palavra tem um vetor, então o vetor de frase óbvio é a média dos vetores das palavras. Com os vetores GloVe da página anterior (em inglês):
import re
import numpy as np
import pandas as pd
import gensim.downloader as api

glove = api.load('glove-wiki-gigaword-50')          # os vetores de palavras da página anterior

def words_of(text):
    return [w for w in re.findall(r"[a-z]+", text.lower()) if w in glove.key_to_index]

def avg_vector(text):
    return np.mean([glove[w] for w in words_of(text)], axis=0)

s = "the movie was great"
for w in words_of(s):
    print(f"{w:6s}", glove[w][:4].round(3), '...')
print('mean  ', avg_vector(s)[:4].round(3), '...  <- one vector for the sentence')
the    [ 0.418  0.25  -0.412  0.122] ...
movie  [ 0.308  0.172 -0.233  0.023] ...
was    [ 0.087 -0.194 -0.243 -0.334] ...
great  [-0.027  1.336 -1.028 -0.373] ...
mean   [ 0.197  0.391 -0.479 -0.141] ...  <- one vector for the sentence
Confira a primeira coluna com uma calculadora: \((0{,}418 + 0{,}308 + 0{,}087 - 0{,}027) / 4 = 0{,}1965\), impresso como 0.197. Cada uma das 50 coordenadas é calculada do mesmo jeito; a frase ganha um vetor do mesmo tamanho que o de uma palavra. Não custa nada, não exige treino e funciona para qualquer frase cujas palavras estejam no vocabulário.
O que a média perde
def cos(u, v):
    return float(u @ v / (np.linalg.norm(u) * np.linalg.norm(v)))

for a, b in [("the dog bit the man", "the man bit the dog"),
             ("the movie was good", "the movie was not good"),
             ("the movie was great", "the film was excellent"),
             ("the stock market fell sharply today", "my cat likes to sleep on the couch")]:
    print(f"{cos(avg_vector(a), avg_vector(b)):.2f}   {a}  /  {b}")
1.00   the dog bit the man  /  the man bit the dog
0.99   the movie was good  /  the movie was not good
0.96   the movie was great  /  the film was excellent
0.66   the stock market fell sharply today  /  my cat likes to sleep on the couch
Três falhas, todas estruturais:
- A ordem some. "O cachorro mordeu o homem" e "o homem mordeu o cachorro" têm as mesmas palavras, então suas médias são idênticas: cosseno 1,00, exatamente. Uma média, como um bag of words, é cega à ordem.
- A negação quase não conta. "not" é uma palavra em cinco; seu vetor entra na média com os outros: 0,99.
- Tudo parece parecido. Duas frases sem nada em comum, uma sobre a bolsa de valores e outra sobre um gato sonolento, ainda dão 0,66, enquanto uma paráfrase de verdade dá 0,96. As palavras frequentes ("the", "was", "my", "on") puxam toda média para a mesma direção de "inglês médio"; a escala inteira se espreme no terço superior.
Pesar as palavras pelo idf (veja TF-IDF) antes da média ajuda no último problema. Além disso, a média é uma linha de base surpreendentemente forte para agrupar textos por assunto. Mas nada feito depois de as palavras serem consultadas corrige os dois primeiros: o vetor de cada palavra foi fixado antes de ela encontrar a frase.
2. Embeddings contextuais
Transformers, em um parágrafo
Etapa 2. Um Transformer (Vaswani et al., 2017) é uma rede neural que lê a frase inteira de uma vez. Primeiro ela corta o texto em tokens de subpalavra de um vocabulário fixo de cerca de 30 mil pedaços (assim, nenhuma palavra fica fora do vocabulário) e dá a cada token um vetor inicial. Depois, em cada uma de suas camadas, o vetor de cada token é recalculado como uma mistura ponderada dos vetores de todos os tokens da frase, com pesos que a própria rede calcula a partir dos tokens (o mecanismo se chama atenção). Depois de algumas camadas, o vetor de "bank" absorveu informação de "river" ou de "loan", conforme o que estiver na frase. O BERT (Devlin et al., 2019) é um Transformer treinado em bilhões de palavras para adivinhar palavras escondidas pelo contexto; ele produz um vetor contextual por token. Como essas redes são construídas e treinadas é assunto de Redes Neurais e da disciplina de Deep Learning; aqui elas são usadas como caixa-preta que transforma texto em vetores.
Uma palavra, vários vetores
O sentence-transformers carrega uma rede dessas. O pequeno modelo em inglês all-MiniLM-L6-v2 (6 camadas) mostra o tokenizador e, com output_value='token_embeddings', o vetor de cada token. Tome o vetor do token "bank" em seis frases, três sobre rios (margem) e três sobre dinheiro (banco):
from sentence_transformers import SentenceTransformer

model = SentenceTransformer('all-MiniLM-L6-v2')      # ~90 MB, baixado uma vez
print(model.tokenizer.tokenize("Embeddings are unbelievably useful"))

bank = ["we had a picnic on the bank of the river", "the boat drifted toward the muddy bank",
        "fish hide under the grassy bank", "she went to the bank to get a loan",
        "the bank raised its interest rates", "he deposited the check at the bank"]
vecs = []
for s in bank:
    tokens = model.tokenizer.convert_ids_to_tokens(model.tokenizer(s)['input_ids'])
    token_vecs = model.encode(s, output_value='token_embeddings')     # um vetor por token
    vecs.append(np.asarray(token_vecs[tokens.index('bank')].cpu()))
V = np.array(vecs) / np.linalg.norm(vecs, axis=1, keepdims=True)
labels = ['river 1', 'river 2', 'river 3', 'money 4', 'money 5', 'money 6']
print(pd.DataFrame(V @ V.T, index=labels, columns=labels).round(2))
['em', '##bed', '##ding', '##s', 'are', 'un', '##bel', '##ie', '##va', '##bly', 'useful']
         river 1  river 2  river 3  money 4  money 5  money 6
river 1     1.00     0.83     0.86     0.76     0.76     0.76
river 2     0.83     1.00     0.84     0.72     0.72     0.73
river 3     0.86     0.84     1.00     0.72     0.73     0.71
money 4     0.76     0.72     0.72     1.00     0.88     0.86
money 5     0.76     0.72     0.73     0.88     1.00     0.82
money 6     0.76     0.73     0.71     0.86     0.82     1.00
A primeira linha mostra o tokenizador em ação: "embeddings" vira em + ##bed + ##ding + ##s e "unbelievably" vira cinco pedaços (## marca um pedaço que continua uma palavra). O que importa é a matriz. No GloVe, "bank" tem um só vetor e as 36 células seriam 1,00. Aqui todo "bank" de rio fica mais perto dos outros "bank" de rio (0,83 a 0,86) do que de qualquer "bank" de dinheiro (0,71 a 0,76); os de dinheiro, por sua vez, ficam mais perto entre si (0,82 a 0,88). O mesmo token recebe um vetor diferente em cada frase e a diferença acompanha o sentido. É isso que "contextual" quer dizer; é exatamente o que supera o limite da página anterior.
3. Sentence-BERT
Treinado para comparar frases
Etapa 3. Um modelo contextual dá um vetor por token. Para ter um por frase, o passo usual é o mean pooling: tirar a média dos vetores dos tokens, como fizemos com os vetores GloVe, só que agora cada vetor de token já carrega seu contexto. O BERT em si não foi treinado para isso: o cosseno entre médias de vetores do BERT acompanha mal o significado. O Sentence-BERT (Reimers & Gurevych, 2019) acrescenta uma segunda etapa de treino: passar duas frases pela mesma rede, resumir cada uma num vetor e ajustar a rede para que o cosseno seja alto para pares que significam a mesma coisa e baixo para pares que não significam, ao longo de centenas de milhares (em modelos mais recentes, mais de um bilhão) de exemplos rotulados ou naturalmente pareados.
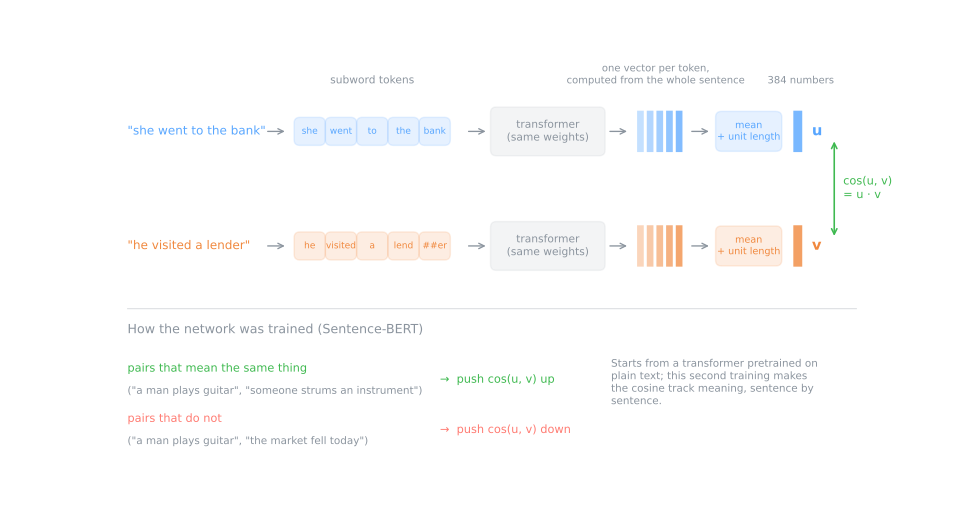
Como cada frase é codificada separadamente (um bi-encoder), uma coleção pode ser codificada uma vez e guardada; comparar uma frase nova com um milhão de frases guardadas vira um único produto de matrizes. É isso que torna a busca semântica viável.
Usando o sentence-transformers
O all-MiniLM-L6-v2, carregado acima, é um modelo Sentence-BERT: encode devolve um vetor por texto, já resumido.
E = model.encode(["the movie was great", "the film was excellent", "the stock market fell sharply today"],
                 normalize_embeddings=True)
print(E.shape, '· length of each row:', np.linalg.norm(E, axis=1).round(3))
print(E[0, :6].round(3), '...')
print((E @ E.T).round(2))
print(f"{sum(p.numel() for p in model.parameters()):,} parameters · reads at most {model.max_seq_length} tokens")
(3, 384) · length of each row: [1. 1. 1.]
[-0.135  0.066 -0.065 -0.011 -0.017  0.013] ...
[[1.   0.88 0.04]
 [0.88 1.   0.04]
 [0.04 0.04 1.  ]]
22,713,216 parameters · reads at most 256 tokens
Como ler:
- Cada texto vira 384 números. Nenhum deles significa algo sozinho; só as distâncias têm significado.
normalize_embeddings=Truedá comprimento 1 a cada linha, então o produtoE @ E.Té a matriz de cossenos. Normalize sempre que for comparar vetores; isso também faz a distância euclidiana e o cosseno ordenarem os vizinhos do mesmo jeito.- As duas paráfrases dão 0,88, com só "the" e "was" em comum; a frase da bolsa dá 0,04 com as duas. Compare com as médias GloVe acima (0,96 contra 0,66): agora a escala é usada de baixo a cima.
- 22,7 milhões de parâmetros, 256 tokens. O modelo é pequeno para os padrões atuais (cerca de 90 MB) e lê no máximo 256 tokens; o que passar disso é cortado, como mostram as notas práticas da parte avançada.
Três representações, os mesmos pares
TF-IDF, média de vetores GloVe e Sentence-BERT em oito pares escolhidos para testar uma propriedade cada. O TF-IDF é ajustado nas 16 frases da tabela:
from sklearn.feature_extraction.text import TfidfVectorizer

pairs = {'paraphrase':               ("the movie was great", "the film was excellent"),
         'paraphrase, other words':  ("a man is playing a guitar", "someone is strumming an instrument"),
         'same need, other words':   ("how do I reset my password", "I forgot my login credentials"),
         'negation':                 ("the movie was good", "the movie was not good"),
         'word order':               ("the dog bit the man", "the man bit the dog"),
         'bank: river vs money':     ("she sat on the river bank", "she went to the bank to get a loan"),
         'apple: company vs fruit':  ("apple released a new phone", "i ate an apple and a banana"),
         'unrelated':                ("the stock market fell sharply today", "my cat likes to sleep on the couch")}
tfidf = TfidfVectorizer().fit([s for pair in pairs.values() for s in pair])
rows = {}
for name, (a, b) in pairs.items():
    t = tfidf.transform([a, b]).toarray()
    e = model.encode([a, b], normalize_embeddings=True)
    rows[name] = {'TF-IDF': cos(t[0], t[1]), 'avg GloVe': cos(avg_vector(a), avg_vector(b)),
                  'SBERT': float(e[0] @ e[1])}
print(pd.DataFrame(rows).T.round(2))
                         TF-IDF  avg GloVe  SBERT
paraphrase                 0.28       0.96   0.88
paraphrase, other words    0.19       0.92   0.56
same need, other words     0.15       0.92   0.68
negation                   0.82       0.99   0.82
word order                 1.00       1.00   0.98
bank: river vs money       0.29       0.92   0.60
apple: company vs fruit    0.18       0.87   0.23
unrelated                  0.04       0.66   0.02
Leia as colunas uma de cada vez, depois as linhas.
- O TF-IDF mede palavras em comum. As paráfrases sem palavras de conteúdo em comum dão de 0,15 a 0,28, não muito acima do par sem relação (0,04), enquanto a negação (0,82) e a troca de ordem (1,00) parecem quase idênticas.
- A média GloVe diz "parecido" para tudo: 0,66 para o par sem relação, de 0,87 a 1,00 para o resto. Ela até põe o par sem relação por último, mas sua faixa é tão estreita que nenhum limiar separa relacionado de não relacionado com confiança.
- O Sentence-BERT usa a escala inteira: 0,02 para o par sem relação, 0,88 para a paráfrase, 0,56 e 0,68 para paráfrases sem nenhuma palavra em comum. E as linhas de polissemia se separam: "apple" a empresa e "apple" a fruta dão 0,23, porque cada "apple" foi lida na sua frase.
- O que nenhum deles resolve. A negação continua alta (0,82): "o filme foi bom" e "o filme não foi bom" falam do mesmo filme e da mesma qualidade; um modelo treinado com a pergunta "estas duas frases falam da mesma coisa?" responde que sim. A ordem quase não muda nada (0,98): o mean pooling dilui quem fez o quê a quem, mesmo quando cada vetor de token viu seu contexto. Se sua tarefa depende de negação ou de papéis (sentimento, contradições, quem é o responsável), verifique isso explicitamente.
A visão geral faz o mesmo tipo de comparação com frases em português e o modelo multilíngue, com as mesmas conclusões.
Outras línguas
O all-MiniLM-L6-v2 foi treinado em inglês. Um modelo multilíngue, o paraphrase-multilingual-MiniLM-L12-v2, foi treinado com o método de Reimers & Gurevych (2020): uma rede aluna aprende a pôr uma frase e suas traduções no ponto em que um modelo professor em inglês põe a frase em inglês, para mais de 50 línguas. A diferença, em português:
multi = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2')   # mais de 50 línguas, ~470 MB
pt_pairs = [("o filme foi ótimo", "o longa foi excelente"),              # paráfrase
            ("esqueci minha senha", "não lembro a senha da conta"),       # paráfrase
            ("o filme foi ótimo", "the movie was great"),                 # tradução
            ("o filme foi ótimo", "a bolsa de valores caiu hoje")]        # sem relação
for a, b in pt_pairs:
    e_en = model.encode([a, b], normalize_embeddings=True)
    e_mu = multi.encode([a, b], normalize_embeddings=True)
    print(f"English-only {e_en[0] @ e_en[1]:.2f} · multilingual {e_mu[0] @ e_mu[1]:.2f}   {a} / {b}")
English-only 0.65 · multilingual 0.66   o filme foi ótimo / o longa foi excelente
English-only 0.40 · multilingual 0.81   esqueci minha senha / não lembro a senha da conta
English-only 0.08 · multilingual 0.98   o filme foi ótimo / the movie was great
English-only 0.40 · multilingual -0.02   o filme foi ótimo / a bolsa de valores caiu hoje
O modelo em inglês não falha de forma escandalosa: ele devolve números também para o português, porque seus pedaços de subpalavra soletram qualquer coisa. Mas veja: "esqueci minha senha" / "não lembro a senha da conta" dá 0,40; "o filme foi ótimo" / "a bolsa de valores caiu hoje", que não têm nada em comum, também dá 0,40. Um modelo que dá a mesma nota a uma paráfrase e a um par sem relação é inútil para busca nessa língua. O modelo multilíngue os separa (0,81 contra −0,02) e põe uma frase em português e sua tradução em inglês a 0,98, então uma consulta em português acha documentos em inglês. Escolha um modelo treinado na sua língua; o lab mede isso em 2.448 pares avaliados por pessoas.
4. Busca semântica é k vizinhos mais próximos
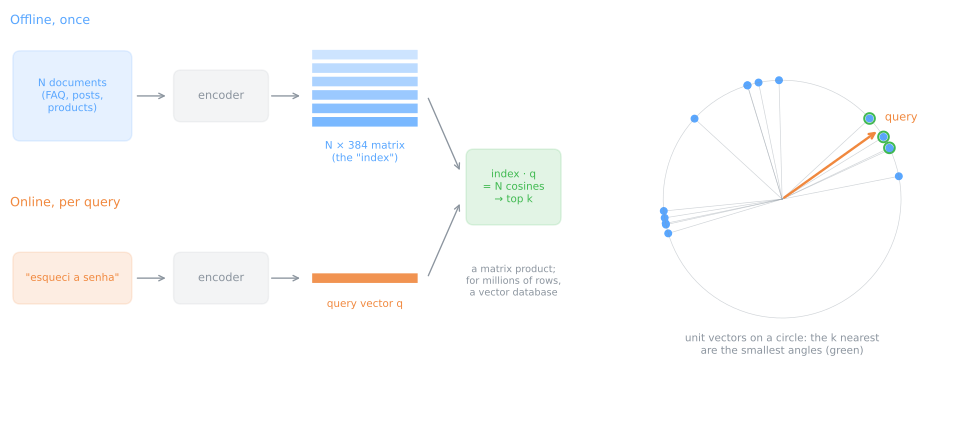
Etapa 4. O uso mais comum de sentence embeddings é a busca semântica: codificar uma coleção uma vez, codificar cada consulta, devolver os documentos cujos vetores estão mais próximos. É a mesma busca de vizinhos mais próximos que está por trás do classificador k-NN, uma aula que vem mais adiante na disciplina; aqui ela é usada só para achar vizinhos, sem rótulos e sem predição. O NearestNeighbors do scikit-learn com metric='cosine' faz isso (ele devolve a distância de cosseno, \(1 - \cos\)):
from sklearn.neighbors import NearestNeighbors

faq = ["Como faço para trocar a senha da minha conta?",
       "Qual é o prazo de entrega para o Nordeste?",
       "Posso devolver um produto depois de usado?",
       "Quais são as formas de pagamento aceitas?",
       "Como rastrear o meu pedido?",
       "O produto tem garantia contra defeitos de fábrica?",
       "Como emitir a segunda via da nota fiscal?",
       "Como cancelar uma compra que ainda não foi enviada?"]
E_faq = multi.encode(faq, normalize_embeddings=True)            # codifica a coleção uma vez
index = NearestNeighbors(n_neighbors=2, metric='cosine').fit(E_faq)

queries = ["esqueci minha senha", "onde está minha encomenda?", "dá pra pagar com pix?",
           "desisti da compra", "o celular veio com defeito", "I need a copy of my invoice"]
dist, ids = index.kneighbors(multi.encode(queries, normalize_embeddings=True))
for q, d, i in zip(queries, dist, ids):
    print(f"{q}\n   1st {1 - d[0]:.2f} {faq[i[0]]}\n   2nd {1 - d[1]:.2f} {faq[i[1]]}")
esqueci minha senha
   1st 0.68 Como faço para trocar a senha da minha conta?
   2nd 0.33 Como rastrear o meu pedido?
onde está minha encomenda?
   1st 0.60 Como rastrear o meu pedido?
   2nd 0.40 Qual é o prazo de entrega para o Nordeste?
dá pra pagar com pix?
   1st 0.42 Quais são as formas de pagamento aceitas?
   2nd 0.32 Como faço para trocar a senha da minha conta?
desisti da compra
   1st 0.62 Como cancelar uma compra que ainda não foi enviada?
   2nd 0.43 Posso devolver um produto depois de usado?
o celular veio com defeito
   1st 0.26 Posso devolver um produto depois de usado?
   2nd 0.24 O produto tem garantia contra defeitos de fábrica?
I need a copy of my invoice
   1st 0.43 Como faço para trocar a senha da minha conta?
   2nd 0.40 Como rastrear o meu pedido?
Quatro das seis consultas recebem a resposta certa em primeiro lugar, embora "encomenda" não seja "pedido" e "desisti" não seja "cancelar". Vale a pena examinar os dois erros:
- "o celular veio com defeito": a primeira escolha do modelo é a política de devolução e a pergunta sobre garantia vem em segundo. As duas respostas são defensáveis e as notas são baixas e próximas (0,26 e 0,24): o modelo está inseguro e um sistema deveria dizer isso em vez de responder.
- "I need a copy of my invoice": a entrada certa é "segunda via da nota fiscal", uma expressão brasileira que o modelo não liga a "copy of my invoice". É em expressões idiomáticas e em jargão de domínio que embeddings de uso geral falham.
O simulador abaixo torna palpável a comparação com o TF-IDF. Ele guarda 40 frases em português e inglês (conta, entrega, pagamento, reembolso, três tipos de banco, clima, culinária, futebol) e 10 consultas, com um ✓ nas respostas que uma pessoa aceitaria. Os embeddings das frases foram calculados antes com o modelo multilíngue; o ranking TF-IDF é calculado no seu navegador. Você também pode digitar sua própria consulta, que só o TF-IDF consegue processar sem a rede neural.
Nas dez consultas, os embeddings põem 15 das 19 frases relevantes no seu top 3; o TF-IDF, 6. A consulta "erro 402" é a exceção que vale lembrar: o token raro "402" dá ao TF-IDF uma vitória clara, enquanto o embedding põe "erro 404" em primeiro. A visão geral mede esse efeito com códigos de erro; buscadores em produção combinam os dois rankings (busca híbrida). Os dados do simulador foram produzidos por um script curto ao lado desta página, que também imprime o ranking TF-IDF de referência calculado com o scikit-learn; os embeddings são guardados como inteiros de 8 bits, o que não muda nenhum cosseno em mais de 0,002.
5. Resumo: vetores de frase em cinco linhas
- A média de vetores de palavras é grátis e cega. A ordem das palavras some por completo, a negação quase não aparece e toda frase parece com toda outra.
- Modelos contextuais corrigem os vetores de palavras. Um Transformer recalcula o vetor de cada token a partir da frase inteira; assim, "bank" ao lado de um rio e "bank" ao lado de um empréstimo ganham vetores diferentes.
- O Sentence-BERT é treinado para comparar. Ele junta os vetores dos tokens num só, treinado para que paráfrases tenham nota alta e pares sem relação nota baixa, e usa a escala inteira do cosseno.
- Escolha um modelo treinado na sua língua. Um modelo só em inglês deu a mesma nota a uma paráfrase e a um par sem relação em português.
- Busca semântica é vizinhos mais próximos. Codifique a coleção uma vez, normalize e ordene pelo cosseno; desconfie de notas baixas e próximas e dos tokens raros exatos, em que o TF-IDF ainda vence.
| o que você vê | o que está acontecendo | o que fazer |
|---|---|---|
| todo par de frases pela média fica entre 0,66 e 1,00 | as palavras frequentes puxam toda média para a mesma direção | usar um modelo de frases ou, no mínimo, pesar pelo idf |
| "not good" tem nota tão alta quanto "good" | os modelos medem "sobre a mesma coisa", não concordância | verificar a negação à parte |
| um modelo dá a mesma nota a paráfrases e a pares sem relação em português | foi treinado em outra língua | um modelo multilíngue ou de português |
| a primeira resposta de uma busca tem nota baixa, perto da segunda | o modelo está inseguro | dizer isso em vez de responder |
Lab fundamental — similaridade de frases em português
O problema. Os sentence embeddings concordam com as pessoas? O ASSIN 2 (Real, Fonseca & Gonçalo Oliveira, 2020) é um benchmark em português do Brasil: pares de frases, cada um avaliado por anotadores humanos quanto ao grau de relação, de 1 (sem relação) a 5 (mesmo significado). Seu conjunto de teste tem 2.448 pares. Esta parte dá uma nota a cada par com TF-IDF e com dois modelos do sentence-transformers, mede o quanto cada nota acompanha a humana, olha onde discordam e busca nas 3.659 frases distintas; agrupá-las, desenhar um mapa e os números práticos ficam para o lab avançado.
Como fazer este lab em aula (cerca de 35 min, em duplas)
- Baixe o notebook do lab e abra no Colab (File → Upload notebook) ou no Jupyter; no Colab, rode
!pip install sentence-transformersna primeira célula. Rode as células em ordem, numa mesma sessão. Depois do download dos modelos (cerca de 90 MB e 470 MB), o lab calcula por cerca de um minuto na CPU de um notebook, a maior parte codificando as frases duas vezes; um ambiente de GPU no Colab faz isso em poucos segundos. - Este lab corresponde aos passos 1 a 5 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 6.
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 e 2 e a primeira simulação em 12 min; passo 3 e a segunda simulação em 10 min; passos 4 e 5 em 13 min.
Passo 1 — carregar os pares
Preveja. As pessoas deram a cada par uma nota de 1 (sem relação) a 5 (mesmo significado). Você espera a média perto do meio da escala ou pendendo para um lado? Que nota as pessoas dariam a uma frase e à sua negação?
# No Colab, rode uma vez:  !pip install sentence-transformers
import numpy as np
import pandas as pd

url = 'https://huggingface.co/api/datasets/nilc-nlp/assin2/parquet/default/test/0.parquet'
pairs = pd.read_parquet(url)[['premise', 'hypothesis', 'relatedness_score']]
pairs.columns = ['A', 'B', 'human']
sentences = list(dict.fromkeys(list(pairs.A) + list(pairs.B)))      # únicas, em ordem
pos = {s: i for i, s in enumerate(sentences)}

print(len(pairs), 'pairs ·', len(sentences), 'distinct sentences')
print(pairs.human.describe().round(2).to_string())
with pd.option_context('display.max_colwidth', 60, 'display.width', 200):
    print(pairs.iloc[[1, 8, 53, 1906]].to_string())
2448 pairs · 3659 distinct sentences
count    2448.00
mean        3.57
std         1.00
min         1.00
25%         3.00
50%         3.75
75%         4.25
max         5.00
                                                        A                                             B  human
1                  O cara está fazendo exercícios no chão               Um cara está fazendo exercícios   3.75
8                        Uma mulher está andando a cavalo       Não tem nenhuma mulher andando a cavalo   3.30
53                       Uma mulher está andando a cavalo  Alguma coisa está sendo frita por uma mulher   1.10
1906  Algumas cebolas estão sendo cortadas por uma pessoa                      Um hamster está cantando   1.00
Como ler. São 2.448 pares montados a partir de 3.659 frases distintas, então a maioria das frases aparece em mais de um par. A nota humana tem média 3,57 e metade dos pares está em 3,75 ou mais: o conjunto pende para pares relacionados. Os quatro exemplos cobrem a faixa: uma quase paráfrase (3,75), uma negação com nota 3,3 (um par pode ser relacionado sem significar a mesma coisa: o ASSIN 2 pergunta sobre relação) e dois pares sem relação, com 1,1 e 1,0. As frases são descrições curtas de cenas do dia a dia (pessoas cozinhando, cachorros correndo, homens tocando violão), adaptadas do SICK-BR, uma versão em português do conjunto inglês SICK.
Passo 2 — o TF-IDF como linha de base
Preveja. O TF-IDF só enxerga palavras em comum. Neste conjunto, o cosseno dele vai acompanhar bem as notas humanas, mal ou nada?
from sklearn.feature_extraction.text import TfidfVectorizer

tfidf = TfidfVectorizer().fit(sentences)
T = tfidf.transform(sentences)                      # as linhas já têm comprimento 1
ia, ib = pairs.A.map(pos).to_numpy(), pairs.B.map(pos).to_numpy()
pairs['TF-IDF'] = np.asarray(T[ia].multiply(T[ib]).sum(axis=1)).ravel()   # produto linha a linha = cosseno
print(f"Spearman(TF-IDF cosine, human score) = {pairs['TF-IDF'].corr(pairs.human, method='spearman'):.3f}")
Como ler. Cada frase é codificada uma vez e cada par é buscado pela posição; o produto elemento a elemento somado em cada linha é o cosseno, já que as linhas do TF-IDF têm comprimento 1. A nota é comparada com a humana pela correlação de Spearman da EDA: ela verifica se os pares ficam na mesma ordem (o que importa para busca) e ignora o fato de um cosseno e uma escala de 1 a 5 estarem em unidades diferentes. 0,547 é uma concordância real, mas modesta: palavras em comum são uma aproximação razoável de relação neste conjunto, porque pares relacionados muitas vezes são reescritas da mesma descrição.
Simulação: TF-IDF com pedaços de palavras. O passo 3 vai afirmar que, em português, o modelo só em inglês enxerga sobretudo pedaços de subpalavras em comum. Dê ao TF-IDF a mesma vantagem: ajuste-o de novo com analyzer='char_wb', ngram_range=(3, 5), que conta pedaços de 3 a 5 letras dentro de cada palavra, e calcule o Spearman dele contra as notas humanas. Ele vence o TF-IDF de palavras? Guarde o número para o passo 3.
Solução
chars = TfidfVectorizer(analyzer='char_wb', ngram_range=(3, 5)).fit(sentences)   # pedaços de palavras, não palavras
Tc = chars.transform(sentences)
pairs['TF-IDF chars'] = np.asarray(Tc[ia].multiply(Tc[ib]).sum(axis=1)).ravel()
print(f"{Tc.shape[1]:,} character n-grams (against {T.shape[1]:,} words)")
for col in ['TF-IDF', 'TF-IDF chars']:
    print(f"Spearman({col}, human) = {pairs[col].corr(pairs.human, method='spearman'):.3f}")
13,607 character n-grams (against 1,953 words)
Spearman(TF-IDF, human) = 0.547
Spearman(TF-IDF chars, human) = 0.573
Os pedaços de caracteres sobem o TF-IDF de 0,547 para 0,573: fritando e fritos agora dividem fri e frit, então formas flexionadas contam como coincidência. Guarde o número: no passo 3, o modelo de frases só em inglês dá 0,564, abaixo deste TF-IDF de pedaços. Numa língua em que não foi treinada, uma rede de 22 milhões de parâmetros não faz melhor que contar pedaços de palavras, que é exatamente o que o tokenizador dela lhe dá.
Passo 3 — dois modelos avaliados contra julgamentos humanos
Preveja. Um modelo só em inglês e um multilíngue, ambos com 384 números por frase, em português. Qual vai concordar mais com as pessoas? O de inglês vai vencer o TF-IDF?
from sentence_transformers import SentenceTransformer

models, emb = {}, {}
for name in ['all-MiniLM-L6-v2', 'paraphrase-multilingual-MiniLM-L12-v2']:
    models[name] = SentenceTransformer(name)
    emb[name] = models[name].encode(sentences, batch_size=64, normalize_embeddings=True)
    pairs[name] = np.sum(emb[name][ia] * emb[name][ib], axis=1)        # linhas unitárias: produto = cosseno
    print(f"{name:38s} {emb[name].shape}  Spearman {pairs[name].corr(pairs.human, method='spearman'):.3f}")
all-MiniLM-L6-v2                       (3659, 384)  Spearman 0.564
paraphrase-multilingual-MiniLM-L12-v2  (3659, 384)  Spearman 0.715
Como ler. O modelo só em inglês chega a 0,564, mal acima do TF-IDF (0,547): em português, ele enxerga sobretudo pedaços de subpalavra em comum, que é o que o TF-IDF enxerga. O modelo multilíngue chega a 0,715: mesma família de arquitetura, os mesmos 384 números, mas treinado com o português entre mais de 50 línguas. É o conselho "escolha um modelo para a sua língua", medido em 2.448 julgamentos humanos. E nenhum dos dois foi treinado no ASSIN 2: esta é a nota que você obtém usando o modelo pronto.
Simulação: quanto vem do contexto? O modelo multilíngue começa buscando um vetor fixo por token, a sua camada de entrada, e depois as camadas do Transformer os misturam com o resto da frase. Pule as camadas: tire a média dos vetores de entrada dos tokens de cada frase (multi[0].auto_model.embeddings.word_embeddings), como a seção 1 tirou a média dos vetores GloVe, e calcule o Spearman desse vetor de frase. Quanto sobra dos 0,715?
Solução
multi = models['paraphrase-multilingual-MiniLM-L12-v2']
table = multi[0].auto_model.embeddings.word_embeddings.weight.detach().cpu().numpy()   # uma linha por token, sem contexto

def static_vector(s):
    ids = multi.tokenizer(s, add_special_tokens=False)['input_ids']
    return table[ids].mean(axis=0)                   # a média dos vetores de entrada: nenhuma camada do Transformer

St = np.array([static_vector(s) for s in sentences])
St /= np.linalg.norm(St, axis=1, keepdims=True)
pairs['static'] = np.sum(St[ia] * St[ib], axis=1)
print(f"token table {table.shape}")
for col in ['TF-IDF', 'static', 'paraphrase-multilingual-MiniLM-L12-v2']:
    print(f"Spearman({col}, human) = {pairs[col].corr(pairs.human, method='spearman'):.3f}")
token table (250037, 384)
Spearman(TF-IDF, human) = 0.547
Spearman(static, human) = 0.518
Spearman(paraphrase-multilingual-MiniLM-L12-v2, human) = 0.715
Sem as camadas do Transformer, o mesmo modelo cai de 0,715 para 0,518, abaixo até do TF-IDF (0,547). Os 250.037 vetores de entrada são exatamente o tipo de vetor estático que a seção 1 promediou, um por token qualquer que seja a frase, e a média deles herda todas as falhas medidas ali. Então quase toda a vantagem do modelo, cerca de 0,2 de Spearman, vem de calcular o vetor de cada token no contexto.
Passo 4 — onde TF-IDF e embeddings discordam
Preveja. Nos pares que as pessoas chamam de paráfrase, mas que têm poucas palavras em comum, qual método vai dar a nota mais alta? E nas negações ("Não tem nenhum..."), qual vai se enganar mais com as palavras em comum?
E = emb['paraphrase-multilingual-MiniLM-L12-v2']
pairs['emb'] = pairs['paraphrase-multilingual-MiniLM-L12-v2']
cols = ['A', 'B', 'human', 'TF-IDF', 'emb']
with pd.option_context('display.max_colwidth', 60, 'display.width', 250):
    print('TF-IDF low, humans high (paraphrases with other words):')
    print(pairs[(pairs.human >= 4.5)].nsmallest(3, 'TF-IDF')[cols].round(2).to_string())
    print('\nnegations:')
    print(pairs[pairs.B.str.startswith('Não tem nenhum')].head(4)[cols].round(2).to_string())
TF-IDF low, humans high (paraphrases with other words):
                                            A                                                    B  human  TF-IDF   emb
1577  Uma senhora está fritando alguma comida  Alguns alimentos estão sendo fritos por uma senhora   4.50    0.11  0.84
2163           Está chovendo em um homem a pé                       Um homem está andando na chuva   4.90    0.13  0.90
1376     Um cara está conversando ao telefone                     Um cara está dando um telefonema   4.75    0.14  0.94

negations:
                                                       A                                                            B  human  TF-IDF   emb
8                       Uma mulher está andando a cavalo                      Não tem nenhuma mulher andando a cavalo    3.3    0.67  0.56
22  Um cachorro está correndo para cima do morro gramado  Não tem nenhum cachorro correndo para cima do morro gramado    3.0    0.88  0.60
38          Um homem está fatiando uma batata em pedaços          Não tem nenhum homem fatiando uma batata em pedaços    3.5    0.82  0.62
49                       Um homem está fatiando um peixe                       Não tem nenhum homem cortando um peixe    2.8    0.51  0.52
Como ler. A primeira tabela mostra onde os embeddings compensam o seu custo: "uma senhora está fritando alguma comida" e "alguns alimentos estão sendo fritos por uma senhora" (4,50 das pessoas) quase não compartilham formas de palavra (fritando/fritos, comida/alimentos), então o TF-IDF dá 0,11, enquanto o embedding dá 0,84. O mesmo vale para "está chovendo em um homem a pé" / "um homem está andando na chuva" (0,13 contra 0,90). A segunda tabela mostra as negações do ASSIN 2 ("Não tem nenhum..."). As pessoas dão de 2,8 a 3,5, relacionadas mas não equivalentes; o TF-IDF dá notas altas (até 0,88) porque quase toda palavra é compartilhada; o embedding fica mais baixo (de 0,52 a 0,62), mas ainda bem acima dos pares sem relação. Nenhuma das representações entende negação; o embedding só se deixa enganar menos pelas palavras em comum.
Passo 5 — busca semântica em 3.659 frases
Preveja. A coleção está em português. Para a consulta em inglês "a person is playing music", o que o TF-IDF vai devolver? E o embedding multilíngue?
from sklearn.neighbors import NearestNeighbors

model = models['paraphrase-multilingual-MiniLM-L12-v2']
index = NearestNeighbors(n_neighbors=3, metric='cosine').fit(E)
queries = ['alguém está preparando comida', 'um animal correndo na areia', 'a person is playing music']
dist, ids = index.kneighbors(model.encode(queries, normalize_embeddings=True))
tf_scores = (tfidf.transform(queries) @ T.T).toarray()
for q, d, i, t in zip(queries, dist, ids, tf_scores):
    print(f"\n{q}")
    for dj, j in zip(d, i):
        print(f"   emb    {1 - dj:.2f}  {sentences[j]}")
    j = int(np.argmax(t))
    print(f"   TF-IDF {t[j]:.2f}  {sentences[j]}")
alguém está preparando comida
   emb    0.94  Uma pessoa está cozinhando alguma comida
   emb    0.92  Alguém está fervendo alimento em uma panela
   emb    0.91  Alguém está cozinhando o quiabo em uma panela
   TF-IDF 0.69  Um chefe está preparando comida

um animal correndo na areia
   emb    0.95  Um animal está correndo por um caminho coberto de areia
   emb    0.82  Um cachorro está correndo na areia e perseguindo uma bola
   emb    0.82  O cachorro pequeno está correndo na areia
   TF-IDF 0.70  Um animal está correndo

a person is playing music
   emb    0.83  Um cara está tocando um instrumento
   emb    0.81  Um cara está tocando o instrumento
   emb    0.79  Uma pessoa está tocando o violão e cantando
   TF-IDF 0.00  O cachorro caramelo está assistindo um cachorro castanho que está nadando em uma lagoa
Como ler. Para "alguém está preparando comida", o embedding devolve três frases sobre cozinhar, nenhuma das quais contém "preparando": "cozinhando alguma comida", "fervendo alimento em uma panela", "cozinhando o quiabo em uma panela". O melhor resultado do TF-IDF, "um chefe está preparando comida", também é bom, porque compartilha as palavras. Para "um animal correndo na areia", o embedding generaliza de "animal" para "cachorro". A consulta em inglês "a person is playing music" é o caso mais claro: o embedding acha homens tocando instrumentos e uma pessoa tocando violão e cantando, tudo em português, enquanto o TF-IDF não compartilha nenhuma palavra com nenhuma frase, dá 0,00 para tudo e devolve a primeira frase da lista, sobre um cachorro olhando outro cachorro.
Para fechar a parte fundamental. Em uma frase cada: (1) por que "the dog bit the man" e "the man bit the dog" ganham exatamente o mesmo vetor médio? (2) O que "contextual" quer dizer e como os seis vetores de "bank" mostraram isso? (3) Por que uma coleção precisa ser codificada com um modelo treinado na sua língua?
Sua vez (fundamental)
Em casa:
- A média, à mão. Tire à mão a média dos vetores GloVe de "the man bit the dog" e de "the dog bit the man" em uma coordenada (use
glove['dog'][0]e companhia). Por que toda coordenada tem de ser idêntica, quaisquer que sejam os vetores? - Vencer o TF-IDF, perder para o TF-IDF. Na tabela das três representações, o TF-IDF dá 0,82 ao par com negação e o SBERT também 0,82. Proponha duas frases em que você espera que o SBERT dê nota muito menor que o TF-IDF e duas em que espera o contrário. Rode-as.
- Conserte o FAQ. A busca no FAQ errou "I need a copy of my invoice". Acrescente uma entrada ao FAQ ou reescreva uma, para que essa consulta a encontre sem estragar as outras cinco. O que isso sugere sobre escrever uma base de conhecimento para busca semântica?
- Um terceiro modelo. Acrescente
'paraphrase-multilingual-mpnet-base-v2'(maior, cerca de 1 GB) à lista do passo 3. O Spearman dele passa de 0,715? Quanto mais demora a codificação? O ganho vale a pena para este conjunto? - Seu próprio buscador. Escreva dez consultas suas (em português e em inglês) e olhe o top 3 do passo 5 para cada uma. Conte as boas respostas dos embeddings e do TF-IDF. Que tipo de consulta cada um trata melhor?
Abordagem avançada
A parte fundamental construiu vetores de frase e buscou com eles. Esta parte olha o que vem depois: agrupar frases sem rótulos e os detalhes que decidem se os embeddings funcionam em produção (normalizar, o limite de tamanho que corta o texto em silêncio, o custo de codificar, a escolha do modelo, índices para milhões de linhas). Os blocos de código continuam os das seções 1 a 4.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. agrupar, frases com k-means; 2. cuidar dos limites, normalizar, codificar uma vez e o limite de tamanho; 3. custo e escolha, quanto os embeddings custam, como escolher um modelo e como escalar. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Agrupark-means em TF-IDF e em embeddings
- Cuidar dos limitesnormalizar, codificar uma vez, o limite de tamanho
- Custo e escolhaparâmetros, memória, escolha do modelo, índices
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
6. Agrupando frases
Etapa 1. Vetores de frases são linhas numéricas comuns, então tudo de agrupamento se aplica. Considere dezesseis manchetes de quatro assuntos (futebol, culinária, economia, clima). Elas são agrupadas com k-means em quatro grupos (uma vez com TF-IDF, outra com embeddings) e avaliadas com o índice de Rand ajustado (ARI) contra os assuntos verdadeiros:
from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score

texts = ["O Flamengo venceu o clássico no Maracanã", "O atacante marcou dois gols no segundo tempo",
         "A seleção perdeu nos pênaltis", "O técnico foi demitido após a derrota",
         "Misture a farinha com os ovos e o leite", "Asse o bolo por quarenta minutos",
         "Tempere o frango com alho e limão", "A receita leva manteiga e açúcar",
         "O banco central subiu a taxa de juros", "A inflação de março ficou acima do esperado",
         "O dólar fechou em queda nesta sexta", "Os investidores venderam ações da Petrobras",
         "Vai chover forte no fim de semana", "A frente fria derrubou as temperaturas",
         "O verão deve ser mais quente que o normal", "Alerta de tempestade para o litoral"]
topic = np.repeat([0, 1, 2, 3], 4)                  # futebol, culinária, economia, clima
X_tfidf = TfidfVectorizer().fit_transform(texts)
X_emb = multi.encode(texts, normalize_embeddings=True)
for name, X in [('TF-IDF', X_tfidf), ('embeddings', X_emb)]:
    labels = KMeans(n_clusters=4, n_init=10, random_state=0).fit_predict(X)
    print(f"{name:10s} ARI {adjusted_rand_score(topic, labels):.2f}   clusters: {labels}")
TF-IDF     ARI 0.02   clusters: [1 1 3 0 2 0 2 0 0 0 0 2 1 0 0 0]
embeddings ARI 0.68   clusters: [2 2 2 2 0 0 0 0 3 3 1 2 1 1 1 1]
Com TF-IDF o ARI é 0,02, nada melhor que o acaso. As manchetes são curtas e as quatro de cada assunto quase não compartilham palavras, então todo vetor TF-IDF é quase ortogonal a todos os outros; o k-means não tem com o que trabalhar: põe nove das dezesseis num mesmo grupo. Com os embeddings o ARI é 0,68. Futebol, culinária e clima saem inteiros; as manchetes de economia se dividem, com "investidores venderam ações da Petrobras" indo para o futebol e "o dólar fechou em queda" indo para o clima. É em textos curtos que os sentence embeddings mais ajudam o agrupamento; Topic Modeling & BERTopic constrói um método inteiro sobre isso: codificar, reduzir com UMAP, agrupar com HDBSCAN.
7. Notas práticas
Normalize, codifique uma vez, cuide do tamanho
Etapa 2. Normalize. Passe normalize_embeddings=True (ou divida cada linha pela sua norma) sempre que for comparar vetores. Assim, o cosseno vira um produto escalar, uma matriz de similaridade inteira vira um E @ E.T e toda ferramenta de vizinhos mais próximos dá o mesmo ranking com distância euclidiana ou de cosseno.
Codifique em lotes, uma vez. model.encode(lista_de_textos, batch_size=64) processa os textos em grupos, o que é muito mais rápido que uma chamada por texto. Codifique a coleção uma vez, salve a matriz (np.save) e depois codifique só os textos novos.
Cuidado com o limite de tamanho. Um modelo lê no máximo max_seq_length tokens e descarta o resto em silêncio:
long_text = " ".join(["The committee discussed the budget for the next fiscal year."] * 30)
changed = long_text + " In the end, the committee decided to close the whole department."
print(len(model.tokenizer.tokenize(long_text)), 'tokens in the long text')
e = model.encode([long_text, changed], normalize_embeddings=True)
print(f"cosine between the text and the text + a decisive last sentence: {e[0] @ e[1]:.4f}")
O texto já tem 330 tokens, mais que os 256 que este modelo lê, então a frase final decisiva ("no fim, o comitê decidiu fechar o departamento inteiro") não muda nada: cosseno 1,0000. Para documentos longos, divida-os em parágrafos ou trechos, codifique cada um e busque nos trechos (ou tire a média dos vetores dos trechos para ter um vetor do documento). O modelo multilíngue é ainda mais restrito: 128 tokens.
Custo, escolha e escala
Etapa 3. Conheça o custo. O all-MiniLM-L6-v2 tem 22,7 milhões de parâmetros; o modelo multilíngue tem 117,7 milhões (lab). Codificar roda a rede neural para cada texto, então leva de segundos a minutos numa CPU para milhares de textos, enquanto o TF-IDF leva uma fração de segundo. Uma GPU acelera isso em uma ordem de grandeza. O armazenamento é de 384 × 4 bytes = 1,5 KB por texto em float32.
Escolha o modelo para a tarefa. Três perguntas: qual língua? (um modelo só em inglês deu a mesma nota a uma paráfrase e a um par sem relação em português); que tipo de texto? (modelos treinados com perguntas e respostas da web são bons para busca; jargão jurídico ou médico pode pedir um modelo de domínio); quanto você pode pagar? (modelos maiores são melhores e mais lentos). O benchmark MTEB (Muennighoff et al., 2023) ranqueia centenas de modelos de embedding em dezenas de tarefas e línguas; use-o para fazer uma lista curta e depois meça numa amostra dos seus próprios dados, como o lab faz.
Escale com um índice. Para alguns milhares de textos, um produto de matrizes é instantâneo. Para milhões, os bancos de dados vetoriais guardam os embeddings em índices de vizinhos aproximados que respondem em milissegundos; eles são a metade de recuperação dos sistemas com LLMs de A Fronteira.
Lab avançado — grupos, mapas e custos
O lab fundamental mediu a concordância com as pessoas e buscou nas frases. Esta parte agrupa as 3.659 frases sem rótulo nenhum, desenha-as num mapa e calcula os números práticos da coleção: tokens, memória e parâmetros.
Como fazer este lab em aula (cerca de 25 min, em duplas)
- Continue no mesmo notebook e na mesma sessão do lab fundamental: os passos abaixo usam
sentences,pairs,ia,ib,Eemodel. - Como antes, responda a cada Preveja com a dupla antes de rodar e tente cada Simulação antes de abrir a solução.
- Ritmo sugerido: passo 6 e a primeira simulação em 10 min; passo 7 em 5 min; passo 8 e a segunda simulação em 10 min.
Passo 6 — agrupar as frases
Preveja. O k-means vai formar 8 grupos sem rótulo nenhum. Eles vão seguir os assuntos das frases (comida, cachorros, bicicletas) ou alguma outra propriedade das frases pode decidir um grupo?
from sklearn.cluster import KMeans

km = KMeans(n_clusters=8, n_init=10, random_state=0).fit(E)
for c in range(8):
    members = np.flatnonzero(km.labels_ == c)
    closest = members[np.argsort(-(E[members] @ km.cluster_centers_[c]))[:3]]
    print(f"cluster {c} ({len(members)} sentences):", ' | '.join(sentences[j] for j in closest))
cluster 0 (844 sentences): Um homem está cuspindo | Um cara está do lado de fora e está arremessando lâminas em um alvo próximo | Um cara está do lado de fora e está lançando lâminas em um alvo que está próximo
cluster 1 (517 sentences): Uma cebola está sendo fatiada por uma senhora | Uma pessoa está fritando alguma comida | Uma pessoa está fritando alguma comida na panela
cluster 2 (461 sentences): O cachorro com pelagem castanha está brincando ao ar livre | O cachorro castanho está brincando | Um cachorro com pelagem preta está parado no raso
cluster 3 (569 sentences): Um homem e uma mulher estão do lado de fora e estão vestindo camisas coloridas claras | Um homem com um chapéu branco e uma camisa marrom está atrás de uma mulher de vermelho e está olhando para a esquerda | Um homem de chapéu branco e camiseta marrom está atrás de uma mulher de vermelho e está olhando para o lado
cluster 4 (170 sentences): Uma bicicleta está sendo pedalada por uma pessoa | Uma pessoa está andando de bicicleta | Um cara jovem está empurrando uma bicicleta de motocross para cima de um morro de terra
cluster 5 (557 sentences): Uma criança jovem está brincando com uma motinho | Uma criança de roupas de cor clara está parada com seus braços estendidos para fora | Uma criança está rapidamente descendo um escorregador íngreme
cluster 6 (308 sentences): Este animal está brincando com uma melancia | Alguém está coçando a barriga de um animal | Uma pessoa está acariciando a barriga de um animal
cluster 7 (233 sentences): Não tem nenhum homem brincando com um crânio | Não tem nenhuma mulher colocando espetos em uma prateleira | Não tem nenhuma mulher fritando algo
Como ler. Sem nenhum rótulo, o k-means sobre os embeddings acha temas reconhecíveis: comida sendo preparada (grupo 1), cachorros (2), bicicletas (4), crianças (5), animais sendo acariciados ou manuseados (6). Cada linha mostra as três frases mais próximas do centro do grupo, os membros mais típicos. O grupo 7 é a surpresa mais instrutiva: suas 233 frases são as negações, "Não tem nenhum homem...". O embedding as agrupou pela forma (um molde de frase compartilhado por todos os assuntos), não pelo que dizem. Os grupos refletem tudo o que os vetores codificam, não só o assunto que você tinha em mente; leia-os antes de dar nomes a eles (como em interpretando os grupos).
Simulação: o grupo 7 é só de negações? O passo 6 leu o grupo 7 pelas suas três frases mais típicas. Confira em todas as frases: marque as que têm uma palavra de negação (não, nenhum, nenhuma, ninguém) e conte-as em cada grupo. O grupo 7 é feito só de negações? Todas as negações estão no grupo 7?
Solução
negation = pd.Series(sentences).str.contains(r'\b(?:[Nn]ão|Nenhum|Nenhuma|Ninguém)\b').to_numpy()
print(f"{negation.sum()} of {len(sentences)} sentences contain a negation word")
print(pd.DataFrame({'sentences': np.bincount(km.labels_),
                    'with negation': np.bincount(km.labels_, weights=negation).astype(int)}).T.to_string())
304 of 3659 sentences contain a negation word
                 0    1    2    3    4    5    6    7
sentences      844  517  461  569  170  557  308  233
with negation   12    2   16    6    6   18   11  233
O grupo 7 é todo de negações: 233 de 233, de várias formas ("Não tem nenhum...", "Uma pessoa não está...", "Ninguém está..."). Mas ele guarda só 233 das 304 negações: as outras 71 ficaram com seus assuntos, em pequeno número em cada um dos outros grupos. O embedding fez as duas coisas ao mesmo tempo: na maioria das frases negadas, o molde comum venceu e as juntou; em algumas, venceu o assunto. Um grupo é uma região do espaço de vetores, não um rótulo; conte o que há nele antes de dar um nome.
Passo 7 — um mapa das frases
Preveja. Os vetores de palavras da página anterior guardaram 36% da variância em dois eixos do PCA. Vetores de frase de 384 números vão guardar mais ou menos?
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA

pca = PCA(n_components=2, random_state=0).fit(E)
P = pca.transform(E)
print(f"the 2 PCA axes keep {pca.explained_variance_ratio_.sum():.1%} of the variance of the 384 dimensions")
plt.figure(figsize=(7, 6))
plt.scatter(P[:, 0], P[:, 1], c=km.labels_, cmap='tab10', s=5)
for c in range(8):
    x, y = P[km.labels_ == c].mean(axis=0)
    plt.text(x, y, str(c), fontsize=14, weight='bold')
plt.title('3,659 ASSIN 2 sentences, colored by k-means cluster')
plt.show()
Como ler. Os dois eixos do PCA guardam só 14,2% da variância: sentence embeddings espalham sua informação por muitas dimensões, bem mais que os vetores de palavras da página anterior. Por isso o mapa mostra os grupos muito sobrepostos, embora o k-means, trabalhando em 384 dimensões, os tenha separado. Experimente t-SNE ou UMAP, de redução de dimensionalidade (Sua vez (avançado), item 2), para um mapa que preserve as vizinhanças.
Passo 8 — os números práticos
Preveja. O modelo lê no máximo 128 tokens. Alguma destas frases curtas vai ser cortada? E quanta memória ocupam 3.659 vetores de 384 números: kilobytes, megabytes ou gigabytes?
n_tokens = np.array([len(model.tokenizer.tokenize(s)) for s in sentences])
print(f"tokens per sentence: median {np.median(n_tokens):.0f}, max {n_tokens.max()} · model limit {model.max_seq_length}")
print('rows of unit length?', np.allclose(np.linalg.norm(E, axis=1), 1))
print(f"memory: {E.nbytes / 1e6:.1f} MB as float32 · {len(sentences)} x {E.shape[1]} numbers")
print(f"{sum(p.numel() for p in model.parameters()):,} parameters in the multilingual model")
tokens per sentence: median 12, max 37 · model limit 128
rows of unit length? True
memory: 5.6 MB as float32 · 3659 x 384 numbers
117,653,760 parameters in the multilingual model
Como ler. A frase mais longa tem 37 tokens e o modelo lê 128, então nada foi cortado aqui; com avaliações de produtos ou artigos, verifique isso primeiro. As linhas têm comprimento 1, então todo produto escalar acima era um cosseno. A coleção inteira cabe em 5,6 MB. O modelo que a produziu tem 117,7 milhões de parâmetros: os embeddings são baratos de guardar e comparar; o custo está em calculá-los.
Simulação: números menores, mesmo ranking? O passo 8 guardou a coleção em float32, 5,6 MB. Guarde-a em float16 e em inteiros de 8 bits (multiplique por 127 e arredonde, como faz o simulador da seção 4), normalize de novo e recalcule o Spearman contra as notas humanas. Quanta memória se economiza e quanto se move o cosseno de algum par?
Solução
for name, Eq in [('float32', E), ('float16', E.astype(np.float16)),
                 ('int8', np.round(E * 127).astype(np.int8))]:
    Ef = Eq.astype(np.float32)
    Ef /= np.linalg.norm(Ef, axis=1, keepdims=True)
    s = pd.Series(np.sum(Ef[ia] * Ef[ib], axis=1))
    print(f"{name:8s} {Eq.nbytes / 1e6:4.1f} MB · Spearman {s.corr(pairs.human, method='spearman'):.3f}"
          f" · largest change of a pair's cosine {np.abs(s - pairs['emb']).max():.4f}")
float32   5.6 MB · Spearman 0.715 · largest change of a pair's cosine 0.0000
float16   2.8 MB · Spearman 0.715 · largest change of a pair's cosine 0.0000
int8      1.4 MB · Spearman 0.715 · largest change of a pair's cosine 0.0097
O float16 corta a memória pela metade sem mudança visível em quatro casas, e os inteiros de 8 bits a dividem por quatro sem mover o cosseno de nenhum par em mais de 0,0097; o Spearman fica em 0,715 nos três. O ranking dos pares, que é o que a busca e a similaridade usam, não precisa de precisão de 32 bits. É por isso que bancos de dados vetoriais costumam guardar embeddings comprimidos: o custo dos embeddings está em calculá-los, não em guardá-los.
Para fechar a aula. Em uma frase cada: (1) por que o k-means no TF-IDF falhou em dezesseis manchetes curtas e funcionou nos embeddings? (2) O que acontece, sem aviso, com um texto maior que o limite do modelo e o que fazer a respeito? (3) Onde está o custo dos sentence embeddings: em guardá-los, compará-los ou calculá-los?
Sua vez (avançado)
Em casa, com mais tempo:
- Cinco grupos. Mude o exemplo de agrupamento da seção 6 para
n_clusters=5. Qual manchete muda de grupo? O ARI sobe ou desce? Por que o ARI pode ser usado aqui, mas não num problema real de agrupamento? - Um mapa melhor. Troque o PCA do passo 7 por t-SNE (
sklearn.manifold.TSNE(metric='cosine', random_state=0)) ou UMAP (pip install umap-learn). Os oito grupos se separam? O grupo 7, das negações, continua sendo uma região só? - Trechos. Divida o
long_textda seção 7 em frases, codifique cada uma e tire a média dos vetores para ter um vetor do documento. A frase final decisiva muda o vetor do documento agora? Quanto, comparado ao 1,0000 do texto cortado?
Referências
- Vaswani, A.; Shazeer, N.; Parmar, N.; Uszkoreit, J.; Jones, L.; Gomez, A. N.; Kaiser, Ł.; Polosukhin, I. "Attention Is All You Need." NeurIPS 30 (2017): 5998–6008 — o Transformer. arXiv:1706.03762
- Devlin, J.; Chang, M.-W.; Lee, K.; Toutanova, K. "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding." NAACL-HLT (2019): 4171–4186. DOI
- Reimers, N.; Gurevych, I. "Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks." EMNLP-IJCNLP (2019): 3982–3992 — o método por trás do
sentence-transformers. DOI - Reimers, N.; Gurevych, I. "Making Monolingual Sentence Embeddings Multilingual using Knowledge Distillation." EMNLP (2020): 4512–4525 — como o modelo multilíngue foi treinado. DOI
- Muennighoff, N.; Tazi, N.; Magne, L.; Reimers, N. "MTEB: Massive Text Embedding Benchmark." EACL (2023): 2014–2037 — o benchmark usado para comparar modelos de embedding. DOI
- Real, L.; Fonseca, E.; Gonçalo Oliveira, H. "The ASSIN 2 Shared Task: A Quick Overview." PROPOR (2020), LNCS 12037: 406–412 — o conjunto de dados do lab. DOI
- Jurafsky, D.; Martin, J. H. Speech and Language Processing, 3ª ed. (rascunho), capítulos sobre Transformers e modelos de linguagem mascarados — a mecânica por trás desta página, em ritmo de livro-texto. Texto completo
Quiz
O quiz cobre a abordagem fundamental.