A maioria das tarefas é sobre textos, não palavras
suporte
achar a entrada do FAQ (perguntas frequentes) que responde a uma pergunta
operação
agrupar chamados de suporte
busca
recuperar os documentos que casam com uma consulta
O caminho desta aula
- Média das palavrasmédia dos vetores GloVe; ordem e negação somem
- Palavras em contextoTransformers: uma palavra, vários vetores
- Um vetor por fraseSentence-BERT contra TF-IDF e média; outras línguas
- Buscar e agruparbusca semântica, agrupamento, notas práticas
A resposta óbvia: a média dos vetores de palavras
| "the movie was great" | os quatro primeiros dos 50 números do GloVe |
|---|---|
| the | 0,418 · 0,25 · −0,412 · 0,122 … |
| movie | 0,308 · 0,172 · −0,233 · 0,023 … |
| was | 0,087 · −0,194 · −0,243 · −0,334 … |
| great | −0,027 · 1,336 · −1,028 · −0,373 … |
| média | 0,197 · 0,391 · −0,479 · −0,141 … |
À mão: \((0{,}418 + 0{,}308 + 0{,}087 - 0{,}027)/4 = 0{,}1965\). Não custa nada e não precisa de treino.
O que a média perde
| 1,00 | the dog bit the man / the man bit the dog |
| 0,99 | the movie was good / the movie was not good |
| 0,96 | the movie was great / the film was excellent |
| 0,66 | the stock market fell sharply today / my cat likes to sleep on the couch |
a ordem some
as mesmas palavras dão a mesma média: exatamente 1,00
a negação mal aparece
"not" é uma palavra em cinco
tudo parece parecido
frases sem relação ainda dão 0,66
Transformers, em um slide
- Um Transformer (Vaswani et al., 2017) lê a frase inteira de uma vez.
- Ele corta o texto em tokens de subpalavras (um vocabulário de cerca de 30.000 pedaços): nenhuma palavra fica fora do vocabulário.
- Em cada camada, o vetor de cada token é recalculado como uma mistura ponderada de todos os tokens (atenção).
- BERT (Devlin et al., 2019): treinado para preencher palavras escondidas; um vetor contextual por token.
Embeddings are unbelievably useful → em · ##bed · ##ding · ##s · are · un · ##bel · ##ie · ##va · ##bly · useful
Uma palavra, vários vetores
| rio 1 | rio 2 | rio 3 | dinheiro 4 | dinheiro 5 | dinheiro 6 | |
|---|---|---|---|---|---|---|
| rio 1 | 1,00 | 0,83 | 0,86 | 0,76 | 0,76 | 0,76 |
| rio 2 | 0,83 | 1,00 | 0,84 | 0,72 | 0,72 | 0,73 |
| dinheiro 4 | 0,76 | 0,72 | 0,72 | 1,00 | 0,88 | 0,86 |
| dinheiro 5 | 0,76 | 0,72 | 0,73 | 0,88 | 1,00 | 0,82 |
Sentence-BERT: treinado para comparar frases
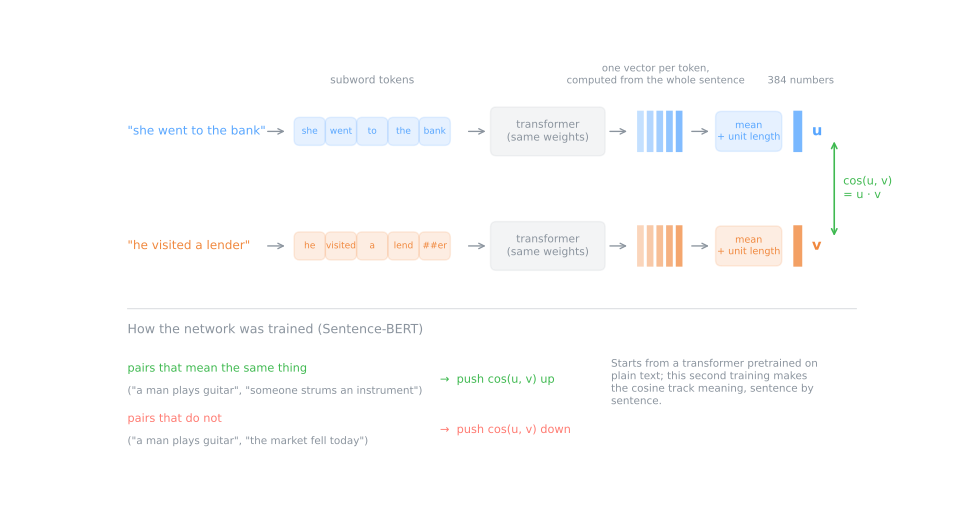
Mean pooling: a média dos vetores dos tokens, cada um já carregando seu contexto.
O Sentence-BERT (Reimers & Gurevych, 2019) acrescenta um treino: cosseno alto para pares que significam o mesmo, baixo para os que não.
Usando o sentence-transformers
E = model.encode(["the movie was great", "the film was excellent",
                  "the stock market fell sharply today"], normalize_embeddings=True)
E @ E.T     # com linhas de comprimento 1, o produto escalar é o cosseno
tamanho
paráfrases
o modelo
A média do GloVe dava 0,96 contra 0,66: agora a escala é usada de baixo a cima.
Três representações, os mesmos pares
TF-IDF (frequência do termo × frequência inversa nos documentos), média dos vetores GloVe e Sentence-BERT (SBERT) em oito pares, cada um testando uma propriedade:
| par | TF-IDF | média GloVe | SBERT |
|---|---|---|---|
| paráfrase | 0,28 | 0,96 | 0,88 |
| paráfrase, outras palavras | 0,19 | 0,92 | 0,56 |
| mesma necessidade, outras palavras | 0,15 | 0,92 | 0,68 |
| negação | 0,82 | 0,99 | 0,82 |
| ordem das palavras | 1,00 | 1,00 | 0,98 |
| bank: rio vs dinheiro | 0,29 | 0,92 | 0,60 |
| apple: empresa vs fruta | 0,18 | 0,87 | 0,23 |
| sem relação | 0,04 | 0,66 | 0,02 |
Antes do próximo slide: em qual coluna você confiaria para separar relacionado de não relacionado?
Lendo a tabela
TF-IDF
mede palavras em comum: paráfrases sem elas ficam entre 0,15 e 0,28
média GloVe
diz "parecido" para tudo: de 0,66 a 1,00, nenhum limiar funciona
SBERT
usa a escala inteira: de 0,02 a 0,88; as duas "apples" dão 0,23
Outras línguas
| par (português) | só inglês | multilíngue |
|---|---|---|
| o filme foi ótimo / o longa foi excelente | 0,65 | 0,66 |
| esqueci minha senha / não lembro a senha da conta | 0,40 | 0,81 |
| o filme foi ótimo / the movie was great | 0,08 | 0,98 |
| o filme foi ótimo / a bolsa de valores caiu hoje | 0,40 | −0,02 |
Busca semântica é k vizinhos mais próximos
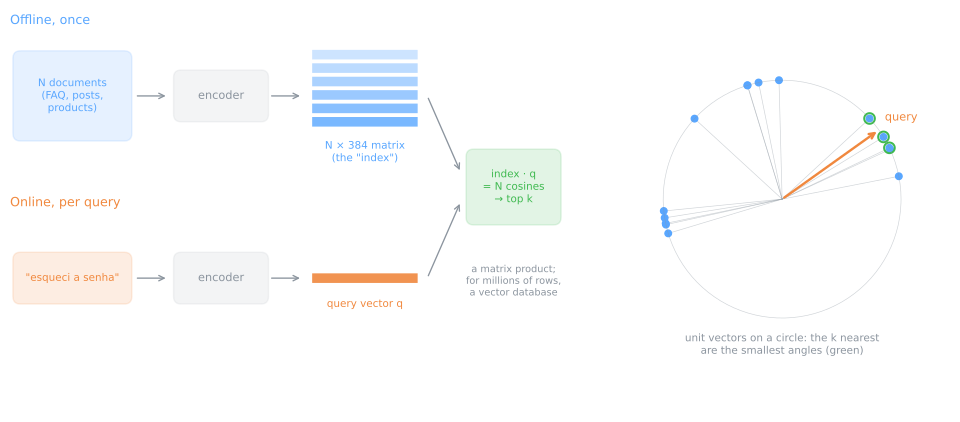
Codifique a coleção uma vez; para cada consulta, um produto de matrizes dá todos os cossenos. Sem rótulos e sem previsão: só achar vizinhos.
Um FAQ em português, oito entradas
| consulta | 1ª resposta | cos |
|---|---|---|
| esqueci minha senha | Como faço para trocar a senha da minha conta? | 0,68 |
| onde está minha encomenda? | Como rastrear o meu pedido? | 0,60 |
| desisti da compra | Como cancelar uma compra que ainda não foi enviada? | 0,62 |
| o celular veio com defeito | Posso devolver um produto depois de usado? (garantia em 2º, 0,24) | 0,26 |
| I need a copy of my invoice | Como faço para trocar a senha… (erro) | 0,43 |
Simulador: embeddings vs TF-IDF
Preveja. Para a consulta "erro 402", qual ranking ganha, embeddings ou TF-IDF? Depois digite sua própria consulta.
O que o simulador mostra
embeddings
TF-IDF
Agrupando frases
16 manchetes em português, quatro assuntos (futebol, culinária, economia, tempo), k-means com 4 grupos, avaliado pelo índice de Rand ajustado (ARI):
TF-IDF
embeddings
Notas práticas
- Normalize: o cosseno vira produto escalar.
- Codifique em lotes uma única vez e salve a matriz.
- Limite de tamanho: um texto de 330 tokens mais uma última frase decisiva → cosseno 1,0000 (o modelo lê 256; o multilíngue, 128). Quebre documentos longos em pedaços.
- Custo: 22,7 milhões de parâmetros (117,7 milhões no multilíngue), de segundos a minutos numa CPU; 1,5 KB por texto em float32.
- Escolha: língua, tipo de texto, orçamento; faça uma lista curta no MTEB (Massive Text Embedding Benchmark) e meça nos seus dados.
- Escala: bancos de dados vetoriais para milhões de textos.
Resumo
- A média dos vetores de palavras é de graça, mas cega à ordem e à negação: tudo parece igual.
- Um Transformer dá a cada token um vetor contextual: dois "banks", dois vetores.
- Sentence-BERT: agregado e treinado para que o cosseno acompanhe o significado, na escala inteira.
- Busca semântica = vizinhos mais próximos; agrupar textos curtos funciona muito melhor que no TF-IDF.
- Confira negação e papéis, escolha o modelo pela sua língua, cuidado com o limite de tamanho.
Similaridade de frases em português
- ASSIN 2: 2.448 pares de teste de frases em português do Brasil, avaliados por pessoas de 1 a 5.
- Pontue-os com TF-IDF e dois modelos do sentence-transformers, meça quanto cada um acompanha a nota humana e leia onde discordam.
- Depois busque, agrupe e desenhe as 3.659 frases distintas.
- Baixe o notebook do lab e abra no Jupyter ou no Colab; no Colab, rode
!pip install sentence-transformersantes.
Downloads dos modelos: cerca de 90 MB e 470 MB; uma GPU do Colab faz o lab em poucos segundos.