O caminho desta parte
- Contar o vocabulárioas leis de Heaps e de Zipf
- Juntar as variantesradicais e lemas, com NLTK e spaCy
- Nenhuma palavra desconhecidaWordPiece, SentencePiece; quem decide o quê
Quão grande fica o vocabulário?
A coleção 20 Newsgroups: 11.314 posts de grupos da Usenet do começo dos anos 1990. Leia um token de cada vez e conte as palavras distintas vistas até ali.
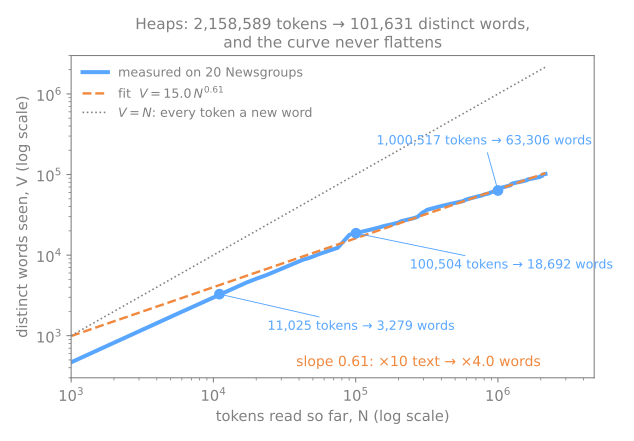
Lei de Heaps: o vocabulário nunca para de crescer
como ler
- eixo x: tokens lidos até ali; eixo y: palavras distintas já vistas. Os dois em escala log.
- Em escala log, uma lei de potência vira reta; a inclinação, 0,61, é o expoente.
- Pontilhada: se todo token fosse uma palavra nova. A curva fica abaixo dela, mas nunca deita.
- 11 mil tokens → 3.279 palavras; 100 mil → 18.692; 1 milhão → 63.306.
Lei de Zipf: poucas palavras estão em toda parte
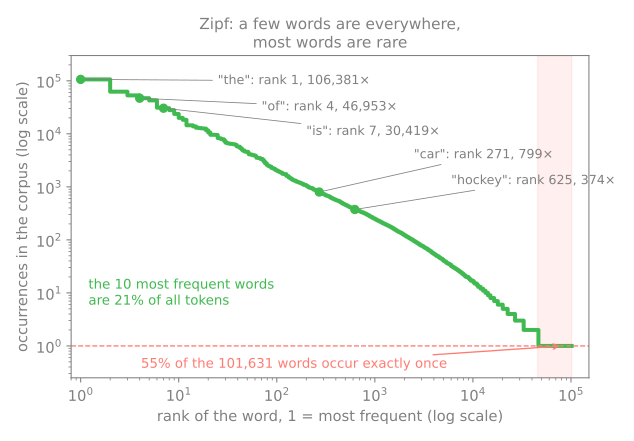
Preveja. Das 101.631 palavras distintas, que fração aparece uma única vez no corpus inteiro: 5%, 25% ou mais da metade?
como ler
- Cada ponto é uma palavra. Eixo x: a sua posição no ranking (1 = a mais frequente); eixo y: quantas vezes aparece. Os dois em log.
- No topo, "the" (106.381 vezes), "of", "is": as 10 primeiras são 21% de todos os tokens.
- No meio, "car" (posto 271, 799 vezes) e "hockey" (posto 625, 374 vezes).
- Faixa vermelha: 55% das palavras aparecem uma única vez.
Simulador: tokenize um parágrafo
Preveja. Passe de unigramas para uni + bi, o que o ngram_range=(1, 2) faz: o vocabulário cresce um pouco, dobra ou mais?
A mesma frase, normalizada
O stemming corta sufixos por regras (o RSLPStemmer do NLTK, Natural Language Toolkit; RSLP: Removedor de Sufixos da Língua Portuguesa); a lematização devolve a forma de dicionário (spaCy). A frase é a da parte fundamental.
| passo | saída |
|---|---|
| sem stop words | gatos · não · comeram · ração · cachorro · mas · gato · comeu |
| stems (RSLP, Removedor de Sufixos da Língua Portuguesa) | os · gat · não · com · a · raç · do · cachorr · mas · o · gat · com |
| lemas (spaCy) | o · gato · não · comer · o · ração · de o · cachorro · mas · o · gato · comeu |
| bigramas | os gatos · gatos não · não comeram · comeram ração · ração do · do cachorro · cachorro mas · mas gato · gato comeu |
- "com" (preposição) e "comida" também viram "com": quatro palavras sem relação dividem uma coluna.
- O lematizador pequeno deixou "comeu" como estava: ele é um modelo estatístico e erra.
- "não" sobrevive a esta lista; a lista em inglês do scikit-learn remove "not", "no" e "never".
Subpalavras: os tokenizadores dos modelos neurais
Palavras frequentes ficam inteiras; palavras raras viram pedaços frequentes: nenhuma palavra é desconhecida.
| tokenizador | saída |
|---|---|
WordPiece, all-MiniLM-L6-v230.522 pedaços do inglês, o tokenizador do BERT (Bidirectional Encoder Representations from Transformers) | tokenization → token ##ization unbelievably → un ##bel ##ie ##va ##bly s → os ga ##tos na ##o come ##ram a ra ##cao do ca ##cho ##rro , mas o ga ##to come ##u ! |
| SentencePiece, modelo multilíngue 250.002 pedaços, mais de 50 línguas | s → ▁Os ▁gato s ▁não ▁come ram ▁a ▁ra ção ▁do ▁cachorro , ▁mas ▁o ▁gato ▁come u ! desparafusaram → ▁des para fus aram |
##: colado ao pedaço anterior; ▁: início de palavra. Cada pedaço tem seu vetor, então uma palavra nunca vista inteira ainda recebe um.
Quem decide o quê: cada decisão de tokenização, por família
| bag-of-words, TF-IDF frequência do termo × frequência inversa nos documentos | word embeddings (GloVe) | sentence embeddings | |
|---|---|---|---|
| minúsculas, pontuação | escolha sua (o padrão do scikit-learn põe em minúsculas e tira a pontuação) | o vocabulário do GloVe é todo em minúsculas | o tokenizador do modelo decide |
| stop words | opcional: tira colunas | opcional, antes da média | não: "não" muda o sentido |
| stemming, lematização | opcional: junta colunas | não: um vetor por forma | não |
| n-gramas | opcional: colunas de pares | não | não: o modelo lê a frase na ordem |
| subpalavras | não | não: palavra fora do vocabulário fica sem vetor | sim, o tokenizador do modelo |
Resumo
- Lei de Heaps: o vocabulário cresce como \(N^{0{,}61}\) e nunca para; lei de Zipf: 55% das palavras aparecem uma vez.
- O stemming corta sufixos (e junta palavras sem relação); a lematização busca a forma de dicionário (e erra).
- Os tokenizadores de subpalavras dividem palavras raras em pedaços conhecidos: nenhuma palavra é desconhecida.
- Normalizar é uma decisão da família esparsa; os modelos densos trazem o próprio tokenizador.
Dois espaços e um classificador, passos 5 e 6
- Continue no mesmo notebook e na mesma sessão dos passos 1 a 4.
- Passo 5: mapas t-SNE (incorporação estocástica de vizinhos com distribuição t, t-distributed stochastic neighbor embedding) dos dois espaços e a sua silhueta.
- Passo 6: o mesmo classificador caixa-preta nas duas representações, com todos os rótulos e com 10 por classe.
- Simulação: a ordem importa? (passo 5).
- O notebook do lab, a partir do passo 5.
Ritmo: passo 5 e a simulação em 12 min; passo 6 em 8 min.