O problema: texto não é tabela
- A PCA (análise de componentes principais) gira as colunas de uma tabela; o k-means mede distâncias entre as suas linhas.
- Uma avaliação, um chamado de suporte, um post de fórum é uma sequência de caracteres de qualquer tamanho.
Esta aula constrói a ponte de strings a vetores, para que distâncias, projeções e agrupamentos valham para texto.
Duas famílias de respostas
esparsas
Bag-of-words, TF-IDF (frequência do termo × frequência inversa nos documentos)
- uma coluna por palavra do vocabulário
- cada documento é a contagem das suas palavras, com algum peso
- obtidas por contagem, em um segundo, sem modelo algum
densas
Word e sentence embeddings
- algumas centenas de números por palavra ou por documento
- produzidos por um modelo treinado com muito texto
- significado parecido fica próximo, mesmo sem palavras em comum
O caminho desta aula
- Texto → tokenstokenização, normalização, vocabulário
- Tokens → vetoresparso: bag-of-words, TF-IDF · denso: embeddings
- Comparar vetorescosseno, distância euclidiana, produto escalar, Jaccard
- Usar e escolherbusca e classificação: esparso ou denso?
Cortar o texto em tokens
from sklearn.feature_extraction.text import CountVectorizer

docs = ["O gato comeu o peixe.",
        "O cachorro comeu a ração do gato.",
        "Gato dorme, gato sonha."]
analyzer = CountVectorizer().build_analyzer()    # o tokenizador padrão do scikit-learn
for d in docs:
    print(analyzer(d))
Três decisões silenciosas
['gato', 'comeu', 'peixe']
['cachorro', 'comeu', 'ração', 'do', 'gato']
['gato', 'dorme', 'gato', 'sonha']
minúsculas
"Gato" e "gato" viram o mesmo token (lowercase=True)
a pontuação some
o token_pattern padrão mantém sequências de duas ou mais letras ou dígitos
palavras de uma letra somem
os artigos o, a sumiram; do fica. Os acentos ficam ("ração")
Três tokenizadores, uma frase
s = "Os gatos não comeram a ração do cachorro, mas o gato comeu!"
| tokenizador | saída |
|---|---|
s.split() | Os · gatos · não · comeram · a · ração · do · cachorro, · mas · o · gato · comeu! |
re.findall(r"\w+", s.lower()) | os · gatos · não · comeram · a · ração · do · cachorro · mas · o · gato · comeu |
analyzer(s) do scikit-learn | os · gatos · não · comeram · ração · do · cachorro · mas · gato · comeu |
Stop words e n-gramas
A frase de exemplo: "Os gatos não comeram a ração do cachorro, mas o gato comeu!" (12 tokens)
stop words
palavras muito frequentes e com pouco conteúdo (o, a, do, de), retiradas antes de contar
Os gatos não comeram a ração do cachorro, mas o gato comeu → 8 tokens
"não" ficou, porque não está nesta lista; a lista em inglês do scikit-learn tira "not".
n-gramas
sequências de \(n\) tokens vizinhos; bigramas são os pares
os gatos · gatos não · não comeram · comeram ração · … · gato comeu
"não comeram" vira um atributo só: um pouco da ordem volta.
Nas três frases dos slides anteriores: 8 colunas → 7 com uma lista pequena de stop words → 17 com bigramas.
Stemming e lematização
Juntar as variantes de uma palavra num token só. Na mesma frase:
| o que faz | exemplos | ferramenta | |
|---|---|---|---|
| stemming | corta sufixos por regras; o resultado não precisa ser uma palavra | gatos, gato → gat comeram, comeu → com sábados → sáb | RSLPStemmer do NLTK (Natural Language Toolkit) |
| lematização | a forma de dicionário, usando um vocabulário e a classe gramatical | gatos → gato comeram → comer sábados → sábado comeu → comeu (não reduziu) | spaCy |
A mesma frase, normalizada
| passo | saída |
|---|---|
| sem stop words | gatos · não · comeram · ração · cachorro · mas · gato · comeu |
| stems (RSLP, Removedor de Sufixos da Língua Portuguesa) | os · gat · não · com · a · raç · do · cachorr · mas · o · gat · com |
| lemas (spaCy) | o · gato · não · comer · o · ração · de o · cachorro · mas · o · gato · comeu |
| bigramas | os gatos · gatos não · não comeram · comeram ração · ração do · do cachorro · cachorro mas · mas gato · gato comeu |
- "com" (preposição) e "comida" também viram "com": quatro palavras sem relação dividem uma coluna.
- O lematizador pequeno deixou "comeu" como estava: ele é um modelo estatístico e erra.
- "não" sobrevive a esta lista; a lista em inglês do scikit-learn remove "not", "no" e "never".
Subpalavras: os tokenizadores dos modelos neurais
Palavras frequentes ficam inteiras; palavras raras viram pedaços frequentes: nenhuma palavra é desconhecida.
| tokenizador | saída |
|---|---|
WordPiece, all-MiniLM-L6-v230.522 pedaços do inglês, o tokenizador do BERT (Bidirectional Encoder Representations from Transformers) | tokenization → token ##ization unbelievably → un ##bel ##ie ##va ##bly s → os ga ##tos na ##o come ##ram a ra ##cao do ca ##cho ##rro , mas o ga ##to come ##u ! |
| SentencePiece, modelo multilíngue 250.002 pedaços, mais de 50 línguas | s → ▁Os ▁gato s ▁não ▁come ram ▁a ▁ra ção ▁do ▁cachorro , ▁mas ▁o ▁gato ▁come u ! desparafusaram → ▁des para fus aram |
##: colado ao pedaço anterior; ▁: início de palavra. Cada pedaço tem seu vetor, então uma palavra nunca vista inteira ainda recebe um.
Onde cada decisão da etapa 1 entra
| bag-of-words, TF-IDF | word embeddings (GloVe) | sentence embeddings | |
|---|---|---|---|
| minúsculas, pontuação | escolha sua (o padrão do scikit-learn põe em minúsculas e tira a pontuação) | o vocabulário do GloVe é todo em minúsculas | o tokenizador do modelo decide |
| stop words | opcional: tira colunas | opcional, antes da média | não: "não" muda o sentido |
| stemming, lematização | opcional: junta colunas | não: um vetor por forma | não |
| n-gramas | opcional: colunas de pares | não | não: o modelo lê a frase na ordem |
| subpalavras | não | não: palavra fora do vocabulário fica sem vetor | sim, o tokenizador do modelo |
Quão grande fica o vocabulário?
A coleção 20 Newsgroups: 11.314 posts de grupos da Usenet do começo dos anos 1990. Leia um token de cada vez e conte as palavras distintas vistas até ali.
Lei de Heaps: o vocabulário nunca para de crescer
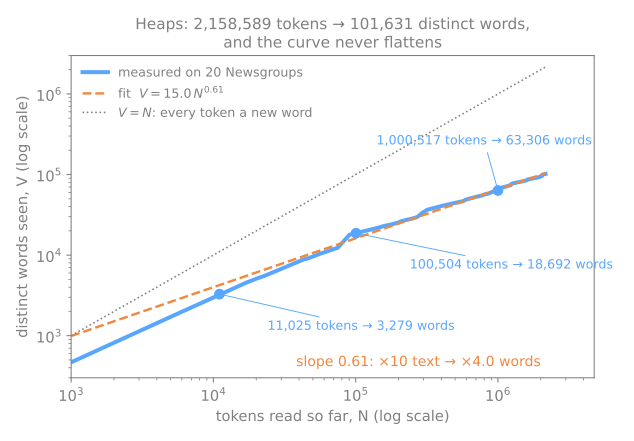
como ler
- eixo x: tokens lidos até ali; eixo y: palavras distintas já vistas. Os dois em escala log.
- Em escala log, uma lei de potência vira reta; a inclinação, 0,61, é o expoente.
- Pontilhada: se todo token fosse uma palavra nova. A curva fica abaixo dela, mas nunca deita.
- 11 mil tokens → 3.279 palavras; 100 mil → 18.692; 1 milhão → 63.306.
Lei de Zipf: poucas palavras estão em toda parte
Preveja. Das 101.631 palavras distintas, que fração aparece uma única vez no corpus inteiro: 5%, 25% ou mais da metade?
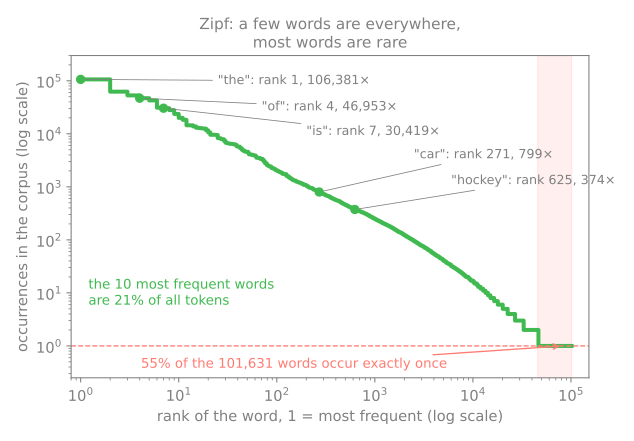
como ler
- Cada ponto é uma palavra. Eixo x: a sua posição no ranking (1 = a mais frequente); eixo y: quantas vezes aparece. Os dois em log.
- No topo, "the" (106.381 vezes), "of", "is": as 10 primeiras são 21% de todos os tokens.
- No meio, "car" (posto 271, 799 vezes) e "hockey" (posto 625, 374 vezes).
- Faixa vermelha: 55% das palavras aparecem uma única vez.
Simulador: tokenize um parágrafo
Preveja. Passe de unigramas para uni + bi, o que o ngram_range=(1, 2) faz: o vocabulário cresce um pouco, dobra ou mais?
Um mapa das abordagens
Depois que o texto foi cortado em tokens, quatro páginas transformam os tokens em vetores, do mais simples ao mais poderoso. Aponte para uma família para segui-la.
O que cada uma faz e o que não consegue fazer
| página | um documento vira | construído a partir de | o que não consegue fazer |
|---|---|---|---|
| U4.1 Bag-of-words | as contagens das suas palavras, uma coluna por palavra | contagem, sem modelo | ver a ordem, sinônimos ou palavras não vistas no fit |
| U4.2 TF-IDF | contagens pesadas pela raridade de cada palavra | contagem sobre o corpus | o mesmo: ele só muda o peso das colunas |
| U4.3 Word embeddings | um vetor denso por palavra (a média, para um documento) | coocorrência num corpus grande | separar os sentidos de uma mesma palavra |
| U4.4 Sentence embeddings | um vetor denso por frase ou documento curto | um transformer pré-treinado | ser barato ou explicar suas dimensões |
Bag-of-words: um documento é a sua contagem
       cachorro  comeu  do  dorme  gato  peixe  ração  sonha
doc 1         0      1   0      0     1      1      0      0
doc 2         1      1   1      0     1      0      1      0
doc 3         0      0   0      1     2      0      0      1
- Uma linha por documento, uma coluna por palavra; "gato" vale 2 no documento 3. A ordem das palavras é descartada.
- 13 das 24 células já são zero. Os 11.314 posts: \(11.314 \times 101.631\), 99,90% de zeros, guardada num formato esparso.
TF-IDF: contagens pesadas pela raridade
\[ \text{tf-idf}(t, d) = \text{tf}(t, d) \times \Big(\ln \frac{1 + n}{1 + \text{df}(t)} + 1\Big) \]e depois cada linha é dividida pelo seu comprimento. Preveja. No documento 1 (gato, comeu, peixe: uma vez cada), qual palavra pesa mais?
     cachorro   comeu      do   dorme  gato   peixe   ração   sonha
idf    1.6931  1.2877  1.6931  1.6931   1.0  1.6931  1.6931  1.6931
       cachorro  comeu     do  dorme   gato  peixe  ração  sonha
doc 1     0.000  0.548  0.000  0.000  0.425   0.72  0.000  0.000
doc 2     0.505  0.384  0.505  0.000  0.298   0.00  0.505  0.000
doc 3     0.000  0.000  0.000  0.543  0.641   0.00  0.000  0.543
"peixe", só no documento 1, pesa 0,720; "gato", nos três, 0,425. Os mesmos zeros; cada linha com comprimento 1. Spärck Jones (1972); Salton & Buckley (1988).
Similaridade e distância: quatro medidas
similaridade de cosseno
compara as direções dos dois vetores e ignora os comprimentos. 1 = mesmas palavras nas mesmas proporções; 0 = nada em comum.
distância euclidiana
a distância em linha reta entre os dois pontos (a do k-means). 0 = idênticos; cresce com qualquer diferença, inclusive de comprimento.
produto escalar
multiplique coordenada a coordenada e some. É grande quando os dois são grandes nas mesmas colunas: cresce com o tamanho do documento.
similaridade de Jaccard
esqueça as contagens e compare os conjuntos de tokens: os tokens em comum sobre todos os tokens distintos.
Uma consulta e dois candidatos
Colunas: cachorro, comeu, do, dorme, gato, peixe, ração, sonha. A consulta é A.
| A = "O gato comeu o peixe." | [0 1 0 0 1 1 0 0] |
| B = "Gato dorme, gato sonha." (outro assunto) | [0 0 0 1 2 0 0 1] |
| A3 = A escrito três vezes (mesmo assunto, mais longo) | [0 3 0 0 3 3 0 0] |
| par | cosseno | euclidiana | escalar | Jaccard |
|---|---|---|---|---|
| A e B | 0,471 | 2,236 | 2 | 0,200 |
| A e A3 | 1,000 | 3,464 | 9 | 1,000 |
| B e A3 | 0,471 | 4,583 | 6 | 0,200 |
Por que o cosseno é o padrão para texto
- Cosseno: A3 é idêntico a A (1,000) e B é uma correspondência parcial (0,471); B marca 0,471 contra A e contra A3.
- A euclidiana inverte a resposta: A3 fica mais longe de A (3,464) do que B (2,236), só porque é mais longo.
- Produto escalar: B contra A3 marca 6, o triplo do 2 contra A, para o mesmo conteúdo.
- O Jaccard concorda aqui, mas é cego a quantas vezes uma palavra aparece.
normalize_embeddings=True.Os limites das representações esparsas
- Sinônimos dão zero: cosseno 0,00. Cada palavra é um eixo próprio, ortogonal aos outros.
- A ordem é invisível: "o cachorro mordeu o homem" e "o homem mordeu o cachorro" têm cosseno 1,00.
- Uma grafia, dois sentidos: manga (da camisa ou a fruta) faz frases sem relação parecerem próximas e duas frases de mesmo sentido parecerem sem relação (0,14 nos dois casos).
- Palavras novas somem: uma palavra não vista no
fitnão tem coluna.
Denso: conhecer uma palavra pelas companhias
"Você conhecerá uma palavra pelas companhias que ela mantém" (Firth, 1957)
- Hipótese distribucional (Harris, 1954): palavras usadas em contextos parecidos têm significados parecidos.
- "carro" e "automóvel" raramente estão na mesma frase, mas aparecem ao lado de motor, concessionária, pneu.
- Cada palavra ou texto recebe algumas centenas de números, aprendidos para que contextos parecidos deem vetores próximos.
Word embeddings, sentence embeddings
word embeddings (U4.3)
O word2vec (Mikolov et al., 2013) prevê as palavras em volta de cada palavra; o GloVe fatora contagens de coocorrência.
Sinônimos ficam próximos. Limite: um vetor por palavra, qualquer que seja o sentido.
sentence embeddings (U4.4)
Transformers (BERT) calculam cada token a partir da frase inteira: manga ao lado de "camisa" ≠ ao lado de "madura".
Sentence-BERT: um vetor por frase; o cosseno acompanha a proximidade de sentido.
Word embeddings: como é um vetor
GloVe, treinado em 6 bilhões de tokens de texto em inglês: 400.000 palavras, 50 números cada.
glove = api.load('glove-wiki-gigaword-50')
print('cat =', glove['cat'][:8].round(3), '...')
print(glove.most_similar('cat', topn=5))
cat = [ 0.453 -0.501 -0.537 -0.016  0.222  0.546 -0.673 -0.689] ... (50 numbers, none of them zero)
nearest to cat: dog 0.92, rabbit 0.85, monkey 0.80, rat 0.79, cats 0.79
cosine car / automobile: 0.70
cosine car / banana: 0.22
Nenhum número sozinho significa algo; os vizinhos sim. "car" e "automobile" nunca dividiram uma coluna na bag-of-words; aqui têm cosseno 0,70.
Sentence embeddings: um vetor por frase
paraphrase-multilingual-MiniLM-L12-v2, com normalize_embeddings=True: 384 números por texto, mais de 50 línguas.
(3, 384)
o carro é rápido = [ 0.016  0.033 -0.08   0.037 -0.014 -0.002  0.039 -0.028] ... (384 numbers)
vs 1: cosine 0.97 · dot 0.97 · Euclidean 0.25
vs 2: cosine 0.23 · dot 0.23 · Euclidean 1.24
Com comprimento 1, produto escalar = cosseno e a distância euclidiana conta a mesma história ao contrário.
Esparso vs denso: uma frase, três vetores
"the cat sleeps on the couch": bag-of-words sobre o vocabulário dos newsgroups, a média dos seus vetores GloVe e o seu sentence embedding.
| comprimento | não nulos | valores | |
|---|---|---|---|
| bag-of-words | 101.631 | 5 | cat (coluna 26.019) = 1, couch = 1, on = 1, sleeps = 1, the = 2 · todas as outras 0 |
| média GloVe | 50 | 50 | [ 0.271 0.037 -0.335 -0.147 0.541 0.055] ... |
| sentence embedding | 384 | 384 | [ 0.39 -0.348 -0.135 0.145 0.115 0.278] ... |
O que "esparso" e "denso" querem dizer
| esparsa (bag-of-words, TF-IDF) | densa (word e sentence embeddings) | |
|---|---|---|
| comprimento | uma coluna por palavra do vocabulário: 101.631 | fixado pelo modelo: 50 (GloVe), 384 (frases) |
| valores não nulos | só as palavras do texto: 5 | todos |
| uma coordenada significa | coluna 26.019 = "quantas vezes cat aparece" | nada sozinha |
| guardada como | as células não nulas (índice, valor) | um vetor comum de números reais |
| nenhuma palavra em comum | nenhuma coluna em comum: cosseno 0 | ainda podem ficar próximos |
Simulador: quatro jeitos de transformar uma frase em vetor
Preveja. Na paráfrase "o carro é rápido" / "o automóvel é veloz", quais das quatro dão cosseno 0? Depois troque a ordem das palavras e marque B três vezes.
Esparso vs denso: os mesmos pares, dos dois jeitos
TF-IDF ajustado nas frases da tabela; um modelo multilíngue pequeno do sentence-transformers (384 números por texto).
| A | B | TF-IDF | embedding |
|---|---|---|---|
| o carro é rápido | o automóvel é veloz | 0,00 | 0,97 |
| comprei um celular novo | adquiri um smartphone novo | 0,43 | 0,91 |
| o gato dorme no sofá | the cat sleeps on the couch | 0,00 | 0,98 |
| a manga da camisa rasgou | o punho da blusa descosturou | 0,21 | 0,87 |
| a manga da camisa rasgou | comi uma manga madura | 0,21 | 0,35 |
| o filme é muito bom | o filme não é bom | 0,60 | 0,46 |
| o cachorro mordeu o homem | o homem mordeu o cachorro | 1,00 | 0,98 |
| a taxa de juros subiu | o time venceu o jogo | 0,00 | 0,14 |
Lendo a tabela, linha a linha
- paráfrases: 0,91 contra 0,43; o TF-IDF só enxerga "um" e "novo".
- tradução: nenhum token em comum, 0,98. Uma consulta em português acha documentos em inglês.
- as duas linhas de "manga": o TF-IDF dá 0,21 às duas; o embedding separa manga-e-punho (0,87) de manga-e-fruta (0,35).
- negação: mais baixo (0,46), mas longe de "oposto".
- ordem das palavras: 0,98. Os embeddings também confundem quem mordeu quem.
- sem relação: 0,14, não 0.
Onde o TF-IDF é mais forte: tokens raros e exatos
Duas entradas de uma central de ajuda que diferem só no código de erro (0x80070005 e 0x80004005) e uma consulta para cada código.
TF-IDF
embedding
Classificação: quantos rótulos você tem?
Quatro newsgroups, uma regressão logística usada como caixa-preta; só a representação muda. Acurácia em 1.364 posts posteriores (chutar uma classe: cerca de 25%).
| posts rotulados por classe | TF-IDF + clf | embedding + clf |
|---|---|---|
| 5 | 0,557 | 0,819 |
| 10 | 0,601 | 0,851 |
| 25 | 0,725 | 0,886 |
| 100 | 0,850 | 0,897 |
| todos | 0,904 | 0,901 |
Por quê: o que cada uma já sabe ao chegar
TF-IDF, 20 posts de treino
viu só algumas centenas de palavras distintas; um post de teste que não use nenhuma delas vira um vetor nulo. Com todos os rótulos, aprende o vocabulário de cada classe a partir dos dados.
embedding
já chega sabendo que "sedan" fica perto de "car", pelo texto em que foi treinado.
Esparso vs denso, lado a lado
| esparso (bag-of-words, TF-IDF) | denso (sentence embeddings) | |
|---|---|---|
| vetor de um documento | \(\lvert V \rvert\) colunas, 99,9% de zeros | 384–1.024 números |
| sinônimos, paráfrases | ortogonais: 0,00 | próximos: 0,97 |
palavras nunca vistas no fit | descartadas | tratadas (pedaços de subpalavras) |
| tokens raros e exatos | idf alto, sinal forte | diluídos no sentido geral |
| outras línguas | vocabulários separados | espaço compartilhado (modelo multilíngue) |
| 5 rótulos por classe / todos | 55,7% / 90,4% | 81,9% / 90,1% |
| interpretabilidade | cada coluna é uma palavra | colunas abstratas |
| custo | frações de segundo, sem modelo | um modelo pré-treinado; uma GPU ajuda |
Resumo: qual usar e quando
- Comece pelo TF-IDF: barato e difícil de bater quando há muitos rótulos e vocabulário de domínio.
- Recorra aos embeddings quando o significado importa mais que as palavras exatas (busca, textos curtos, paráfrases, várias línguas) ou quando os rótulos são escassos.
- Quando tanto os tokens exatos quanto o significado importam, combine os dois.
Esparso vs denso em posts reais
- Quatro newsgroups (computação gráfica, beisebol, eletrônica e cristianismo), cerca de 2.100 posts, representados duas vezes: TF-IDF e sentence embeddings.
- Passos: carregar os posts · duas representações · qual acha posts sobre o mesmo assunto? · busca semântica contra busca por palavras-chave · olhar os dois espaços · o mesmo classificador caixa-preta nas duas.
- Baixe o notebook do lab e abra no Jupyter ou no Colab; no Colab, rode
!pip install sentence-transformersantes.
Cada uma das quatro subpáginas (U4.1 a U4.4) tem simulador e lab próprios.