E2.2 TF-IDF
O bag-of-words terminou com dois problemas numa mesma figura: as contagens brutas põem no topo palavras presentes em todo documento ("the", em 9.475 dos 11.314 posts) e um único documento estranho pode dominar uma coluna ("ax", 62.387 ocorrências em 20 posts). Uma lista de stop words resolve o primeiro problema para uma única língua e apenas para as palavras que alguém lembrou de listar. O TF-IDF (frequência do termo × frequência inversa nos documentos) resolve os dois com uma única regra aprendida do próprio corpus: uma palavra pesa mais num documento quanto mais vezes aparece nele e menos quanto mais documentos a contêm.
Esta página calcula o TF-IDF à mão em três frases, confere que o scikit-learn dá exatamente os mesmos números, compara documentos pelo cosseno, monta um pequeno buscador e mede onde toda a abordagem esparsa falha. Todo número sai do código ao lado.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Quanto cada palavra deve pesar e como o TF-IDF compara documentos e responde a uma consulta? | O que os botões do vetorizador mudam e o que nenhum vetor esparso enxerga |
| conteúdo | a ideia e a fórmula do idf, a conta inteira à mão em três frases, o TfidfVectorizer, o cosseno como produto escalar, um pequeno buscador | smooth_idf, sublinear_tf e norm; os limites das representações esparsas: sinônimos, ordem das palavras, dois sentidos, palavras nunca vistas |
| lab em aula | quatro newsgroups: a matriz TF-IDF, palavras-chave e vizinhos, passos 1 a 5 | um buscador por palavras-chave e o que ele não enxerga, passos 6 e 7 |
| ao final, você sabe | calcular o idf e uma linha TF-IDF à mão e conferir com o scikit-learn; ler os termos mais pesados de um documento; ordenar documentos para uma consulta pelo cosseno | prever o efeito de cada botão; explicar por que sinônimos dão zero e palavras novas somem; reconhecer uma consulta que a busca por palavras-chave não responde |
Os dois labs usam o mesmo notebook do lab (baixe e abra no Jupyter ou no Colab, Arquivo → Fazer upload de notebook): a parte fundamental vai do passo 1 ao 5; a avançada, passos 6 e 7. Usa só o scikit-learn e roda em bem menos de um minuto.
Abordagem fundamental
Uma pergunta guia esta parte: quanto uma palavra deve pesar? A resposta cabe numa regra aprendida do próprio corpus: uma palavra pesa mais num documento quanto mais vezes aparece nele e menos quanto mais documentos a contêm. Tudo é calculado primeiro à mão, nas três frases da página de bag-of-words, depois conferido com o scikit-learn e, por fim, usado para comparar documentos e responder a consultas.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. pesar as palavras, a ideia e a fórmula do idf; 2. calcular e conferir, cada número à mão e depois no scikit-learn; 3. comparar e buscar, com o cosseno e um pequeno buscador. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Pesar as palavrastf × idf, a curva do idf
- Calcular e conferirtrês frases à mão, depois o scikit-learn
- Comparar e buscarcosseno, um pequeno buscador, um corpus real
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. A ideia: pesar as palavras pelo quanto são específicas
Etapa 1. A ideia é de Spärck Jones (1972): um termo que aparece em muitos documentos é um jeito ruim de distinguir documentos, então deve contar menos. Ela mediu isso em experimentos de recuperação. Salton & Buckley (1988), comparando muitos esquemas de peso em várias coleções, fizeram do tf × idf com normalização de comprimento o padrão da recuperação de informação.
A versão padrão do scikit-learn, para uma palavra \(t\) num documento \(d\), num corpus de \(n\) documentos dos quais \(\text{df}(t)\) contêm \(t\):
e depois cada vetor de documento é dividido pelo seu comprimento euclidiano, para que toda linha tenha norma 1 (norm='l2'). Dois detalhes diferem do \(\ln(n/\text{df})\) dos livros:
- o "+1" dentro da fração (
smooth_idf=True) age como se um documento extra contivesse cada palavra uma vez: nada de divisão por zero e uma curva um pouco mais plana; - o "+1" de fora mantém uma palavra presente em todo documento com peso 1, não 0. Ela é descontada, não apagada.
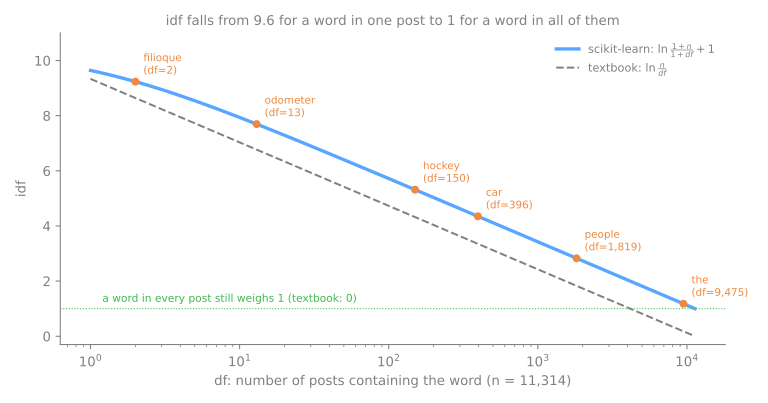
A curva é logarítmica: ir de 1 post para 10 custa mais ou menos tanto peso quanto ir de 1.000 para 10.000. Uma palavra que aparece em 2 posts ("filioque", um termo da teologia cristã) recebe idf 9,2, quase 8 vezes o 1,18 de uma palavra que aparece em quase todos ("the").
2. À mão, em três frases
Etapa 2. Os três documentos da página de bag-of-words e suas contagens:
import numpy as np
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer

docs = ["O gato comeu o peixe.",
        "O cachorro comeu a ração do gato.",
        "Gato dorme, gato sonha."]
bow = CountVectorizer()
X = bow.fit_transform(docs)
print(pd.DataFrame(X.toarray(), columns=bow.get_feature_names_out(), index=['d1', 'd2', 'd3']))
    cachorro  comeu  do  dorme  gato  peixe  ração  sonha
d1         0      1   0      0     1      1      0      0
d2         1      1   1      0     1      0      1      0
d3         0      0   0      1     2      0      0      1
Com \(n = 3\), só há três valores possíveis de idf:
- "gato", nos 3 documentos: \(\ln(4/4) + 1 = 1\);
- "comeu", em 2 documentos: \(\ln(4/3) + 1 = 1{,}2877\);
- todas as outras palavras, em 1 documento: \(\ln(4/2) + 1 = 1{,}6931\).
Para d1 ("gato comeu peixe", cada palavra uma vez), tf × idf dá gato 1, comeu 1,2877, peixe 1,6931. Seu comprimento é \(\sqrt{1^2 + 1{,}2877^2 + 1{,}6931^2} = \sqrt{5{,}5249} = 2{,}3505\); dividir por ele dá 0,4254, 0,5478, 0,7203. A palavra mais rara de d1 agora tem o maior peso. Os mesmos passos em NumPy:
n = len(docs)
df = (X.toarray() > 0).sum(axis=0)              # em quantos documentos cada palavra aparece
idf = np.log((1 + n) / (1 + df)) + 1            # idf suavizado do scikit-learn, log natural
for word, d, i in zip(bow.get_feature_names_out(), df, idf):
    print(f"{word:9s} df = {d}   idf = {i:.4f}")
cachorro  df = 1   idf = 1.6931
comeu     df = 2   idf = 1.2877
do        df = 1   idf = 1.6931
dorme     df = 1   idf = 1.6931
gato      df = 3   idf = 1.0000
peixe     df = 1   idf = 1.6931
ração     df = 1   idf = 1.6931
sonha     df = 1   idf = 1.6931
w = X.toarray()[0] * idf                        # d1: contagem bruta x idf
print('tf x idf :', w.round(4))
print(f'length   : {np.linalg.norm(w):.4f}')
print('tf-idf   :', (w / np.linalg.norm(w)).round(4))
tf x idf : [0.     1.2877 0.     0.     1.     1.6931 0.     0.    ]
length   : 2.3505
tf-idf   : [0.     0.5478 0.     0.     0.4254 0.7203 0.     0.    ]
O simulador percorre a conta inteira um passo por vez, sobre as contagens acima: a frequência de cada palavra nos documentos, os três valores de idf e depois cada linha, tf × idf, o seu comprimento e a divisão por ele. A linha d1 termina em 0,4254, 0,5478 e 0,7203, os números que acabamos de calcular; d2 e d3 seguem os mesmos três passos. Antes de avançar, preveja qual palavra de d3 vai pesar mais.
3. O scikit-learn confirma
O TfidfVectorizer é o CountVectorizer seguido deste mesmo peso:
from sklearn.feature_extraction.text import TfidfVectorizer

tfidf = TfidfVectorizer()          # padrões: smooth_idf=True, norm='l2', sublinear_tf=False
T = tfidf.fit_transform(docs)
print(pd.DataFrame(T.toarray(), columns=tfidf.get_feature_names_out(), index=['d1', 'd2', 'd3']).round(4))
print('same idf as by hand:', np.allclose(tfidf.idf_, idf))
    cachorro   comeu      do   dorme    gato   peixe   ração   sonha
d1    0.0000  0.5478  0.0000  0.0000  0.4254  0.7203  0.0000  0.0000
d2    0.5046  0.3838  0.5046  0.0000  0.2980  0.0000  0.5046  0.0000
d3    0.0000  0.0000  0.0000  0.5427  0.6411  0.0000  0.0000  0.5427
same idf as by hand: True
A linha d1 bate com a conta à mão até a quarta casa decimal; o atributo idf_ guarda o idf de cada coluna.
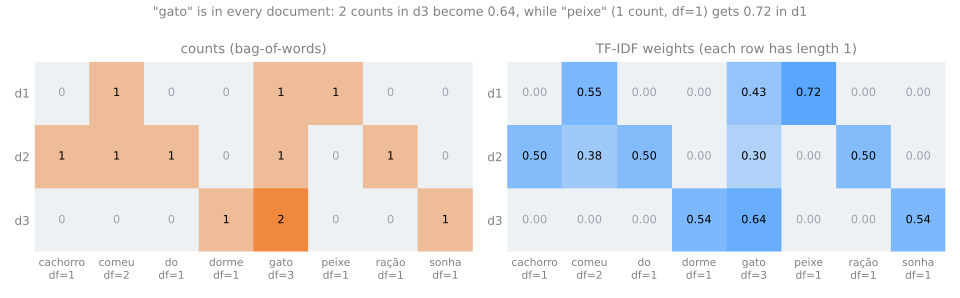
Há duas coisas a observar na figura. Em d1 e d2, "gato" agora tem o menor peso não nulo, porque está em toda parte. Em d3 ele ainda tem o maior (0,64): aparece duas vezes e o tf continua contando. O peso não remove as palavras comuns; só as rebaixa em relação às raras.
4. Comparando documentos: similaridade de cosseno
Etapa 3. A página de bag-of-words apresentou o cosseno entre dois vetores, \(\cos(x_a, x_b) = x_a \cdot x_b / (\lVert x_a \rVert \lVert x_b \rVert)\). As linhas do TF-IDF já têm comprimento 1, então o cosseno é só o produto escalar delas. À mão, d1 e d2 compartilham comeu e gato:
e d1 e d3 compartilham só gato: \(0{,}4254 \times 0{,}6411 = 0{,}273\). Lado a lado com os cossenos das contagens brutas:
from sklearn.metrics.pairwise import cosine_similarity

names = ['d1', 'd2', 'd3']
print('counts\n', pd.DataFrame(cosine_similarity(X), index=names, columns=names).round(3))
print('TF-IDF\n', pd.DataFrame(cosine_similarity(T), index=names, columns=names).round(3))
counts
        d1     d2     d3
d1  1.000  0.516  0.471
d2  0.516  1.000  0.365
d3  0.471  0.365  1.000
TF-IDF
        d1     d2     d3
d1  1.000  0.337  0.273
d2  0.337  1.000  0.191
d3  0.273  0.191  1.000
Todas as similaridades caíram, porque toda palavra compartilhada aqui inclui "gato", que o TF-IDF desconta. O par d1–d3 foi o que mais caiu (0,471 → 0,273): eles compartilham só "gato", a palavra menos informativa do corpus, que ainda aparece duas vezes em d3.
5. Um pequeno buscador
O TF-IDF foi criado justamente para recuperar documentos: transformar a consulta num vetor com o mesmo vetorizador ajustado e ordenar os documentos pelo cosseno. Considere um FAQ de central de ajuda com dez perguntas e cinco consultas escritas do jeito que um aluno digitaria:
faq = ["Como faço para trocar a senha do portal do aluno?",
       "Qual é o prazo para trancar a matrícula?",
       "Onde consigo a segunda via do boleto da mensalidade?",
       "Como peço revisão da nota de uma prova?",
       "O restaurante do campus abre aos sábados?",
       "Como reservo uma sala de estudos na biblioteca?",
       "Posso levar um visitante ao campus?",
       "Como justifico uma falta por motivo de saúde?",
       "O que fazer quando aparece o erro 0x80070005 na instalação?",
       "O que fazer quando aparece o erro 0x80004005 na atualização?"]
queries = ["esqueci minha senha",
           "erro 0x80004005",
           "quero contestar a correção do exame",
           "onde almoçar no sábado",
           "perdi a fatura"]

tf_faq = TfidfVectorizer().fit(faq)
F = tf_faq.transform(faq)
for q in queries:
    sims = cosine_similarity(tf_faq.transform([q]), F).ravel()
    best = sims.argmax()
    used = [w for w in tf_faq.build_analyzer()(q) if w in tf_faq.vocabulary_]
    print(f"{q:37s} {sims[best]:.2f}  FAQ {best}: {faq[best][:45]:45s} words used: {used}")
esqueci minha senha                   0.35  FAQ 0: Como faço para trocar a senha do portal do al words used: ['senha']
erro 0x80004005                       0.53  FAQ 9: O que fazer quando aparece o erro 0x80004005  words used: ['erro', '0x80004005']
quero contestar a correção do exame   0.51  FAQ 0: Como faço para trocar a senha do portal do al words used: ['do']
onde almoçar no sábado                0.37  FAQ 2: Onde consigo a segunda via do boleto da mensa words used: ['onde']
perdi a fatura                        0.00  FAQ 0: Como faço para trocar a senha do portal do al words used: []
Duas consultas funcionam e três falham; a última coluna diz por quê:
- "esqueci minha senha" acha a pergunta da senha pela palavra "senha" e o código de erro acha a própria entrada: um token raro tem idf alto, então um código exato é a consulta ideal para o TF-IDF;
- "quero contestar a correção do exame" só tem "do" em comum com o FAQ. A pergunta da senha, que contém "do" duas vezes, vence com 0,51. A resposta certa ("revisão da nota de uma prova") não usa nenhuma palavra da consulta;
- "onde almoçar no sábado" casa com a pergunta do boleto pela palavra "onde", porque a entrada do restaurante diz "sábados", não "sábado". Um stemmer resolveria esta;
- "perdi a fatura" não tem nenhuma palavra em comum com nenhuma entrada: similaridade 0,00 com tudo; o
argmaxdevolve a primeira pergunta por padrão.
Uma lista de stop words remove as falsas correspondências, mas não cria as verdadeiras:
stop_pt = ['o', 'a', 'os', 'as', 'do', 'da', 'de', 'no', 'na', 'e', 'um', 'uma', 'em', 'que',
           'como', 'para', 'onde', 'qual', 'quero', 'minha']
tf_stop = TfidfVectorizer(stop_words=stop_pt).fit(faq)
for q in queries[2:4]:
    sims = cosine_similarity(tf_stop.transform([q]), tf_stop.transform(faq)).ravel()
    print(f"{q:37s} best score {sims.max():.2f}")
Sem as palavras funcionais, as duas consultas dão 0,00 com todas as entradas: o TF-IDF agora diz, honestamente, que não achou nada. A busca por palavras-chave nunca é melhor do que a sobreposição entre as palavras da consulta e as dos documentos.
Num corpus real
A mesma comparação em escala: 2.097 posts de quatro newsgroups (carros, medicina, espaço, armas), representados por contagens brutas ou por TF-IDF, reduzidos a 50 dimensões com uma SVD truncada e desenhados com t-SNE. O newsgroup é usado só para colorir:
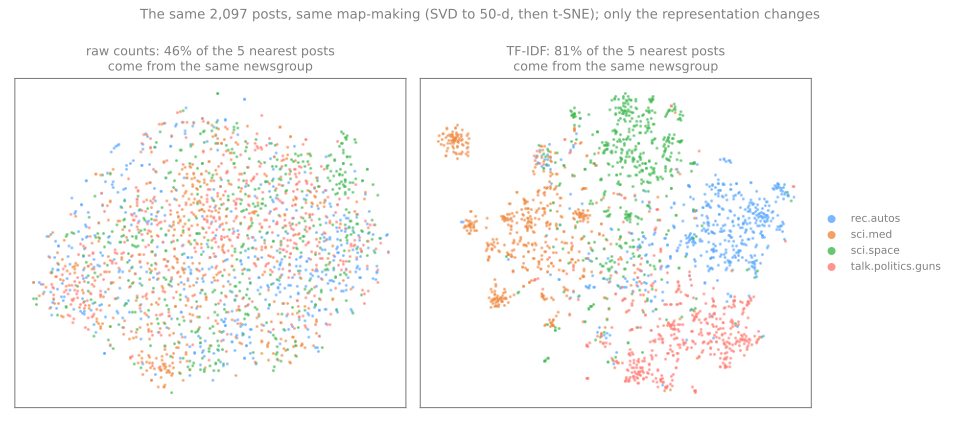
Com contagens brutas, os posts mais próximos são os que usam the, of, and em proporções parecidas: só 46% dos 5 vizinhos mais próximos de cada post vêm do seu newsgroup (uma escolha ao acaso daria cerca de 25%). O TF-IDF, que desconta justamente essas palavras, sobe para 81%. No mapa, aparecem quatro regiões.
Simulador: TF-IDF e busca ao vivo
Digite um documento por linha e, embaixo, uma consulta. O simulador calcula df, idf, a matriz TF-IDF, o cosseno entre documentos e a ordenação da consulta exatamente como o TfidfVectorizer faz, com os três botões da abordagem avançada.
O que testar:
- o preset aula reproduz os números acima (idf 1, 1,288, 1,693; d1 = 0,548, 0,425, 0,720; cos(d1, d2) = 0,337). Desmarque smooth_idf e veja o idf das palavras raras subir;
- acrescente uma quarta linha que repete "gato" cinco vezes e marque sublinear_tf: quanto a repetição ainda conta?
- o preset sinônimos: "carro veloz" casa com a segunda frase só por "veloz" e com a primeira só por "carro"; nenhuma é reconhecida como tendo o mesmo sentido;
- o preset FAQ: a consulta acha a pergunta do boleto pela palavra "onde" e "sábado" é ignorada porque os documentos só têm "sábados".
6. Resumo: o TF-IDF em cinco linhas
- O idf desconta uma palavra pelo número de documentos que a contêm: \(\ln\frac{1+n}{1+\text{df}} + 1\) no scikit-learn, 1 para uma palavra presente em todos os documentos, o maior valor para uma palavra presente num só.
- O tf continua contando: uma palavra repetida num documento mantém um peso grande nele, mesmo sendo comum.
- Cada linha é dividida pelo seu comprimento: linhas de comprimento 1, então o cosseno entre dois documentos é o produto escalar deles.
- O
TfidfVectorizeré oCountVectorizermais este peso: a conta à mão bate com ele na quarta casa decimal. - A busca usa o mesmo vetorizador ajustado para documentos e consulta, ordenados pelo cosseno: tokens raros e exatos são o seu ponto forte; uma consulta sem nenhuma palavra em comum com os documentos dá 0 com todos eles.
| sintoma | o que está acontecendo | o que fazer |
|---|---|---|
| os termos do topo de um documento são the, of, and | contagens brutas, sem peso | TF-IDF: o idf desconta as palavras presentes em todo documento |
| uma consulta casa por "do" ou "onde" | só palavras funcionais são compartilhadas | uma lista de stop words remove as falsas correspondências |
| todo escore dá 0,00 | nenhuma palavra da consulta está no vocabulário | esperado: a busca por palavras-chave precisa de palavras em comum (veja a abordagem avançada) |
Lab fundamental — a matriz TF-IDF de posts reais
Quatro newsgroups da coleção 20 Newsgroups (computação gráfica, beisebol, eletrônica e cristianismo), cerca de 2.100 posts. O lab monta a matriz TF-IDF, lê o que ela considera importante, acha os posts mais parecidos, mede como cada opção muda a qualidade dos vizinhos e transforma a matriz num buscador por palavras-chave, incluindo uma consulta que ele não consegue responder. Usa só o scikit-learn e roda em bem menos de um minuto.
Esta parte monta a matriz, lê o seu idf e os termos mais pesados de um post, acha os posts mais parecidos e compara as opções do vetorizador; o buscador fica para o lab avançado.
Como fazer este lab em aula (cerca de 25 min, em duplas)
- Baixe o notebook do lab e abra no Jupyter ou no Colab (Arquivo → Fazer upload de notebook). Ele usa só o scikit-learn. Rode as células em ordem, numa mesma sessão.
- Este lab é formado pelos passos 1 a 5 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 6.
- Todo passo começa com um Preveja: responda com sua dupla antes de rodar a célula. Errar a previsão é o que faz o resultado ficar na memória.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- A Simulação pede que você escreva um pequeno experimento em Python: mude uma entrada e veja o que acontece com a saída. Nada de contas à mão. A solução está recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 e 2 em 5 min; passo 3 e a simulação em 8 min; passos 4 e 5 em 12 min.
Passo 1 — carregar os posts
Preveja. São os mesmos 2.116 posts do lab de bag-of-words. O que muda neste lab: os documentos ou os números que os representam?
import numpy as np
import pandas as pd
from sklearn.datasets import fetch_20newsgroups

cats = ['comp.graphics', 'rec.sport.baseball', 'sci.electronics', 'soc.religion.christian']
raw = fetch_20newsgroups(subset='train', categories=cats,
                         remove=('headers', 'footers', 'quotes'), random_state=0)
keep = [i for i, t in enumerate(raw.data) if len(t.split()) >= 20]   # descarta posts vazios ou muito curtos
docs = [raw.data[i] for i in keep]
y = raw.target[keep]
names = np.array(raw.target_names)
print(len(docs), 'posts:', ', '.join(f"{g} {c}" for g, c in zip(names, np.bincount(y))))
2116 posts: comp.graphics 521, rec.sport.baseball 495, sci.electronics 535, soc.religion.christian 565
Os mesmos 2.116 posts do lab de bag-of-words: quatro grupos equilibrados, de 495 a 565 posts cada, sem cabeçalhos, assinaturas ou respostas citadas. Os posts com menos de 20 palavras foram descartados.
Passo 2 — a matriz TF-IDF e seu idf
Preveja. Com a lista de stop words do inglês e min_df=2, quais palavras vão ter o menor idf e quais o maior? Que comprimento cada linha vai ter?
from sklearn.feature_extraction.text import TfidfVectorizer

tfidf = TfidfVectorizer(stop_words='english', min_df=2)
T = tfidf.fit_transform(docs)
terms = tfidf.get_feature_names_out()
print(T.shape, f"{1 - T.nnz / (T.shape[0] * T.shape[1]):.2%} zeros")

idf = pd.Series(tfidf.idf_, index=terms).sort_values()
print('lowest idf :', idf.head(6).round(2).to_dict())
print(f"highest idf: {idf.iloc[-1]:.2f}, shared by the {(idf == idf.iloc[-1]).sum()} words found in exactly 2 posts")
print('row lengths:', np.sqrt(T.multiply(T).sum(axis=1)).A.ravel()[:5].round(3))
(2116, 12001) 99.52% zeros
lowest idf : {'like': 2.37, 'know': 2.41, 'don': 2.46, 'just': 2.49, 'think': 2.58, 'does': 2.62}
highest idf: 7.56, shared by the 3653 words found in exactly 2 posts
row lengths: [1. 1. 1. 1. 1.]
Como ler:
- 2.116 posts × 12.001 termos, 99,52% de zeros. A lista de stop words do inglês e o
min_df=2já cortaram o vocabulário pela metade; o TF-IDF muda os valores, não a esparsidade. - Os menores idf (2,37 a 2,62) são de palavras que não estão na lista de stop words, mas aparecem em toda parte na escrita informal: "like", "know", "just", "think". "don" é o que o tokenizador deixa de "don't". O TF-IDF as desconta sozinho, sem que ninguém as liste.
- O maior idf é \(\ln(2117/3) + 1 = 7{,}56\), o valor de uma palavra presente em exatamente 2 posts, o mínimo que o
min_df=2permite. 3.653 palavras o compartilham. - Toda linha tem comprimento 1: é a normalização L2; por isso, o produto escalar entre duas linhas é o cosseno delas.
Passo 3 — do que um post fala, em oito palavras
Preveja. Os oito termos mais pesados de um post: eles vão parecer um resumo dele? Uma palavra que não diz nada sobre o assunto pode entrar na lista?
i = 14
row = T[i].toarray().ravel()
print(f"post {i} ({names[y[i]]}):", ' '.join(docs[i].split())[:150])
print(pd.Series(row, index=terms).nlargest(8).round(3).to_string())
post 14 (sci.electronics): : >I want to upgrade my system and was thinking of buying Adcom seperates. : >I have heard from alot of people, though, that Adcom sounds great but :
adcom         0.463
amp           0.408
amplifier     0.270
components    0.250
amps          0.203
quality       0.165
sound         0.161
brilliant     0.151
O post 14 pergunta sobre a compra de amplificadores de áudio da Adcom; seus oito termos mais pesados parecem um resumo: a marca, "amp", "amplifier", "components", "sound". O TF-IDF funciona como um extrator de palavras-chave: uma palavra sobe quando este post a usa e poucos outros posts usam. "brilliant" (0,151) lembra que ele não sabe nada de significado: um adjetivo que o autor por acaso usou, raro no corpus, fica ao lado das palavras do assunto.
Simulação: contagens contra TF-IDF, num post. Monte as contagens brutas do post 14 sobre as mesmas colunas (CountVectorizer(stop_words='english', min_df=2)) e imprima as suas oito maiores contagens ao lado dos oito termos TF-IDF mais pesados. Qual lista parece mais um resumo do post? Quais palavras o idf empurra para fora?
Solução
from sklearn.feature_extraction.text import CountVectorizer

cv_stop = CountVectorizer(stop_words='english', min_df=2).fit(docs)      # as mesmas colunas, contagens brutas
c = pd.Series(cv_stop.transform([docs[i]]).toarray().ravel(), index=cv_stop.get_feature_names_out())
print('counts:', c.nlargest(8).to_dict())
print('TF-IDF:', list(pd.Series(row, index=terms).nlargest(8).index))
counts: {'amp': 7, 'adcom': 6, 'amplifier': 4, 'components': 4, 'like': 4, 'amps': 3, 'far': 3, 'good': 3}
TF-IDF: ['adcom', 'amp', 'amplifier', 'components', 'amps', 'quality', 'sound', 'brilliant']
As contagens já acham o assunto (amp, adcom, amplifier, components), porque a lista de stop words tirou as palavras funcionais. Mas elas também põem no topo "like" (4 vezes), "far" e "good" (3 vezes cada): palavras que o autor repetiu e que muitos outros posts também usam. O TF-IDF as empurra para fora. "like" tem o menor idf de todo o vocabulário (2,37, passo 2), então quatro ocorrências dela pesam menos que uma ou duas de uma palavra rara; "quality", "sound" e "brilliant" ocupam os lugares vagos. O idf funciona como uma lista de stop words aprendida do corpus, aplicada palavra por palavra e com graus em vez de um sim ou não.
Passo 4 — os posts mais parecidos
Preveja. Os posts mais parecidos com o post 14: de que newsgroup eles vão vir e o que vão compartilhar com ele?
from sklearn.metrics.pairwise import cosine_similarity

sim = cosine_similarity(T[i], T).ravel()
sim[i] = -1                                         # ignora o próprio post
for j in np.argsort(-sim)[:3]:
    shared = [terms[k] for k in np.intersect1d(T[i].indices, T[j].indices)]
    print(f"{sim[j]:.2f}  {names[y[j]]:18s} shared terms: {shared[:8]}")
0.66  sci.electronics    shared terms: ['adcom', 'amp', 'amplifier', 'amplifiers', 'amps', 'brilliant', 'build', 'built']
0.37  sci.electronics    shared terms: ['amp', 'amps', 'components', 'designed', 'good', 'heat', 'hot', 'inside']
0.30  sci.electronics    shared terms: ['adcom', 'components', 'designed', 'east', 'far', 'like', 'people']
Os três posts mais parecidos vêm todos de sci.electronics. O primeiro (cosseno 0,66) é uma resposta na mesma discussão e compartilha a marca e todo o vocabulário de amplificadores; o segundo fala de amplificadores esquentando ("heat", "hot"); o terceiro, de onde a Adcom fabrica seus produtos ("far", "east"). Os termos compartilhados impressos são o motivo de cada escore: o cosseno entre linhas do TF-IDF é uma soma sobre as palavras que os dois posts têm em comum.
Passo 5 — quais opções dão os melhores vizinhos?
Preveja. As contagens brutas deram 0,490 no lab de bag-of-words. Sem lista de stop words nenhuma, quanto do ganho de uma lista o idf sozinho consegue entregar? sublinear_tf ou bigramas ajudam?
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.neighbors import NearestNeighbors

def agreement(V, k=5):
    """Fração dos k posts mais próximos (cosseno) de cada post que vêm do mesmo newsgroup."""
    nn = NearestNeighbors(n_neighbors=k + 1, metric='cosine').fit(V)
    _, idx = nn.kneighbors(V)
    return (y[idx[:, 1:]] == y[:, None]).mean()

print(f"chance level:                       {np.sum(np.bincount(y) ** 2) / len(y) ** 2:.3f}")
print(f"raw counts:                         {agreement(CountVectorizer().fit_transform(docs)):.3f}")
for params in [{'min_df': 2}, {'min_df': 2, 'max_df': 0.5}, {'stop_words': 'english', 'min_df': 2},
               {'stop_words': 'english', 'min_df': 2, 'sublinear_tf': True},
               {'stop_words': 'english', 'min_df': 2, 'ngram_range': (1, 2)}]:
    V = TfidfVectorizer(**params).fit_transform(docs)
    print(f"TF-IDF {str(params)[1:-1]:60s} {agreement(V):.3f}")
chance level:                       0.251
raw counts:                         0.490
TF-IDF 'min_df': 2                                                  0.770
TF-IDF 'min_df': 2, 'max_df': 0.5                                   0.829
TF-IDF 'stop_words': 'english', 'min_df': 2                         0.850
TF-IDF 'stop_words': 'english', 'min_df': 2, 'sublinear_tf': True   0.865
TF-IDF 'stop_words': 'english', 'min_df': 2, 'ngram_range': (1, 2)  0.843
A concordância de vizinhos do lab de bag-of-words: a fração dos 5 posts mais próximos de cada post que vêm do seu newsgroup (0,251 por acaso).
- Contagens brutas: 0,490. TF-IDF sem lista de stop words: 0,770. O idf sozinho faz a maior parte do trabalho de uma lista de stop words: as palavras presentes em todo post recebem pesos perto do fundo da escala.
max_df=0.5: 0,829; a lista de stop words do inglês: 0,850. Remover de vez as palavras mais comuns ainda ajuda um pouco mais.sublinear_tf=True: 0,865, o melhor aqui: posts longos que repetem muito uma palavra já não a deixam dominar.- Bigramas: 0,843, nada melhor que as palavras sozinhas, como no lab de bag-of-words.
Para fechar a parte fundamental. Em uma frase cada: (1) por que "gato" recebe idf 1 nas três frases e por que ainda é a palavra mais pesada de d3? (2) Por que o cosseno entre duas linhas TF-IDF é só o produto escalar delas? (3) Por que a consulta "perdi a fatura" dá 0,00 com toda entrada do FAQ?
Sua vez (fundamental)
Em casa:
- Outro post. Escolha um post de cada um dos outros três newsgroups e imprima os seus oito termos mais pesados (passo 3) e os seus três posts mais próximos (passo 4). Os termos compartilhados explicam cada escore?
-
Um retrato de cada grupo. Tire a média das linhas TF-IDF de cada newsgroup (
np.asarray(T[y == c].mean(axis=0)).ravel()) e imprima os dez termos mais pesados de cada um. Compare com o retrato das contagens brutas do lab de bag-of-words, passo 3. Quais palavras de ruído somem? -
Sublinear e stop words. O passo 5 deu a melhor concordância com
sublinear_tf=True. Veja quais palavras saem do top-8 do post 14 com essa opção e explique por quê.
Abordagem avançada
A parte fundamental calculou o TF-IDF com os padrões do scikit-learn e o usou para comparar documentos e responder a consultas. Esta parte gira os três botões do vetorizador e depois mede onde toda a abordagem esparsa falha: o sentido que ela não enxerga e as palavras que ela nunca viu. Os blocos de código continuam os das seções 1 a 5.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. girar os botões; 2. o que ele não enxerga; 3. palavras que ele nunca viu. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Girar os botõessmooth_idf, sublinear_tf, norm
- O que ele não enxergasinônimos, ordem das palavras, dois sentidos
- Palavras que ele nunca viunenhuma coluna, um vetor nulo
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
7. Três botões
Etapa 1. A parte fundamental usou os padrões do TfidfVectorizer: smooth_idf=True, sublinear_tf=False e norm='l2'. Cada um deles pode ser mudado. Na linha d3 ("Gato dorme, gato sonha.", com gato duas vezes):
for params in [{}, {'smooth_idf': False}, {'sublinear_tf': True}, {'norm': None}]:
    V = TfidfVectorizer(**params).fit_transform(docs)
    print(f"{str(params):24s} d3 = {V.toarray()[2].round(4)}")
{}                       d3 = [0.     0.     0.     0.5427 0.6411 0.     0.     0.5427]
{'smooth_idf': False}    d3 = [0.     0.     0.     0.5864 0.5588 0.     0.     0.5864]
{'sublinear_tf': True}   d3 = [0.     0.     0.     0.5774 0.5774 0.     0.     0.5774]
{'norm': None}           d3 = [0.     0.     0.     1.6931 2.     0.     0.     1.6931]
smooth_idf=Falseusa \(\ln(n/\text{df}) + 1\): as palavras raras de d3 recebem \(\ln 3 + 1 = 2{,}0986\) em vez de 1,6931, enquanto "gato" fica em 1. Elas passam à frente: 0,5864 contra 0,5588;sublinear_tf=Truetroca a contagem por \(1 + \ln(\text{tf})\): as duas ocorrências de "gato" contam \(1 + \ln 2 = 1{,}6931\) em vez de 2. Por coincidência, isso é igual ao idf das palavras raras, então os três pesos de d3 ficam iguais (0,5774 cada). Uma palavra muito repetida não consegue mais dominar a própria linha;norm=Nonemantém os produtos brutos; as linhas deixam de ter comprimento 1. Documentos mais longos passam a ter vetores maiores, o que importa para a distância euclidiana mas não para o cosseno.
8. Os limites das representações esparsas
Etapa 2. O TF-IDF é rápido, não precisa de dados de treino e é fácil de ler: cada coluna é uma palavra que você pode imprimir. Sua fraqueza vem da própria construção: cada palavra é um eixo próprio, ortogonal a todas as outras. Quatro consequências medidas, cada uma num par de frases:
analyzer = CountVectorizer().build_analyzer()
pairs = {'synonyms':     ("o carro é rápido", "o automóvel é veloz"),
         'word order':   ("o cachorro mordeu o homem", "o homem mordeu o cachorro"),
         'two meanings': ("a manga da camisa rasgou", "comi uma manga madura"),
         'same meaning': ("a manga da camisa rasgou", "o punho da blusa descosturou")}
for name, (a, b) in pairs.items():
    V = TfidfVectorizer().fit_transform([a, b])
    shared = sorted(set(analyzer(a)) & set(analyzer(b)))
    print(f"{name:13s} cosine {cosine_similarity(V)[0, 1]:.2f}   shared words: {shared}")
synonyms      cosine 0.00   shared words: []
word order    cosine 1.00   shared words: ['cachorro', 'homem', 'mordeu']
two meanings  cosine 0.14   shared words: ['manga']
same meaning  cosine 0.14   shared words: ['da']
- Sinônimos dão zero. "o carro é rápido" e "o automóvel é veloz" não têm nenhum token em comum ("é" tem uma letra), então a similaridade é exatamente 0,00.
- A ordem é invisível. Quem mordeu quem não muda o vetor: 1,00.
- Uma grafia, dois sentidos. Manga é parte da camisa em "a manga da camisa rasgou" e é a fruta em "comi uma manga madura". As duas frases compartilham esse token e dão 0,14.
- Mesmo sentido, palavras diferentes. "a manga da camisa rasgou" e "o punho da blusa descosturou" descrevem quase o mesmo acontecimento, compartilham só a preposição "da" e também dão 0,14. O TF-IDF não consegue distinguir o par relacionado do par sem relação.
9. Palavras nunca vistas não têm coluna
Etapa 3. Um quinto limite: palavras nunca vistas no fit não têm coluna. Com o vetorizador ajustado nos três documentos desta página:
for new in ["o cachorro latiu", "um felino adormeceu"]:
    v = tfidf.transform([new])
    print(f"{new!r:24s} non-zeros: {v.nnz}   {dict(zip(tfidf.get_feature_names_out()[v.indices], v.data.round(2).tolist()))}")
"latiu" é descartada e "um felino adormeceu" vira o vetor nulo: uma frase sobre um gato dormindo, ao lado de documentos sobre gatos dormindo, com similaridade 0 com todos eles. Pela lei de Heaps, palavras novas nunca param de chegar.
São essas as falhas que motivaram as representações densas, em que palavras e frases de sentido parecido recebem vetores próximos mesmo sem nenhum token em comum: word embeddings e sentence embeddings. A visão geral mede quando cada família vence.
Lab avançado — um buscador TF-IDF em posts reais
O lab fundamental montou a matriz e comparou os posts entre si. Esta parte a transforma num buscador por palavras-chave, avalia o buscador em seis consultas escritas à mão e o leva até as consultas que ele não consegue responder. Continue no mesmo notebook, na mesma sessão: os passos abaixo usam docs, y, names, tfidf, T e terms dos passos 1 a 5.
Como fazer este lab em aula (cerca de 15 min, em duplas)
- Continue no notebook do lab, a partir do passo 6. Se a sessão caiu, rode antes as células dos passos 1 a 5.
- Como no lab fundamental: Preveja antes de rodar, compare com esta página e tente a Simulação antes de abrir a solução.
- Ritmo sugerido: passo 6 e a simulação em 10 min; passo 7 em 5 min.
Passo 6 — um buscador por palavras-chave
Preveja. Seis consultas, escritas à mão para os quatro grupos. Quais o TF-IDF vai responder bem: as que reusam as palavras do próprio grupo ou as que descrevem o assunto com outras palavras?
queries = {"my picture looks blurry after I enlarge it": 'comp.graphics',
           "software to convert a photo from one file format to another": 'comp.graphics',
           "the umpire made a terrible call last night": 'rec.sport.baseball',
           "why does my TV screen flicker": 'sci.electronics',
           "how to stop my circuit from overheating": 'sci.electronics',
           "does the soul survive after death": 'soc.religion.christian'}

def search(query, k=5):
    return np.argsort(-cosine_similarity(tfidf.transform([query]), T).ravel())[:k]

for q, group in queries.items():
    top = search(q)
    used = list(terms[tfidf.transform([q]).indices])
    print(f"{q}\n   {np.sum(names[y[top]] == group)}/5 from {group} · words used: {used}")
my picture looks blurry after I enlarge it
   3/5 from comp.graphics · words used: ['blurry', 'enlarge', 'looks', 'picture']
software to convert a photo from one file format to another
   5/5 from comp.graphics · words used: ['convert', 'file', 'format', 'photo', 'software']
the umpire made a terrible call last night
   3/5 from rec.sport.baseball · words used: ['night', 'terrible', 'umpire']
why does my TV screen flicker
   3/5 from sci.electronics · words used: ['does', 'screen', 'tv']
how to stop my circuit from overheating
   5/5 from sci.electronics · words used: ['circuit', 'stop']
does the soul survive after death
   2/5 from soc.religion.christian · words used: ['death', 'does', 'soul', 'survive']
Cada consulta foi escrita para um dos quatro grupos; contamos quantos dos 5 resultados vêm desse grupo: 21 de 30. A última coluna explica os erros. Quando a consulta usa o vocabulário do próprio grupo ("convert", "file", "format"; "circuit"), os 5 resultados estão certos. "flicker" e "overheating" não estão no vocabulário (menos de 2 posts), então "why does my TV screen flicker" é buscada como "does screen tv". E um post cristão raramente fala de uma "soul" que "survives" com essas palavras, mesmo quando é esse o seu assunto: 2 de 5.
Simulação: manter as palavras raras. "flicker" e "overheating" ficaram de fora das consultas porque o vocabulário guarda só palavras presentes em pelo menos 2 posts (min_df=2). Reajuste o vetorizador sem min_df, mantendo palavras vistas num único post, e rode de novo as duas consultas de eletrônica. Manter as palavras raras as salva?
Solução
tfidf_all = TfidfVectorizer(stop_words='english').fit(docs)            # min_df=1: mantém palavras vistas num único post
T_all = tfidf_all.transform(docs)
print(f"columns: {len(terms):,} with min_df=2 · {T_all.shape[1]:,} with min_df=1")
for q in ["why does my TV screen flicker", "how to stop my circuit from overheating"]:
    v = tfidf_all.transform([q])
    top = np.argsort(-cosine_similarity(v, T_all).ravel())[:5]
    print(f"{q}\n   {np.sum(names[y[top]] == queries[q])}/5 from {queries[q]} · words used: {list(tfidf_all.get_feature_names_out()[v.indices])}")
columns: 12,001 with min_df=2 · 25,411 with min_df=1
why does my TV screen flicker
   3/5 from sci.electronics · words used: ['does', 'screen', 'tv']
how to stop my circuit from overheating
   5/5 from sci.electronics · words used: ['circuit', 'overheating', 'stop']
O vocabulário mais que dobra, de 12.001 para 25.411 colunas, e a primeira consulta não se mexe: "flicker" não está em nenhum dos 2.116 posts, então nenhum limite consegue trazê-la. "overheating" agora tem coluna, porque um post a usa; a segunda consulta, que já achava 5 de 5, continua com eles. O limite não era o problema. A busca por palavras-chave precisa que as palavras da consulta estejam nos documentos, e o próximo passo mostra quantas vezes elas não estão.
Passo 7 — o que a busca por palavras-chave não enxerga
Preveja. "image" e "picture" querem dizer quase a mesma coisa num newsgroup de computação gráfica. Quantos posts os top-10 das duas consultas vão ter em comum?
col = tfidf.vocabulary_
for a, b in [('image', 'picture'), ('faith', 'belief')]:
    top_a, top_b = set(search(a, 10)), set(search(b, 10))
    n_a, n_b = (T[:, col[a]] > 0).sum(), (T[:, col[b]] > 0).sum()
    n_both = (T[:, col[a]] > 0).multiply(T[:, col[b]] > 0).sum()
    print(f"{a!r} in {n_a} posts, {b!r} in {n_b}, both in {n_both} · "
          f"top-10 results in common: {len(top_a & top_b)}")
print(tfidf.transform(["photograph of a luminous nebula"]).nnz, 'known words in the last query')
'image' in 90 posts, 'picture' in 39, both in 7 · top-10 results in common: 0
'faith' in 109 posts, 'belief' in 51, both in 22 · top-10 results in common: 0
0 known words in the last query
"image" e "picture" significam quase a mesma coisa num newsgroup de computação gráfica, mas só 7 posts contêm as duas. Os 10 melhores resultados de uma consulta não têm nenhum post em comum com os 10 melhores da outra. O mesmo vale para "faith" e "belief". A última consulta, sobre a fotografia de uma nebulosa, não tem nenhuma palavra no vocabulário destes quatro grupos: seu vetor é nulo e todo post dá 0. Esse é o limite de toda representação esparsa e o motivo dos word embeddings e dos sentence embeddings.
Para fechar a aula. Em uma frase cada: (1) o que sublinear_tf=True muda e quando ajuda? (2) Por que o TF-IDF não distingue a manga de uma camisa de uma manga madura? (3) Por que nenhum ajuste do vetorizador salva uma consulta cujas palavras não estão em nenhum documento?
Sua vez (avançado)
Em casa, com mais tempo:
-
Suas próprias consultas. Escreva três consultas para cada newsgroup: uma que reusa o vocabulário do grupo, uma que o parafraseia, uma com erro de digitação. Quantos dos 5 resultados estão certos em cada caso?
-
Expansão de consulta. Faça a função
searchacrescentar sinônimos à consulta antes de transformá-la (por exemplo, "picture" → "picture image photo"). A sobreposição dos top-10 do passo 7 muda? Qual é o risco de expandir toda consulta? - Stemming. Instale o NLTK (
pip install nltk) e passe emtokenizer=uma função que aplicaPorterStemmer().stema cada token. Quantas colunas sobram? A concordância do passo 5 muda?
Exercícios
- À mão, calcule a linha TF-IDF de d3 ("Gato dorme, gato sonha.") e confira 0,6411, 0,5427, 0,5427. Depois calcule \(\cos(d_2, d_3)\) e confira 0,191.
- Acrescente um quarto documento, "O peixe dorme.", aos três desta página. Quais valores de idf mudam? Por que o peso de "gato" em d1 sobe, se d1 não mudou?
- Com
sublinear_tf=True, qual é o peso de uma palavra que aparece 10 vezes, em relação a uma que aparece uma vez (mesmo idf)? Compare com a contagem bruta. - No buscador acima, acrescente "almoço" à entrada do restaurante. "onde almoçar no sábado" passa a achá-la? Explique com os tokens.
Material de aula
Notebook do lab
O lab desta página como notebook, pronto para o Jupyter ou o Colab: notebook do lab.
Referências
- Spärck Jones, K. "A Statistical Interpretation of Term Specificity and Its Application in Retrieval." Journal of Documentation 28, no. 1 (1972): 11–21 — a ideia por trás da frequência inversa nos documentos. DOI
- Salton, G.; Wong, A.; Yang, C. S. "A Vector Space Model for Automatic Indexing." Communications of the ACM 18, no. 11 (1975): 613–620 — documentos como vetores, comparados pelo cosseno. DOI
- Salton, G.; Buckley, C. "Term-Weighting Approaches in Automatic Text Retrieval." Information Processing & Management 24, no. 5 (1988): 513–523 — a comparação sistemática que tornou tf × idf com normalização de comprimento o padrão. DOI
- Robertson, S. "Understanding Inverse Document Frequency: On Theoretical Arguments for IDF." Journal of Documentation 60, no. 5 (2004): 503–520 — por que o logaritmo e o que o idf estima. DOI
- Manning, C. D.; Raghavan, P.; Schütze, H. Introduction to Information Retrieval. Cambridge University Press (2008) — capítulo 6: peso de termos e o modelo de espaço vetorial. Texto completo
- Lang, K. "NewsWeeder: Learning to Filter Netnews." Proceedings of ICML (1995): 331–339 — a origem da coleção 20 Newsgroups. DOI
Quiz
O quiz cobre a abordagem fundamental.