Onde o bag-of-words nos deixou
palavras que estão em toda parte
um único documento estranho
Uma lista de stop words resolve o primeiro problema, para uma língua e só para as palavras que alguém lembrou de listar.
O caminho desta parte
- Pesar as palavrastf × idf, a curva do idf
- Calcular e conferirtrês frases à mão, depois o scikit-learn
- Comparar e buscarcosseno, um pequeno buscador, um corpus real
A ideia
Spärck Jones (1972): um termo que aparece em muitos documentos é um jeito ruim de distinguir documentos, então deve contar menos.
Salton & Buckley (1988), comparando muitos esquemas de peso, fizeram do tf × idf com normalização de comprimento o padrão da recuperação de informação.
A versão do scikit-learn
\[ \text{tf-idf}(t, d) = \underbrace{\text{tf}(t, d)}_{\text{contagem de } t \text{ em } d} \times \underbrace{\Big(\ln \frac{1 + n}{1 + \text{df}(t)} + 1\Big)}_{\text{idf}(t)} \]\(n\) documentos, dos quais \(\text{df}(t)\) contêm \(t\). Depois, cada linha é dividida pelo seu comprimento (norm='l2').
"+1" dentro da fração
smooth_idf=True: como se um documento extra contivesse cada palavra uma vez. Nada de divisão por zero.
"+1" de fora
uma palavra presente em todo documento fica com peso 1, não 0: descontada, não apagada.
A curva do idf
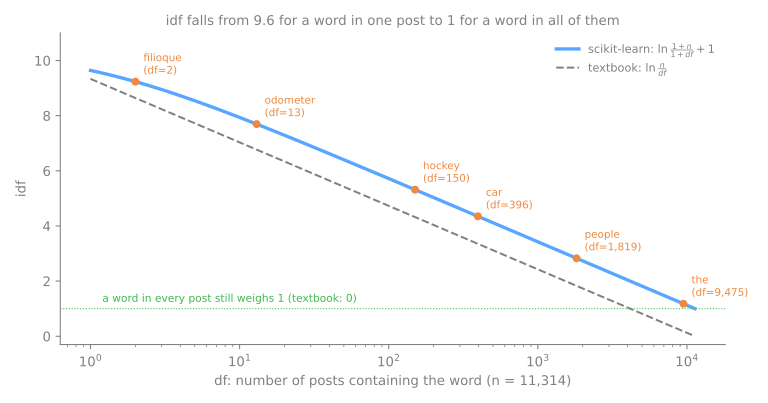
"filioque", em 2 posts: idf 9,2
"the", em quase todos: idf 1,18
TF-IDF à mão, passo a passo
As contagens da página de bag-of-words, \(n = 3\) documentos: df, os valores de idf e depois cada linha (tf × idf, o comprimento, a divisão). Preveja. Quantos valores diferentes de idf pode haver? Qual palavra de d1 vai pesar mais?
Contagens contra TF-IDF
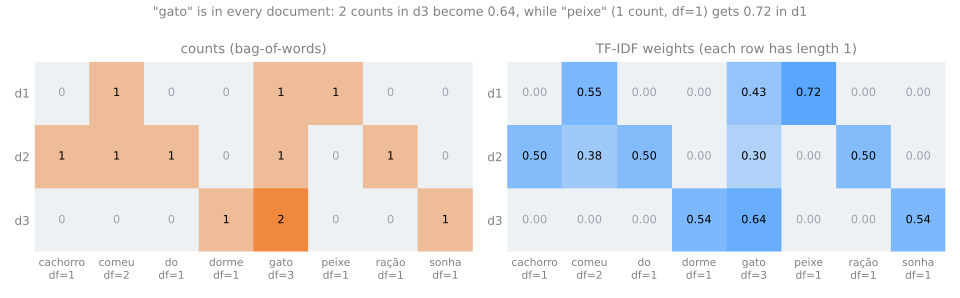
- Em d1 e d2, "gato" agora tem o menor peso não nulo: está em toda parte.
- Em d3 ele ainda tem o maior (0,64): aparece duas vezes e o tf continua contando.
Comparando documentos: o cosseno vira produto escalar
As linhas do TF-IDF têm comprimento 1, então o cosseno é só o produto escalar delas. d1 e d2 compartilham comeu e gato:
\[ \cos(d_1, d_2) = 0{,}5478 \times 0{,}3838 + 0{,}4254 \times 0{,}2980 = 0{,}2102 + 0{,}1268 = 0{,}337 \]d1 e d3 compartilham só gato: \(0{,}4254 \times 0{,}6411 = 0{,}273\).
Todas as similaridades caíram
contagens
       d1     d2     d3
d1  1.000  0.516  0.471
d2  0.516  1.000  0.365
d3  0.471  0.365  1.000
TF-IDF
       d1     d2     d3
d1  1.000  0.337  0.273
d2  0.337  1.000  0.191
d3  0.273  0.191  1.000
Um pequeno buscador
Um FAQ de central de ajuda com dez perguntas. A consulta vira vetor com o mesmo vetorizador ajustado e as perguntas são ordenadas pelo cosseno.
- "esqueci minha senha"
- "erro 0x80004005"
- "quero contestar a correção do exame"
- "onde almoçar no sábado"
- "perdi a fatura"
Duas funcionam, três falham
| consulta | escore | melhor resultado | palavras usadas |
|---|---|---|---|
| esqueci minha senha | 0,35 | FAQ 0: trocar a senha… | senha |
| erro 0x80004005 | 0,53 | FAQ 9: o erro 0x80004005… | erro, 0x80004005 |
| quero contestar a correção do exame | 0,51 | FAQ 0: trocar a senha… | do |
| onde almoçar no sábado | 0,37 | FAQ 2: segunda via do boleto… | onde |
| perdi a fatura | 0,00 | FAQ 0 (a primeira, por padrão) | — |
- Um token raro tem idf alto: um código exato é a consulta ideal para o TF-IDF.
- "contestar a correção do exame" só tem "do" em comum; a resposta certa ("revisão da nota de uma prova") não usa nenhuma palavra da consulta.
- A entrada do restaurante diz "sábados", não "sábado": um stemmer resolveria esta.
Stop words removem falsas correspondências, mas não criam as verdadeiras
quero contestar a correção do exame   best score 0.00
onde almoçar no sábado                best score 0.00
Num corpus real
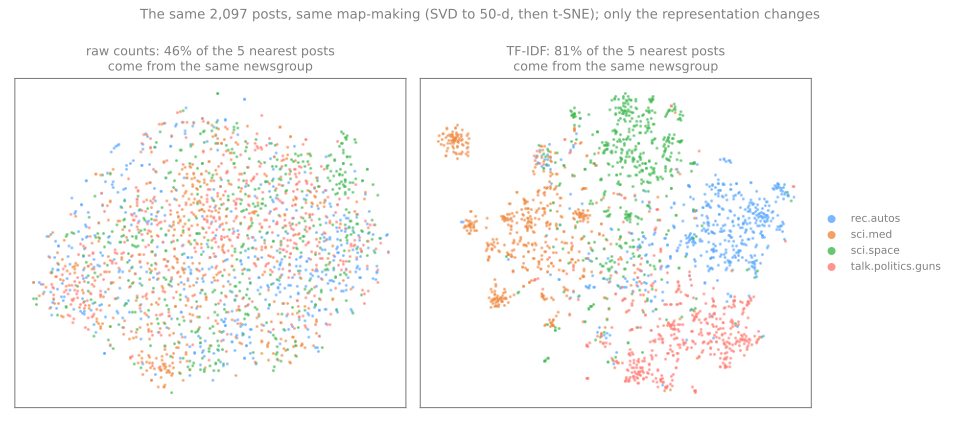
2.097 posts de quatro newsgroups, reduzidos com uma SVD (decomposição em valores singulares) truncada e desenhados com t-SNE (incorporação estocástica de vizinhos com distribuição t; a cor é o newsgroup). Os 5 vizinhos mais próximos do mesmo newsgroup: contagens 46%, TF-IDF 81% (ao acaso: cerca de 25%).
Simulador: TF-IDF e busca ao vivo
Preveja. No preset aula, desmarque smooth_idf: o idf das palavras raras sobe ou desce? Depois teste o preset sinônimos.
Resumo
- O idf desconta as palavras pelo número de documentos que as contêm; o tf continua contando as repetições.
- scikit-learn: \(\ln\frac{1+n}{1+\text{df}} + 1\), depois cada linha dividida pelo seu comprimento.
- Linhas de comprimento 1: o cosseno é um produto escalar.
- Busca: o mesmo vetorizador ajustado para documentos e consulta; tokens raros e exatos são o seu ponto forte.
A matriz TF-IDF de posts reais, passos 1 a 5
- Os mesmos quatro newsgroups do lab de bag-of-words, cerca de 2.100 posts; só scikit-learn.
- Passos: carregar os posts · a matriz e seu idf · do que um post fala, em oito palavras · os posts mais parecidos · quais opções dão os melhores vizinhos.
- Em todo passo, responda o Preveja antes de rodar. Simulação: contagens contra TF-IDF, num post (passo 3).
- Baixe o notebook do lab e abra no Jupyter ou no Colab.
Ritmo: passos 1 e 2 em 5 min; passo 3 e a simulação em 8 min; passos 4 e 5 em 12 min.