Onde o bag-of-words nos deixou
palavras que estão em toda parte
um único documento estranho
Uma lista de stop words resolve o primeiro problema, para uma língua e só para as palavras que alguém lembrou de listar.
O caminho desta aula
- Pesar as palavrastf × idf, a curva do idf
- Calcular e conferirtrês frases à mão, scikit-learn, três botões
- Comparar e buscarcosseno, um pequeno buscador, um corpus real
- Onde falhasinônimos, ordem das palavras, dois sentidos, palavras novas
A ideia
Spärck Jones (1972): um termo que aparece em muitos documentos é um jeito ruim de distinguir documentos, então deve contar menos.
Salton & Buckley (1988), comparando muitos esquemas de peso, fizeram do tf × idf com normalização de comprimento o padrão da recuperação de informação.
A versão do scikit-learn
\[ \text{tf-idf}(t, d) = \underbrace{\text{tf}(t, d)}_{\text{contagem de } t \text{ em } d} \times \underbrace{\Big(\ln \frac{1 + n}{1 + \text{df}(t)} + 1\Big)}_{\text{idf}(t)} \]\(n\) documentos, dos quais \(\text{df}(t)\) contêm \(t\). Depois, cada linha é dividida pelo seu comprimento (norm='l2').
"+1" dentro da fração
smooth_idf=True: como se um documento extra contivesse cada palavra uma vez. Nada de divisão por zero.
"+1" de fora
uma palavra presente em todo documento fica com peso 1, não 0: descontada, não apagada.
A curva do idf
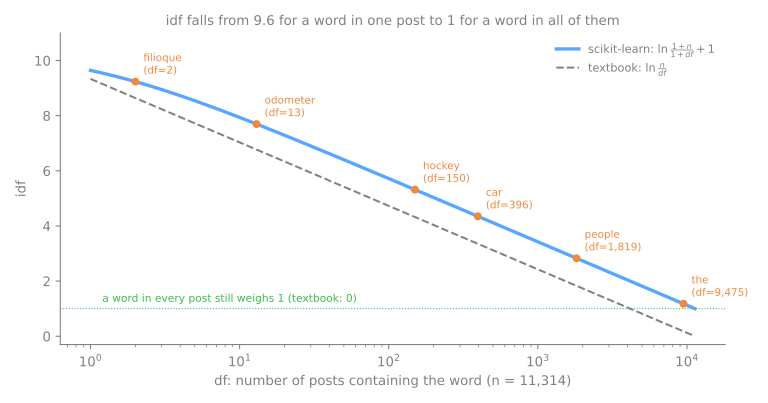
"filioque", em 2 posts: idf 9,2
"the", em quase todos: idf 1,18
À mão, em três frases
| cachorro | comeu | do | dorme | gato | peixe | ração | sonha | |
|---|---|---|---|---|---|---|---|---|
| d1 | 0 | 1 | 0 | 0 | 1 | 1 | 0 | 0 |
| d2 | 1 | 1 | 1 | 0 | 1 | 0 | 1 | 0 |
| d3 | 0 | 0 | 0 | 1 | 2 | 0 | 0 | 1 |
as contagens da página de bag-of-words: "O gato comeu o peixe.", "O cachorro comeu a ração do gato.", "Gato dorme, gato sonha."
Só três valores de idf
"gato", em 3 documentos
\[ \ln\tfrac{4}{4} + 1 = 1 \]"comeu", em 2
\[ \ln\tfrac{4}{3} + 1 = 1{,}2877 \]todas as outras, em 1
\[ \ln\tfrac{4}{2} + 1 = 1{,}6931 \]A linha d1, passo a passo
d1 = "gato comeu peixe", cada palavra uma vez.
| gato | comeu | peixe | |
|---|---|---|---|
| 1. tf × idf | 1 | 1,2877 | 1,6931 |
| 2. comprimento | \(\sqrt{1^2 + 1{,}2877^2 + 1{,}6931^2} = \sqrt{5{,}5249} = 2{,}3505\) | ||
| 3. dividir por ele | 0,4254 | 0,5478 | 0,7203 |
O scikit-learn confirma
tfidf = TfidfVectorizer()          # padrões: smooth_idf=True, norm='l2', sublinear_tf=False
T = tfidf.fit_transform(docs)
    cachorro   comeu      do   dorme    gato   peixe   ração   sonha
d1    0.0000  0.5478  0.0000  0.0000  0.4254  0.7203  0.0000  0.0000
d2    0.5046  0.3838  0.5046  0.0000  0.2980  0.0000  0.5046  0.0000
d3    0.0000  0.0000  0.0000  0.5427  0.6411  0.0000  0.0000  0.5427
same idf as by hand: True
A linha d1 bate com a conta à mão até a quarta casa decimal. O TfidfVectorizer é o CountVectorizer seguido deste mesmo peso.
Contagens contra TF-IDF
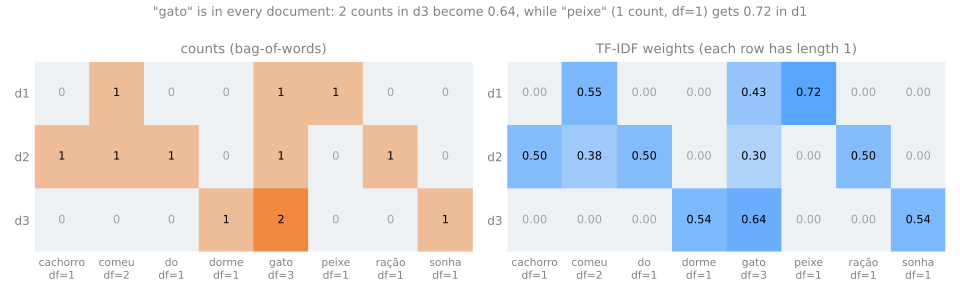
- Em d1 e d2, "gato" agora tem o menor peso não nulo: está em toda parte.
- Em d3 ele ainda tem o maior (0,64): aparece duas vezes e o tf continua contando.
Três botões, na linha d3
| opção | dorme | gato | sonha |
|---|---|---|---|
| padrão | 0,5427 | 0,6411 | 0,5427 |
smooth_idf=False | 0,5864 | 0,5588 | 0,5864 |
sublinear_tf=True | 0,5774 | 0,5774 | 0,5774 |
norm=None | 1,6931 | 2 | 1,6931 |
smooth_idf=False: \(\ln(n/\text{df}) + 1\); as palavras raras recebem \(\ln 3 + 1 = 2{,}0986\) e passam à frente de "gato".sublinear_tf=True: contagem → \(1 + \ln(\text{tf})\); os dois "gato" contam \(1{,}6931\), igual ao idf das raras por coincidência.norm=None: produtos brutos; documentos mais longos têm vetores maiores (importa para a distância euclidiana, não para o cosseno).
Comparando documentos: o cosseno vira produto escalar
As linhas do TF-IDF têm comprimento 1, então o cosseno é só o produto escalar delas. d1 e d2 compartilham comeu e gato:
\[ \cos(d_1, d_2) = 0{,}5478 \times 0{,}3838 + 0{,}4254 \times 0{,}2980 = 0{,}2102 + 0{,}1268 = 0{,}337 \]d1 e d3 compartilham só gato: \(0{,}4254 \times 0{,}6411 = 0{,}273\).
Todas as similaridades caíram
contagens
       d1     d2     d3
d1  1.000  0.516  0.471
d2  0.516  1.000  0.365
d3  0.471  0.365  1.000
TF-IDF
       d1     d2     d3
d1  1.000  0.337  0.273
d2  0.337  1.000  0.191
d3  0.273  0.191  1.000
Um pequeno buscador
Um FAQ de central de ajuda com dez perguntas. A consulta vira vetor com o mesmo vetorizador ajustado e as perguntas são ordenadas pelo cosseno.
- "esqueci minha senha"
- "erro 0x80004005"
- "quero contestar a correção do exame"
- "onde almoçar no sábado"
- "perdi a fatura"
Duas funcionam, três falham
| consulta | escore | melhor resultado | palavras usadas |
|---|---|---|---|
| esqueci minha senha | 0,35 | FAQ 0: trocar a senha… | senha |
| erro 0x80004005 | 0,53 | FAQ 9: o erro 0x80004005… | erro, 0x80004005 |
| quero contestar a correção do exame | 0,51 | FAQ 0: trocar a senha… | do |
| onde almoçar no sábado | 0,37 | FAQ 2: segunda via do boleto… | onde |
| perdi a fatura | 0,00 | FAQ 0 (a primeira, por padrão) | — |
- Um token raro tem idf alto: um código exato é a consulta ideal para o TF-IDF.
- "contestar a correção do exame" só tem "do" em comum; a resposta certa ("revisão da nota de uma prova") não usa nenhuma palavra da consulta.
- A entrada do restaurante diz "sábados", não "sábado": um stemmer resolveria esta.
Stop words removem falsas correspondências, mas não criam as verdadeiras
quero contestar a correção do exame   best score 0.00
onde almoçar no sábado                best score 0.00
Num corpus real
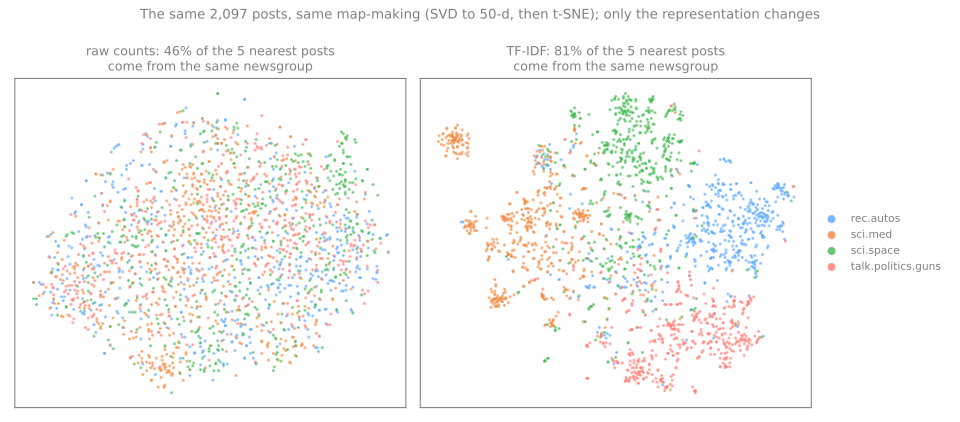
2.097 posts de quatro newsgroups, reduzidos com uma SVD (decomposição em valores singulares) truncada e desenhados com t-SNE (a cor é o newsgroup). Os 5 vizinhos mais próximos do mesmo newsgroup: contagens 46%, TF-IDF 81% (ao acaso: cerca de 25%).
Os limites das representações esparsas
Cada palavra é um eixo próprio, ortogonal a todas as outras.
| par | cosseno | palavras em comum |
|---|---|---|
| sinônimos: o carro é rápido / o automóvel é veloz | 0,00 | nenhuma |
| ordem: o cachorro mordeu o homem / o homem mordeu o cachorro | 1,00 | cachorro, homem, mordeu |
| dois sentidos: a manga da camisa rasgou / comi uma manga madura | 0,14 | manga |
| mesmo sentido: a manga da camisa rasgou / o punho da blusa descosturou | 0,14 | da |
E uma quinta: palavras nunca vistas não têm coluna
'o cachorro latiu'       non-zeros: 1   {'cachorro': 1.0}
'um felino adormeceu'    non-zeros: 0   {}
Uma frase sobre um gato dormindo, ao lado de documentos sobre gatos dormindo, com similaridade 0 com todos eles.
Simulador: TF-IDF e busca ao vivo
Preveja. No preset aula, desmarque smooth_idf: o idf das palavras raras sobe ou desce? Depois teste o preset sinônimos.
Resumo
- O idf desconta as palavras pelo número de documentos que as contêm; o tf continua contando repetições.
- scikit-learn: \(\ln\frac{1+n}{1+\text{df}} + 1\); depois, cada linha é dividida pelo seu comprimento.
- Linhas de comprimento 1: o cosseno é um produto escalar.
- Busca: o mesmo vetorizador ajustado para documentos e consulta; tokens raros e exatos são o seu forte.
- Cada palavra é um eixo próprio: sinônimos dão 0, a ordem é invisível, palavras novas somem.
Um buscador TF-IDF em posts reais
- Quatro newsgroups (computação gráfica, beisebol, eletrônica e cristianismo), cerca de 2.100 posts.
- Passos: carregar os posts · a matriz TF-IDF e seu idf · do que um post fala, em oito palavras · os posts mais parecidos · quais opções dão os melhores vizinhos? · um buscador por palavras-chave · o que a busca por palavras-chave não enxerga.
- Baixe o notebook do lab e abra no Jupyter ou no Colab.