E2.3 Word Embeddings
O bag-of-words e o TF-IDF dão a cada palavra uma coluna própria. As colunas são ortogonais, então "carro" e "automóvel" são tão pouco relacionados quanto "carro" e "banana": a representação sabe quais palavras um documento contém, mas nada sobre o que elas significam. Um word embedding (vetor de palavra) troca a coluna por um vetor curto e denso (de 50 a 300 números), aprendido a partir de muito texto e arranjado de modo que palavras usadas de jeitos parecidos recebam vetores parecidos.
Esta página constrói vetores de palavras de três jeitos, do mais simples ao mais usado. Primeiro à mão: contar quais palavras aparecem ao lado de quais em onze frases, repesar as contagens e comprimi-las com a mesma SVD truncada que você usou em redução de dimensionalidade. Depois, o word2vec, que aprende os vetores por predição, junto com seus primos GloVe e fastText. Por fim, vetores pré-treinados, treinados por outra pessoa em bilhões de palavras, que você baixa e explora: vizinhos mais próximos, similaridades, as famosas analogias (medidas com honestidade, com os erros), os vieses sociais que eles absorvem e o limite que motiva a próxima página: um vetor por palavra, qualquer que seja o sentido. Todo número abaixo sai do código ao lado; a visão geral situa esta página entre as quatro abordagens.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Como um computador aprende o que uma palavra significa a partir das palavras em volta dela? | Que outros caminhos levam a vetores de palavras e até onde se pode confiar na geometria deles? |
| conteúdo | a hipótese distribucional, contagens de coocorrência, PMI e PPMI, SVD truncada, word2vec (skip-gram, CBOW, amostragem negativa), vetores GloVe pré-treinados, relação contra sinonímia, analogias, um vetor por palavra | análise semântica latente, GloVe e fastText, a regra de exclusão por trás das analogias, deslocamentos medidos, uma direção de gênero e o que ela mostra |
| lab em aula | text8: contar, prever e baixar, passos 1 a 5 | o teste de analogias, palavras nunca vistas e um mapa, passos 6 a 8 |
| ao final, você sabe | montar uma linha de coocorrência e calcular a PMI à mão; dizer o que a PPMI tira e o que a SVD acrescenta; dizer o que o skip-gram e o CBOW preveem; ler vizinhos mais próximos e separar relação de sinonímia | distinguir um vizinho de assunto de um vizinho de tipo; dizer o que os pedaços do fastText ganham e custam; ler uma nota de analogias sem se enganar com a regra de exclusão; medir uma direção de viés e apontar seus cuidados |
Os dois labs usam o mesmo notebook do lab, para abrir no Colab (File → Upload notebook) ou no Jupyter: a parte fundamental vai do passo 1 ao 5; a avançada, do 6 ao 8. No Colab, rode !pip install gensim na primeira célula.
Abordagem fundamental
Uma pergunta guia esta parte: como um computador aprende o que uma palavra significa usando só as palavras em volta dela? A resposta é uma cadeia que dá para seguir à mão em onze frases: contar quais palavras aparecem ao lado de quais, guardar as contagens mais frequentes do que o acaso e comprimir o que sobra em poucos números densos por palavra. O word2vec chega a vetores parecidos por predição; os vetores pré-treinados mostram o que o método dá com bilhões de palavras, inclusive o que ele erra.
Esta parte segue um caminho em quatro etapas, desenhado abaixo: 1. contexto → sentido, a ideia de que uma palavra é conhecida pelos seus vizinhos; 2. contar e comprimir, das contagens de coocorrência a vetores densos, com a PPMI (informação mútua pontual positiva) e a SVD (decomposição em valores singulares) truncada; 3. aprender prevendo, com o word2vec; 4. explorar o espaço, com vetores pré-treinados, seus vizinhos, suas analogias e seu limite. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Contexto → sentidoa hipótese distribucional
- Contar e comprimircontagens de coocorrência → PPMI → SVD truncada
- Aprender prevendoskip-gram, CBOW, amostragem negativa
- Explorar o espaçovizinhos, relação, analogias, um vetor por palavra
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. A hipótese distribucional
Etapa 1. Leia estas quatro frases sobre uma palavra que talvez você nunca tenha visto:
- Um copo de tiquira gelada.
- A tiquira é feita de mandioca fermentada.
- Bebeu tiquira demais e passou mal.
- No Maranhão, servem tiquira nas festas.
Agora você sabe que tiquira é uma bebida alcoólica, provavelmente forte, do Nordeste, embora ninguém a tenha definido. Você deduziu pelas companhias da palavra: copo, gelada, fermentada, bebeu, demais, festas. Palavras que aparecem nesses contextos são bebidas. Essa é a hipótese distribucional: palavras que ocorrem em contextos parecidos tendem a ter significados parecidos (Harris, 1954), ou, na frase de Firth (1957), "you shall know a word by the company it keeps" ("conhecerás uma palavra pelas companhias que ela mantém").
A hipótese transforma significado em algo que se pode contar. Se duas palavras vivem aparecendo ao lado dos mesmos vizinhos, seus vetores devem ficar próximos. Tudo nesta página é uma maneira de transformar "quais palavras aparecem ao lado de quais" em vetores.
2. Das contagens de coocorrência aos vetores
Um corpus de brinquedo e sua matriz de coocorrência
Etapa 2. Onze frases curtas: animais que comem e bebem; veículos que andam com combustível. O corpus foi montado para que alguns pares de palavras (gato/cachorro, carro/automóvel) nunca apareçam na mesma frase, mas compartilhem os vizinhos. Para cada palavra, conte quantas vezes cada outra palavra aparece dentro de uma janela de duas palavras à esquerda ou à direita:
import numpy as np
import pandas as pd

corpus = ["o gato bebe leite", "o gato come peixe",
          "o cachorro bebe água", "o cachorro come carne",
          "o cachorro corre na rua",
          "o carro usa gasolina", "o carro corre na estrada",
          "o automóvel usa gasolina", "o automóvel anda na estrada",
          "o caminhão usa diesel", "o caminhão corre na estrada"]
sentences = [s.split() for s in corpus]
vocab = sorted({w for s in sentences for w in s})
idx = {w: i for i, w in enumerate(vocab)}

window = 2
C = np.zeros((len(vocab), len(vocab)), dtype=int)     # linhas: palavras · colunas: palavras de contexto
for s in sentences:
    for i, w in enumerate(s):
        for j in range(max(0, i - window), min(len(s), i + window + 1)):
            if j != i:
                C[idx[w], idx[s[j]]] += 1

print(len(vocab), 'words ·', C.sum(), '(word, context) pairs')
for w in ['gato', 'cachorro', 'carro', 'automóvel']:
    print(f"{w:10s}", {vocab[j]: int(C[idx[w], j]) for j in np.flatnonzero(C[idx[w]])})
20 words · 126 (word, context) pairs
gato       {'bebe': 1, 'come': 1, 'leite': 1, 'o': 2, 'peixe': 1}
cachorro   {'bebe': 1, 'carne': 1, 'come': 1, 'corre': 1, 'na': 1, 'o': 3, 'água': 1}
carro      {'corre': 1, 'gasolina': 1, 'na': 1, 'o': 2, 'usa': 1}
automóvel  {'anda': 1, 'gasolina': 1, 'na': 1, 'o': 2, 'usa': 1}
Confira uma linha à mão. "gato" aparece em duas frases. Em "o gato bebe leite", a janela de duas palavras em volta contém o, bebe e leite; em "o gato come peixe", contém o, come e peixe. Então o é contado duas vezes e as outras uma: exatamente a linha impressa. A matriz é 20 × 20: uma linha por palavra e uma coluna por palavra de contexto possível. Cada linha é o perfil de contextos daquela palavra.
Documentos versus contextos: a ponte a partir do bag-of-words
A matriz do bag-of-words também tem uma coluna por palavra, mas suas linhas são documentos. Compare as duas maneiras de descrever uma palavra, sua coluna no bag-of-words (quais frases a contêm) e sua linha na matriz de coocorrência (quais palavras a cercam), com a similaridade de cosseno da página de TF-IDF:
from sklearn.feature_extraction.text import CountVectorizer

def cos(u, v):
    return u @ v / (np.linalg.norm(u) * np.linalg.norm(v))

D = CountVectorizer(token_pattern=r'\S+', vocabulary=vocab).fit_transform(corpus).toarray()
print('bag-of-words matrix:', D.shape, '(sentences x words)')
pairs = [('gato', 'cachorro'), ('carro', 'automóvel'), ('gato', 'carro')]
for a, b in pairs:
    print(f"{a:5s} / {b:9s}   bag-of-words columns {cos(D[:, idx[a]], D[:, idx[b]]):.2f}   "
          f"co-occurrence rows {cos(C[idx[a]], C[idx[b]]):.2f}")
bag-of-words matrix: (11, 20) (sentences x words)
gato  / cachorro    bag-of-words columns 0.00   co-occurrence rows 0.73
carro / automóvel   bag-of-words columns 0.00   co-occurrence rows 0.87
gato  / carro       bag-of-words columns 0.00   co-occurrence rows 0.50
Como colunas do bag-of-words, os três pares dão 0,00: nenhuma frase contém as duas palavras. Como linhas de contexto, "carro" e "automóvel" dão 0,87, porque as duas vêm seguidas de usa gasolina e de na. Esta é a ideia inteira numa tabela: palavras parecidas raramente aparecem juntas, mas aparecem ao lado das mesmas palavras.
A última linha mostra o problema que sobra. "gato" e "carro" dão 0,50, só um pouco abaixo do gato e do cachorro (0,73). Todo substantivo do corpus vem logo depois do artigo o, então toda linha de substantivo tem uma contagem alta na coluna o; essa contagem compartilhada e sem informação domina o cosseno. O mesmo acontece em texto real com de, a e the.
PPMI: contando o que surpreende
A correção é perguntar não "quantas vezes w e c aparecem juntas?", mas "quanto mais do que o acaso preveria?". Se a palavra e o contexto fossem independentes, o par apareceria com probabilidade \(P(w)\,P(c)\). A informação mútua pontual (PMI) compara a probabilidade observada com essa (Church & Hanks, 1990):
em que \(n(w, c)\) é a contagem da célula, \(n(w)\) o total da linha, \(n(c)\) o total da coluna e \(N\) o total da matriz. A PMI é 0 quando o par aparece exatamente com a frequência que o acaso prevê e positiva quando aparece mais. À mão, para duas células da linha "gato":
N = C.sum()
n_word = C.sum(axis=1)          # quantas vezes cada palavra é palavra central
n_ctx = C.sum(axis=0)           # quantas vezes cada palavra é contexto
for w, c in [('gato', 'bebe'), ('gato', 'o')]:
    n = C[idx[w], idx[c]]
    pmi = np.log2(n * N / (n_word[idx[w]] * n_ctx[idx[c]]))
    print(f"PMI({w}, {c}) = log2({n} x {N} / ({n_word[idx[w]]} x {n_ctx[idx[c]]})) = {pmi:.2f}")
Nas contagens brutas, o era o contexto mais forte de "gato" (2 contra 1). Na PMI a ordem se inverte: o aparece 22 vezes como contexto, ao lado de tudo, então vê-lo ao lado de "gato" quase não surpreende (0,93), enquanto bebe aparece só 6 vezes e 1 delas é com "gato" (1,81). Pares nunca vistos têm \(\log 0 = -\infty\) e valores negativos de PMI são pouco confiáveis com contagens pequenas; por isso, a escolha padrão é cortá-los em zero: a PMI positiva, \(\text{PPMI} = \max(\text{PMI}, 0)\).
with np.errstate(divide='ignore'):                 # log2(0) = -inf para pares nunca vistos
    PMI = np.log2(C * N / np.outer(n_word, n_ctx))
PPMI = np.maximum(PMI, 0)
for w in ['gato', 'cachorro']:
    print(f"{w:9s}", {vocab[j]: round(float(PPMI[idx[w], j]), 2) for j in np.flatnonzero(PPMI[idx[w]])})
for a, b in pairs:
    print(f"{a:5s} / {b:9s}   counts {cos(C[idx[a]], C[idx[b]]):.2f}   PPMI {cos(PPMI[idx[a]], PPMI[idx[b]]):.2f}")
gato      {'bebe': 1.81, 'come': 1.81, 'leite': 3.39, 'o': 0.93, 'peixe': 3.39}
cachorro  {'bebe': 1.22, 'carne': 2.81, 'come': 1.22, 'corre': 0.22, 'na': 0.22, 'o': 0.93, 'água': 2.81}
gato  / cachorro    counts 0.73   PPMI 0.22
carro / automóvel   counts 0.87   PPMI 0.75
gato  / carro       counts 0.50   PPMI 0.05
Agora a coluna o está entre as menores de cada linha e o par gato/carro cai de 0,50 para 0,05: a similaridade que vinha do artigo sumiu. Mas sumiu também boa parte da similaridade entre o gato e o cachorro, que cai de 0,73 para 0,22. Os dois animais compartilham só bebe e come; seus outros contextos (leite, peixe, água, carne) são quatro palavras diferentes; num espaço de 20 colunas, quatro palavras diferentes são quatro direções ortogonais. As linhas da PPMI acertam quanto ao que é informativo, mas são literais demais: não sabem que leite, água, peixe e carne são, eles próprios, parecidos.
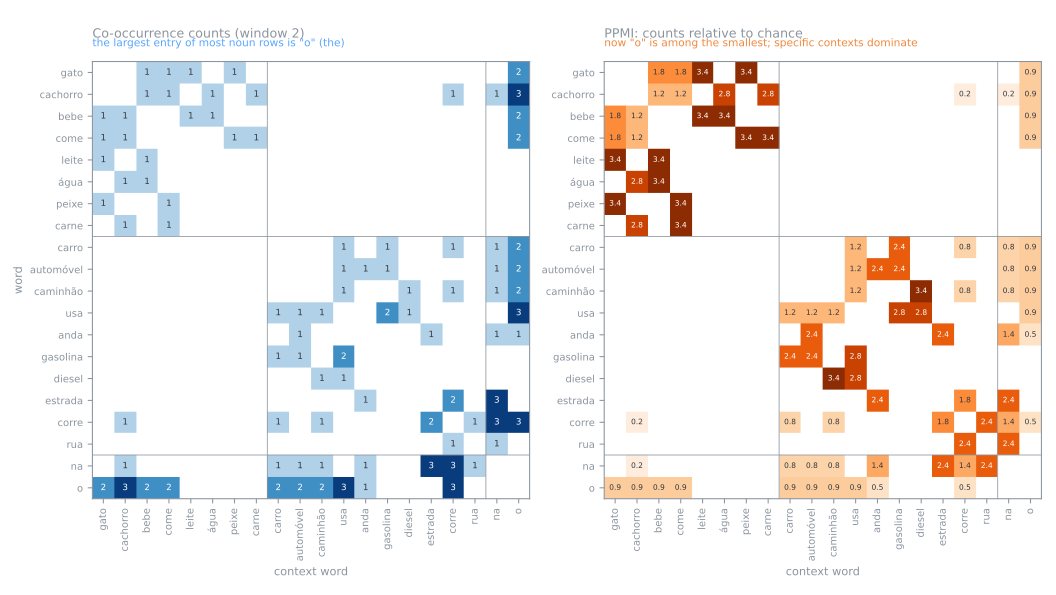
O simulador refaz esta seção na linha de "gato", uma célula por vez: as duas janelas que preenchem a linha, os totais, cada PMI como a razão entre a contagem observada e a contagem esperada ao acaso, o corte em zero e, no fim, os cossenos dos três pares com contagens e com PPMI. Antes de avançar, preveja qual contexto de "gato" vai do primeiro ao último lugar.
SVD truncada: de 20 colunas esparsas a 2 números densos
Comprimir a matriz PPMI é o que liga "leite" a "água": os dois recebem vetores parecidos porque as palavras em volta deles (bebe e os animais) são as mesmas. A ferramenta é a SVD truncada, a versão do PCA que trabalha sem centralizar a matriz. Ela guarda as \(k\) direções que mais explicam a matriz e dá a cada palavra \(k\) coordenadas. Com \(k = 2\):
from sklearn.decomposition import TruncatedSVD

svd = TruncatedSVD(n_components=2, random_state=0)
Z = svd.fit_transform(PPMI)                        # uma linha de 2 números por palavra
print(pd.DataFrame(Z, index=vocab, columns=['dim 1', 'dim 2'])
        .loc[['gato', 'cachorro', 'leite', 'carro', 'automóvel', 'gasolina', 'o']].round(2))

table = pd.DataFrame({
    'BoW columns': [cos(D[:, idx[a]], D[:, idx[b]]) for a, b in pairs],
    'counts': [cos(C[idx[a]], C[idx[b]]) for a, b in pairs],
    'PPMI': [cos(PPMI[idx[a]], PPMI[idx[b]]) for a, b in pairs],
    'PPMI + SVD': [cos(Z[idx[a]], Z[idx[b]]) for a, b in pairs]},
    index=[f"{a} / {b}" for a, b in pairs])
print(table.to_string(float_format=lambda v: f"{v:.2f}"))
           dim 1  dim 2
gato        3.77  -0.97
cachorro    2.55  -0.35
leite       2.78  -0.79
carro       0.61   1.87
automóvel   0.70   2.28
gasolina    0.64   2.44
o           1.77   1.05
                   BoW columns  counts  PPMI  PPMI + SVD
gato / cachorro           0.00    0.73  0.22        0.99
carro / automóvel         0.00    0.87  0.75        1.00
gato / carro              0.00    0.50  0.05        0.06
Leia a primeira tabela: toda palavra de animal e comida tem a primeira coordenada grande e a segunda negativa, toda palavra de veículo e combustível o contrário. Os dois números são um vetor de palavra denso. Ninguém disse à SVD quais palavras são animais: ela achou as duas direções porque os dois grupos compartilham contextos dentro de cada grupo e não entre eles.
A segunda tabela resume esta seção em quatro colunas. O bag-of-words não vê nada (0,00 em tudo). As contagens brutas veem tudo como parecido, inclusive gato e carro (0,50). A PPMI tira o artigo, mas fica literal demais (gato/cachorro 0,22). PPMI seguida de SVD acerta os três pares: gato/cachorro 0,99, carro/automóvel 1,00, gato/carro 0,06.
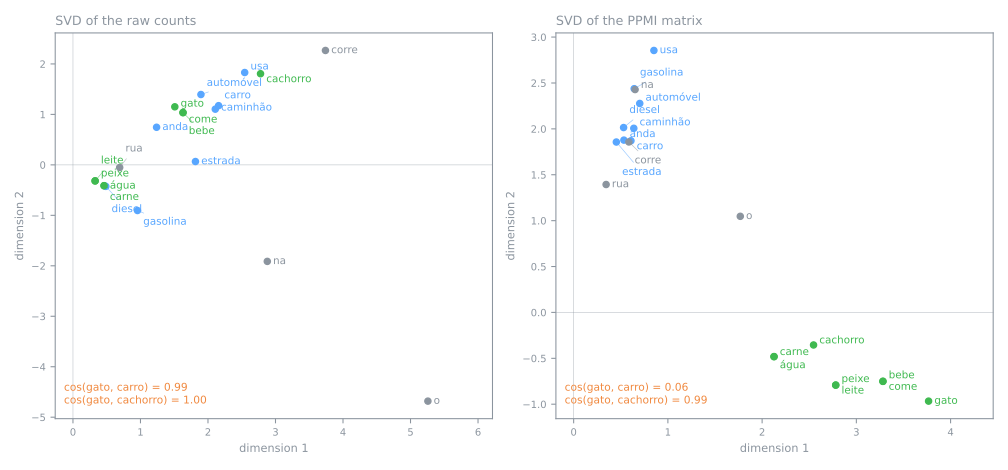
O painel da esquerda é a SVD das contagens brutas: a primeira direção só mede frequência (o artigo o fica isolado, longe dos demais); animais e veículos se misturam ao longo dela. O painel da direita é a SVD da PPMI.
Esta receita (contar coocorrências numa janela, repesar com PPMI, reduzir com SVD) é um método completo de vetores de palavras e ainda competitivo: o lab a aplica a um milhão de palavras da Wikipédia em poucos segundos e a compara com os métodos abaixo. Num corpus real a matriz tem milhares de linhas e \(k\) vai de 100 a 300; é o mesmo código com uma matriz esparsa.
3. word2vec: aprendendo vetores por predição
Skip-gram e CBOW
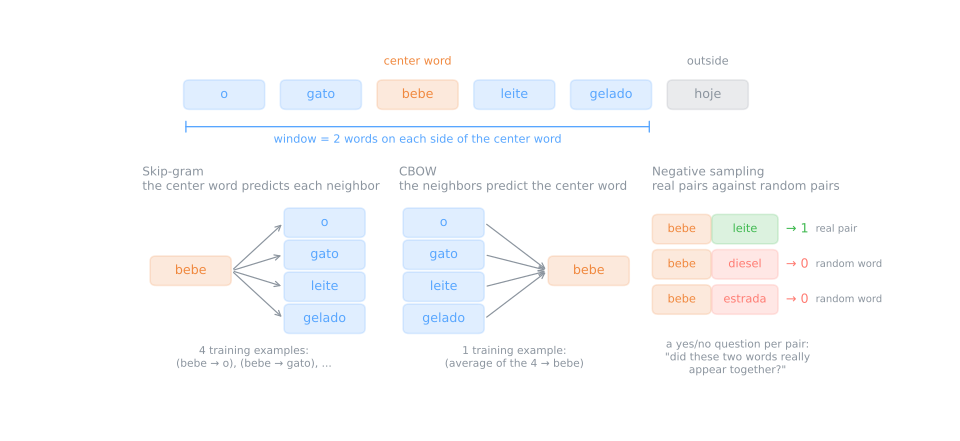
Etapa 3. O word2vec (Mikolov et al., 2013a) chega a vetores parecidos por outro caminho: em vez de contar e fatorar, ele prevê. Ele desliza uma janela pelo texto e transforma cada posição em exemplos de treino. A variante skip-gram pede à palavra central que preveja cada um de seus vizinhos; a variante CBOW (continuous bag-of-words) pede aos vizinhos, em média, que prevejam a palavra central:
sentence = "o gato bebe leite gelado hoje".split()
skipgram = [(sentence[i], sentence[j]) for i in range(len(sentence))
            for j in range(max(0, i - window), min(len(sentence), i + window + 1)) if j != i]
cbow = [([sentence[j] for j in range(max(0, i - window), min(len(sentence), i + window + 1)) if j != i],
         sentence[i]) for i in range(len(sentence))]
print(len(skipgram), 'skip-gram examples (center -> context), e.g.', skipgram[5:9])
print(len(cbow), 'CBOW examples (contexts -> center), e.g.', cbow[2])
18 skip-gram examples (center -> context), e.g. [('bebe', 'o'), ('bebe', 'gato'), ('bebe', 'leite'), ('bebe', 'gelado')]
6 CBOW examples (contexts -> center), e.g. (['o', 'gato', 'leite', 'gelado'], 'bebe')
Cada palavra começa com um vetor aleatório de, digamos, 100 números. O modelo dá uma nota a um par (central, contexto) pelo produto escalar dos dois vetores; o treino empurra os vetores para que os pares que de fato ocorrem recebam notas altas. A frase de seis palavras já rende 18 exemplos de skip-gram; um corpus de um bilhão de palavras rende bilhões. Palavras que aparecem nos mesmos contextos recebem os mesmos empurrões, então seus vetores se aproximam: é a hipótese distribucional transformada em otimização.
Amostragem negativa, em um parágrafo
Prever "qual das 100 mil palavras do vocabulário é o vizinho?" exigiria calcular uma nota para as 100 mil palavras a cada passo. A amostragem negativa (Mikolov et al., 2013b) troca isso por uma pergunta de sim ou não, muito mais barata: essas duas palavras apareceram mesmo juntas? Para cada par real, como (bebe, leite), sorteiam-se algumas palavras aleatórias do vocabulário (tipicamente de 5 a 20) e formam-se pares falsos, como (bebe, diesel). O modelo transforma cada produto escalar num número entre 0 e 1 e é treinado para responder 1 ao par real e 0 aos falsos. As palavras aleatórias são sorteadas com probabilidade proporcional à frequência elevada a 0,75, para que as palavras muito comuns não sejam os únicos negativos. Levy & Goldberg (2014) mostraram depois que o skip-gram com amostragem negativa está, na prática, fatorando uma matriz de PMI deslocada: o caminho da predição e o caminho da contagem da seção anterior levam ao mesmo lugar.
Treinando o word2vec com o gensim
A biblioteca gensim treina o word2vec numa chamada; o lab faz isso com um milhão de palavras da Wikipédia. Os parâmetros são os de cima:
vector_size: números por palavra (de 100 a 300 é o típico);window: quantas palavras de cada lado contam como contexto. Janelas pequenas (2–5) favorecem palavras com a mesma função (outros verbos no mesmo tempo); janelas grandes (10+) favorecem palavras do mesmo assunto;sg=1para skip-gram,sg=0para CBOW. O skip-gram é mais lento e melhor para palavras raras; o CBOW é mais rápido;negative: quantas palavras aleatórias por par real;min_count: palavras mais raras que isso são descartadas (têm contextos de menos para aprender);epochs: passadas pelo texto;seedeworkers=1tornam o resultado reprodutível.
4. Explorando vetores pré-treinados
Etapa 4. Treinar bons vetores exige bilhões de palavras. Na prática, você baixa vetores que outra pessoa treinou. O gensim baixa os vetores GloVe (Pennington, Socher & Manning, 2014: um primo do word2vec baseado em contagem, descrito na parte avançada) treinados em 6 bilhões de tokens, na versão menor (400 mil palavras, 50 números cada). Eles estão em inglês; por isso, os exemplos daqui em diante também:
import gensim.downloader as api

glove = api.load('glove-wiki-gigaword-50')     # ~66 MB, baixado uma vez
print(len(glove.key_to_index), 'words ·', glove.vector_size, 'numbers per word')
print('car =', glove['car'][:6].round(2), '...')
for w in ['car', 'mango', 'doctor', 'brazil', 'python']:
    print(f"{w:7s}", ', '.join(f"{n} {s:.2f}" for n, s in glove.most_similar(w, topn=5)))
400000 words · 50 numbers per word
car = [ 0.48 -0.08  1.46  0.05  0.15  0.51] ...
car     truck 0.92, cars 0.89, vehicle 0.88, driver 0.85, driving 0.84
mango   pineapple 0.91, guava 0.90, papaya 0.89, pear 0.85, coconut 0.85
doctor  nurse 0.80, physician 0.80, patient 0.76, child 0.76, teacher 0.75
brazil  portugal 0.88, argentina 0.87, rica 0.84, spain 0.83, costa 0.83
python  reticulated 0.69, spamalot 0.66, php 0.64, owl 0.63, mouse 0.63
most_similar devolve as palavras de maior similaridade de cosseno. Nenhum número isolado do vetor significa algo ("car" começa com 0,48, −0,08, 1,46, ...); só a geometria tem significado. Os vizinhos parecem um dicionário de ideias afins: "mango" (manga, a fruta) está cercada de frutas tropicais, "brazil" de outros países latinos (e de "rica" e "costa", as duas metades de Costa Rica, porque o tokenizador separou o nome). "python" mostra de onde esses vetores aprenderam: a cobra (reticulated), o Monty Python (spamalot) e linguagens de programação (php), misturados numa lista só.
Parecido não é sinônimo
A similaridade de cosseno mede o quanto duas palavras são intercambiáveis no contexto, o que não é o mesmo que significarem a mesma coisa:
for a, b in [('car', 'automobile'), ('coffee', 'tea'), ('doctor', 'physician'), ('hot', 'cold'),
             ('good', 'bad'), ('love', 'hate'), ('car', 'banana'), ('doctor', 'guitar')]:
    print(f"{a:6s} / {b:10s} {glove.similarity(a, b):.2f}")
car    / automobile 0.70
coffee / tea        0.81
doctor / physician  0.80
hot    / cold       0.80
good   / bad        0.80
love   / hate       0.65
car    / banana     0.22
doctor / guitar     0.28
Sinônimos dão nota alta (doctor/physician, médico/médico, 0,80), mas antônimos também: hot/cold (quente/frio) e good/bad (bom/ruim) dão 0,80, o mesmo que doctor/physician e mais que car/automobile (0,70). Um antônimo é a palavra mais intercambiável que existe: "a sopa está quente" e "a sopa está fria" diferem numa palavra; todo contexto de uma serve para a outra. A hipótese distribucional mede relação, não sinonímia. Para um buscador isso costuma bastar; para análise de sentimento é uma armadilha. A próxima página mede o mesmo efeito com "good" contra "not good".
Analogias, medidas com honestidade
A propriedade mais famosa dos vetores de palavras é que algumas relações viram direções: \(\text{king} - \text{man} + \text{woman}\) (rei − homem + mulher) cai perto de \(\text{queen}\) (rainha) (Mikolov et al., 2013a). most_similar(positive=[a, c], negative=[b]) calcula \(a - b + c\) com vetores unitários e devolve a palavra mais próxima. Eis doze analogias dos tipos usados para testar vetores de palavras (capitais, tempos verbais, comparativos, família, línguas), acertos e erros juntos:
tests = [('king', 'man', 'woman', 'queen'), ('paris', 'france', 'japan', 'tokyo'),
         ('berlin', 'germany', 'italy', 'rome'), ('walked', 'walk', 'swim', 'swam'),
         ('slower', 'slow', 'fast', 'faster'), ('better', 'good', 'bad', 'worse'),
         ('portuguese', 'brazil', 'mexico', 'spanish'), ('bigger', 'big', 'small', 'smaller'),
         ('brother', 'man', 'woman', 'sister'), ('day', 'sun', 'moon', 'night'),
         ('glove', 'hand', 'foot', 'sock'), ('greece', 'athens', 'brasilia', 'brazil')]
hits = 0
for a, b, c, expected in tests:
    got, score = glove.most_similar(positive=[a, c], negative=[b], topn=1)[0]
    hits += got == expected
    print(f"{a:10s} - {b:7s} + {c:8s} = {got:14s} {score:.2f}  "
          f"{'hit' if got == expected else 'miss (expected ' + expected + ')'}")
print(hits, 'hits out of', len(tests))
king       - man     + woman    = queen          0.85  hit
paris      - france  + japan    = tokyo          0.92  hit
berlin     - germany + italy    = rome           0.87  hit
walked     - walk    + swim     = swam           0.80  hit
slower     - slow    + fast     = faster         0.82  hit
better     - good    + bad      = worse          0.90  hit
portuguese - brazil  + mexico   = spanish        0.87  hit
bigger     - big     + small    = larger         0.92  miss (expected smaller)
brother    - man     + woman    = daughter       0.93  miss (expected sister)
day        - sun     + moon     = days           0.74  miss (expected night)
glove      - hand    + foot     = 50,000-square  0.68  miss (expected sock)
greece     - athens  + brasilia = amorim         0.71  miss (expected brazil)
7 hits out of 12
Sete acertos em doze. Capitais, tempos verbais, comparativos e línguas funcionam quase sempre. Os erros são instrutivos:
- bigger − big + small dá larger: o vetor achou "um comparativo" e "um tamanho", mas pegou o comparativo do adjetivo errado;
- brother − man + woman dá daughter (filha, em vez de irmã) e day − sun + moon dá days: a resposta está na vizinhança certa, mas não é a palavra que você queria;
- glove − hand + foot e greece − athens + brasilia produzem ruído ("50,000-square", "amorim"). Relações que aparecem pouco no texto de treino (Brasília é muito mais rara que Atenas nas notícias em inglês) não são direções retas.
Quanto desse acerto vem da geometria e quanto vem de uma regra escondida dentro do most_similar é o assunto da seção 8, na parte avançada.
Vendo o espaço
O simulador abaixo guarda os vetores GloVe reais, de 50 dimensões, de 143 palavras. Clique numa palavra para ver seus vizinhos mais próximos, calculados em 50 dimensões e desenhados como linhas num mapa 2-D; experimente a aritmética de vetores com os exemplos prontos (que incluem erros) e desmarque "excluir" para deixar que as palavras de entrada também sejam respostas (a parte avançada explica por que isso importa). O mapa pode ser desenhado com PCA ou com t-SNE, as duas projeções de redução de dimensionalidade. Os dois eixos do PCA guardam só 24,5% da variância desses vetores, então palavras que parecem próximas no mapa podem estar longe em 50-D e vice-versa; as linhas até os vizinhos verdadeiros mostram quando a projeção engana. O t-SNE preserva muito melhor as vizinhanças, ao custo de distâncias entre grupos que não significam nada.
Os vetores, os dois mapas e as respostas dos exemplos no vocabulário completo de 400 mil palavras foram produzidos por um script curto ao lado desta página (ele precisa do gensim; arredonda cada vetor para três casas, o que não muda nenhum cosseno em mais de 0,002).
5. O limite: um vetor por palavra
Todo método desta página dá a cada palavra um vetor, qualquer que seja o sentido em que ela é usada:
for w in ['bank', 'apple']:
    print(f"{w:6s}", ', '.join(n for n, _ in glove.most_similar(w, topn=10)))
print(f"bank / money {glove.similarity('bank', 'money'):.2f} · bank / river {glove.similarity('bank', 'river'):.2f}")
bank   banks, securities, banking, investment, exchange, financial, credit, lender, capital, brokerage
apple  blackberry, chips, iphone, microsoft, ipad, pc, ipod, intel, ibm, software
bank / money 0.64 · bank / river 0.41
Nas notícias, "bank" é quase sempre o banco, a instituição financeira, então seu único vetor é um vetor financeiro: os dez vizinhos falam de dinheiro e a margem do rio (river bank) desapareceu (bank/river 0,41 contra bank/money 0,64). "apple" é sobretudo uma empresa de tecnologia; a fruta não aparece entre os dez primeiros. O vetor de uma palavra é aproximadamente uma média dos seus sentidos, ponderada pela frequência (Arora et al., 2018), dominada pelo sentido mais frequente. O português tem o mesmo problema com banco (instituição, assento), manga (da camisa, a fruta) e vela (de cera, de barco).
Um segundo limite decorre do primeiro: uma frase é mais que suas palavras. "O cachorro mordeu o homem" e "o homem mordeu o cachorro" têm as mesmas palavras. Qualquer representação construída só com vetores de palavras, faça o que fizer com eles, não sabe quem mordeu quem, a menos que também olhe a ordem. Os dois limites são o ponto de partida dos sentence embeddings, em que o vetor de cada palavra é calculado a partir da frase em volta dela.
6. Resumo: vetores de palavras em cinco linhas
- Uma palavra é conhecida pelas suas companhias. Palavras usadas em contextos parecidos recebem vetores parecidos: a hipótese distribucional.
- Conte os vizinhos. Uma linha da matriz de coocorrência descreve uma palavra pelas palavras em volta dela; palavras parecidas raramente aparecem juntas, mas aparecem ao lado das mesmas palavras.
- Guarde o que surpreende e comprima. A PPMI guarda os pares vistos mais do que o acaso preveria, o que tira o artigo; a SVD truncada junta contextos que se comportam igual, o que reaproxima gato e cachorro.
- Ou preveja os vizinhos. O word2vec transforma cada par (central, vizinho) num exemplo de treino e, com a amostragem negativa, em perguntas de sim ou não; ele chega perto do mesmo lugar que a contagem.
- Leia o espaço com cuidado. Vizinhos medem relação (antônimos dão nota alta), analogias funcionam só parte das vezes e cada palavra tem um único vetor, qualquer que seja o sentido.
| o que você vê | o que está acontecendo | o que fazer |
|---|---|---|
| o contexto mais forte de todo substantivo é o artigo | contagens brutas premiam palavras frequentes | repesar com PPMI |
| gato e cachorro parecem sem relação depois da PPMI | os contextos deles são palavras diferentes, colunas ortogonais | comprimir com uma SVD truncada |
| "hot" fica tão perto de "cold" quanto "doctor" de "physician" | o cosseno mede relação, não sinonímia | não confiar só nele para sentimento ou negação |
| todos os vizinhos de "bank" são financeiros | um vetor por palavra, puxado pelo sentido frequente | usar embeddings contextuais (próxima página) |
Lab fundamental — vetores de palavras de três jeitos
O problema. Esta página construiu vetores de palavras num corpus de brinquedo de onze frases e explorou vetores que outra pessoa treinou em bilhões de palavras. Em que método confiar num texto real seu? O lab põe as três famílias no mesmo texto, para uma comparação justa. O corpus é o primeiro milhão de palavras do text8, um trecho limpo da Wikipédia em inglês muito usado para testar vetores de palavras (Mahoney, 2011): só letras minúsculas, números escritos por extenso. Esta parte constrói vetores por contagem (PPMI + SVD, como no exemplo de brinquedo) e por predição (word2vec), baixa vetores pré-treinados (GloVe) e compara seus vizinhos; o teste de analogias, o fastText em palavras nunca vistas e um mapa do espaço ficam para o lab avançado.
Como fazer este lab em aula (cerca de 35 min, em duplas)
- Baixe o notebook do lab e abra no Colab (File → Upload notebook) ou no Jupyter; no Colab, rode
!pip install gensimna primeira célula. Rode as células em ordem, numa mesma sessão. O lab inteiro calcula por cerca de um minuto e meio na CPU de um notebook, a maior parte no treino do word2vec e do fastText, e baixa 31 MB (text8) e 66 MB (GloVe). - Este lab corresponde aos passos 1 a 5 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 6.
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 e 2 em 8 min; passo 3 e a primeira simulação em 10 min; passo 4 e a segunda simulação em 10 min; passo 5 em 7 min.
Passo 1 — carregar um milhão de palavras da Wikipédia
Preveja. Que palavras você espera no topo da lista de frequências de um milhão de palavras da Wikipédia? Das palavras distintas, você acha que a maioria aparece pelo menos dez vezes ou só uma pequena parte?
# No Colab, rode uma vez:  !pip install gensim
import numpy as np
import pandas as pd
from collections import Counter
from itertools import islice
import gensim.downloader as api
from gensim.models.word2vec import Text8Corpus

path = api.load('text8', return_path=True)          # 17 milhões de palavras da Wikipédia, ~31 MB
chunks = list(islice(Text8Corpus(path), 100))       # os 100 primeiros blocos de 10.000 palavras
tokens = [w for chunk in chunks for w in chunk]
freq = Counter(tokens)
vocab = [w for w, c in freq.most_common() if c >= 10]
pos = {w: i for i, w in enumerate(vocab)}

print(f"{len(tokens):,} tokens · {len(freq):,} distinct words · {len(vocab):,} seen at least 10 times")
print('most frequent:', [w for w, _ in freq.most_common(8)])
print(' '.join(tokens[:22]))
1,000,000 tokens · 52,754 distinct words · 8,412 seen at least 10 times
most frequent: ['the', 'of', 'and', 'one', 'in', 'a', 'to', 'zero']
anarchism originated as a term of abuse first used against early working class radicals including the diggers of the english revolution and
Como ler. O trecho tem um milhão de tokens e 52.754 palavras distintas, mas só 8.412 aparecem pelo menos dez vezes; as outras têm poucos contextos para aprender um vetor e os três métodos as descartam (o mesmo min_count=10). As mais frequentes são as palavras funcionais esperadas, mais "one" e "zero", porque o text8 escreve os números por extenso. (api.load('text8', return_path=True) só baixa o arquivo; lê-lo com Text8Corpus evita um carregador do pacote gensim-data que falha com versões recentes de suas dependências.)
Passo 2 — contar coocorrências
Preveja. Dentro de quatro posições, "king" vai encontrar mais vezes "queen" ou "the"? Das 71 milhões de células da matriz, você espera que a maioria seja diferente de zero ou muito poucas?
import scipy.sparse as sp

ids = np.array([pos.get(w, -1) for w in tokens])     # -1 marca uma palavra rara, ignorada
rows, cols = [], []
for d in range(1, 5):                                # janela: 4 palavras de cada lado
    a, b = ids[:-d], ids[d:]
    ok = (a >= 0) & (b >= 0)
    rows += [a[ok], b[ok]]
    cols += [b[ok], a[ok]]                           # conta as duas direções
rows, cols = np.concatenate(rows), np.concatenate(cols)
C = sp.csr_matrix((np.ones(len(rows)), (rows, cols)), shape=(len(vocab), len(vocab)))  # repetições são somadas

print(C.shape, f"· {C.nnz:,} non-zero cells ({C.nnz / (C.shape[0] * C.shape[1]):.1%} of the matrix)")
for w, c in [('king', 'queen'), ('king', 'the'), ('king', 'car')]:
    print(f"count({w}, {c}) = {int(C[pos[w], pos[c]])}")
(8412, 8412) · 1,740,671 non-zero cells (2.5% of the matrix)
count(king, queen) = 7
count(king, the) = 321
count(king, car) = 0
Como ler. É o exemplo de brinquedo em escala, escrito sem laços em Python: para cada distância d de 1 a 4, os vetores ids[:-d] e ids[d:] alinham cada palavra com a que vem d posições depois; cada par alinhado é uma coocorrência. A matriz tem 8.412 × 8.412 células (cerca de 71 milhões) e só 2,5% são não nulas: a maioria dos pares de palavras nunca se encontra a menos de quatro posições, então ela é guardada esparsa, como as matrizes de bag-of-words. "king" encontra "the" muito mais vezes que "queen", justamente o desequilíbrio que a PPMI corrige.
Passo 3 — PPMI e SVD
Preveja. Das seis palavras de teste (king, car, france, computer, bank, four), qual você espera que tenha os piores vizinhos? Por quê?
from sklearn.decomposition import TruncatedSVD
from sklearn.preprocessing import normalize

N = C.sum()
n_word = np.asarray(C.sum(axis=1)).ravel()
n_ctx = np.asarray(C.sum(axis=0)).ravel()
Cc = C.tocoo()
pmi = np.log2(Cc.data * N / (n_word[Cc.row] * n_ctx[Cc.col]))   # só as células não nulas
keep = pmi > 0
PPMI = sp.csr_matrix((pmi[keep], (Cc.row[keep], Cc.col[keep])), shape=C.shape)
W_svd = normalize(TruncatedSVD(n_components=100, random_state=0).fit_transform(PPMI))

def neighbors(W, word, k=6):
    sims = W @ W[pos[word]]                          # linhas de comprimento 1: produto escalar = cosseno
    best = [j for j in np.argsort(-sims) if j != pos[word]][:k]
    return ', '.join(vocab[j] for j in best)

probe = ['king', 'car', 'france', 'computer', 'bank', 'four']
print(f"{PPMI.nnz:,} positive PPMI cells of {C.nnz:,} · word vectors {W_svd.shape}")
for w in probe:
    print(f"{w:9s}", neighbors(W_svd, w))
1,508,032 positive PPMI cells of 1,740,671 · word vectors (8412, 100)
king      ii, alexander, son, iv, queen, iii
car       racing, audi, cars, touring, auto, wheel
france    spain, portugal, netherlands, norway, kingdom, brazil
computer  computers, software, portable, hardware, digital, apple
bank      caribbean, eastern, country, western, settlement, nations
four      six, five, three, seven, two, eight
Como ler. A PMI é calculada só nas células não nulas (uma contagem zero daria \(-\infty\), que a PPMI corta para 0 de qualquer forma); 87% delas são positivas. A SVD comprime os 8.412 valores de PPMI de cada palavra em 100 números; normalize dá comprimento 1 a cada vetor, então um produto escalar é um cosseno. Os vizinhos são razoáveis para um método que levou segundos: números ao lado de números, países ao lado de países, "computer" ao lado de "software" e "hardware". "king" aparece cercado de numerais de reis (ii, iv, iii), porque na Wikipédia os reis vêm seguidos deles. "bank" é o ponto fraco: seus vizinhos são geográficos (caribbean, eastern, western), porque neste trecho "bank" é muitas vezes a Cisjordânia (West Bank) ou a margem de um rio; um único vetor tem de cobrir tudo isso.
Simulação: para que serve a PPMI. O passo 3 repesou as contagens com PPMI antes da SVD. Pule essa etapa: aplique o mesmo TruncatedSVD e o mesmo normalize direto à matriz de contagens brutas C e imprima os vizinhos das mesmas palavras de teste. Quais palavras sofrem mais? Que tipo de vizinho toma o lugar?
Solução
W_raw = normalize(TruncatedSVD(n_components=100, random_state=0).fit_transform(C))   # contagens brutas, sem PPMI
for w in probe:
    print(f"{w:9s}", neighbors(W_raw, w))
king      queen, bishop, birth, acts, kings, declaration
car       space, plane, newspaper, chess, game, race
france    russia, poland, spain, portugal, japan, india
computer  with, system, standard, for, building, by
bank      outside, continent, parliament, opening, committee, coast
four      five, three, six, seven, eight, nine
Sem PPMI, "computer" ganha with, system, standard, for, by: três dos cinco vizinhos são palavras funcionais, que ficam ao lado de todo substantivo, exatamente como o artigo o no corpus de brinquedo. "car" ganha space, plane, newspaper, chess, substantivos que só têm em comum as palavras frequentes em volta. Os países e os números sobrevivem, porque seus contextos são distintivos mesmo nas contagens brutas. É o exemplo de brinquedo em escala: sem repesar, as palavras mais frequentes decidem quem é parecido com quem.
Passo 4 — word2vec no mesmo texto
Preveja. Mesmo texto, mesma janela, mesmo tamanho de vetor: os vizinhos do word2vec vão ser melhores ou piores que os de PPMI + SVD? Para todas as palavras ou só para algumas?
from gensim.models import Word2Vec

w2v = Word2Vec(chunks, vector_size=100, window=4, min_count=10, sg=1, negative=5,
               epochs=5, workers=1, seed=0)          # sg=1: skip-gram · workers=1 + seed: reprodutível
W_w2v = normalize(np.array([w2v.wv[w] for w in vocab]))
print(len(w2v.wv), 'words ·', w2v.wv.vector_size, 'numbers each')
for w in probe:
    print(f"{w:9s}", neighbors(W_w2v, w))
8412 words · 100 numbers each
king      queen, philip, pope, khan, duke, son
car       racing, touring, driver, automobile, sports, radio
france    spain, portugal, norway, archbishop, brazil, canterbury
computer  macintosh, software, animation, video, computing, newton
bank      continental, luanda, jutland, reef, northwestern, bering
four      three, five, six, seven, eight, one
Como ler. O mesmo vocabulário (8.412 palavras, graças a min_count=10), a mesma janela, o mesmo tamanho de vetor: a comparação é justa. O word2vec acerta "king" onde a contagem não acertou (queen, depois philip, pope, khan, duke: outros governantes) e põe "automobile" entre os vizinhos de "car". Também faz escolhas estranhas: "archbishop" e "canterbury" ao lado de "france"; para "bank", uma lista de lugares (luanda, jutland, reef, bering). Com só um milhão de palavras, cada um desses vizinhos é decidido por algumas dezenas de contextos. workers=1 importa: com várias threads, a ordem das atualizações muda de uma execução para outra e os vetores mudam junto.
Simulação: skip-gram ou CBOW. O passo 4 treinou o skip-gram (sg=1). Treine de novo com o CBOW (sg=0), mantendo todo o resto, e compare os vizinhos das palavras de teste com os do skip-gram. Qual variante se sai melhor com um milhão de palavras?
Solução
cbow = Word2Vec(chunks, vector_size=100, window=4, min_count=10, sg=0, negative=5,
                epochs=5, workers=1, seed=0)          # sg=0: CBOW
W_cbow = normalize(np.array([cbow.wv[w] for w in vocab]))
for w in probe:
    print(f"{w:9s}", neighbors(W_cbow, w))
king      emperor, daughter, son, philip, alexander, ii
car       driver, tv, html, czech, snooker, gibson
france    spain, virginia, japan, british, house, austria
computer  fictional, shrugged, music, art, ethics, animation
bank      continental, algerian, saskatchewan, turkey, cathedral, sahara
four      three, five, six, seven, eight, september
Neste corpus pequeno o CBOW é claramente pior: "car" mantém driver e depois vira ruído (tv, html, czech, snooker), "computer" ganha fictional, shrugged, music e "france" recebe virginia e house. O CBOW tira a média dos vizinhos antes de prever, então uma palavra recebe um exemplo borrado por posição; o skip-gram faz um exemplo por par (central, vizinho), o que dá a cada palavra mais atualizações e mais nítidas. Por isso o skip-gram é a escolha usual quando o texto é escasso ou as palavras são raras; o CBOW, que treina mais rápido, quando há texto de sobra. Os números vão bem com os dois: seus contextos são muito regulares.
Passo 5 — GloVe pré-treinado
Preveja. O GloVe tem 50 números por palavra, metade do que os dois modelos acima têm. Seus vizinhos vão ser melhores ou piores? O que pesa mais, o algoritmo ou a quantidade de texto?
glove = api.load('glove-wiki-gigaword-50')          # treinado em 6 bilhões de tokens, ~66 MB
known = [w in glove.key_to_index for w in vocab]
W_glove = normalize(np.array([glove[w] if k else np.zeros(50) for w, k in zip(vocab, known)]))
print(f"{sum(known):,} of our {len(vocab):,} words are in GloVe")
for w in probe:
    print(f"{w:9s}", neighbors(W_glove, w))
8,383 of our 8,412 words are in GloVe
king      prince, queen, ii, emperor, son, uncle
car       cars, vehicle, driver, driving, bus, vehicles
france    french, belgium, paris, spain, netherlands, italy
computer  computers, software, technology, electronic, internet, computing
bank      banks, banking, investment, exchange, financial, credit
four      three, six, five, eight, seven, two
Como ler. Para uma comparação justa, os vetores GloVe são restritos às nossas 8.412 palavras (faltam 29, grafias estranhas, que recebem vetor zero). Os vizinhos agora são bons por igual: "car" → cars, vehicle, driver; "france" → french, belgium, paris; "bank" → banks, banking, investment. O GloVe tem metade dos números por palavra (50 contra 100) e ganha mesmo assim, porque viu 6.000 vezes mais texto. Com vetores de palavras, a quantidade de texto de treino pesa mais que a escolha do algoritmo.
Para fechar a parte fundamental. Em uma frase cada: (1) por que "carro" e "automóvel" ganham linhas parecidas, se nunca aparecem na mesma frase? (2) O que a PPMI tira e o que a SVD acrescenta? (3) Por que o GloVe pré-treinado, com metade dos números por palavra, venceu os dois modelos treinados neste lab?
Sua vez (fundamental)
Em casa:
- PMI à mão. No corpus de brinquedo, calcule à mão a linha de coocorrência de "caminhão" com janela 2 e depois \(\text{PMI}(\text{caminhão}, \text{diesel})\) usando \(N = 126\) e o total da coluna de diesel (conte-o). É maior ou menor que \(\text{PMI}(\text{gato}, \text{bebe}) = 1{,}81\)? Por quê?
- Uma janela menor. Com janela 1 em vez de 2, quais contextos de "gato" desaparecem? "gato" e "cachorro" ainda compartilhariam algum contexto? Preveja primeiro, depois mude
windowe rode de novo. - Tamanho da janela no word2vec. Treine de novo o word2vec (passo 4) com
window=2e comwindow=10e compare os vizinhos de "walked", "computer" e "france". Qual janela dá vizinhos do mesmo tipo gramatical e qual dá vizinhos do mesmo assunto? - Um dicionário de ideias afins a partir de contagens. Use
neighbors(W_svd, ...)para achar três palavras em que PPMI + SVD dá vizinhos melhores que o word2vec e três em que dá piores. Você vê um padrão ligado à frequência das palavras?
Abordagem avançada
A parte fundamental construiu vetores de palavras contando numa janela pequena e prevendo, e explorou vetores pré-treinados. Esta parte olha para os lados e por baixo: dois outros caminhos até vetores densos (um documento inteiro como contexto e os descendentes do word2vec cujos vetores pré-treinados estão em toda parte), um olhar mais de perto sobre o que faz as analogias parecerem tão boas e os estereótipos que os vetores absorvem do texto em que foram treinados. Os blocos de código continuam os das seções 1 a 5.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. outros caminhos, análise semântica latente, GloVe e fastText; 2. analogias ao microscópio, a regra escondida no most_similar e os deslocamentos medidos; 3. viés, uma direção de gênero e o que ela mostra. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Outros caminhosLSA, GloVe, fastText
- Analogias ao microscópioa regra de exclusão; deslocamentos medidos
- Viésuma direção de gênero e seus cuidados
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
7. Outros caminhos para os mesmos vetores
Etapa 1. O exemplo de brinquedo contou vizinhos numa janela de duas palavras e o word2vec os previu. O contexto pode ser muito maior que uma janela e o caminho da contagem tem uma versão moderna, em grande escala.
A mesma compressão em documentos: análise semântica latente
Os primeiros vetores de palavras densos de uso amplo nem precisavam de janela. A análise semântica latente (LSA, Deerwester et al., 1990) aplica a SVD truncada diretamente à matriz TF-IDF da página de TF-IDF. Lida coluna por coluna, essa matriz documentos × palavras descreve cada palavra pelos documentos em que ela aparece, que é a visão "colunas do bag-of-words" da seção 2; a SVD comprime essas colunas em vetores curtos e densos. Nos 11.314 posts de treino do 20 Newsgroups, o corpus das outras páginas de texto, com 100 componentes:
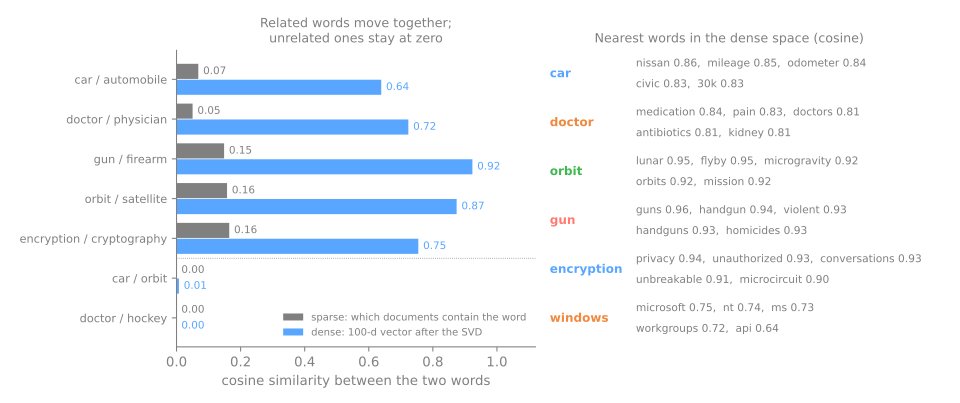
"car" e "automobile" vão de 0,07, como colunas TF-IDF, para 0,64 como vetores densos; "gun" e "firearm" de 0,15 para 0,92. Os pares de controle, de assuntos sem relação, ficam em 0,00 e 0,01: a SVD não tornou tudo parecido, só as palavras que compartilham contextos. Os vizinhos mostram também que tipo de similaridade um post inteiro como contexto produz. "car" fica ao lado de nissan, mileage, odometer: palavras do mesmo assunto, que aparecem nos mesmos posts. Uma janela de poucas palavras, como no exemplo de brinquedo e no word2vec, produz palavras do mesmo tipo: as mais próximas de "car" no GloVe, na seção 4, são truck, cars, vehicle.
GloVe e fastText
Dois descendentes merecem ser conhecidos pelo nome, porque seus vetores pré-treinados estão em toda parte.
O GloVe (Pennington, Socher & Manning, 2014), global vectors, volta ao caminho da contagem: monta a matriz completa de coocorrência palavra–contexto de um corpus enorme e ajusta vetores cujos produtos escalares aproximam o logaritmo das contagens, com um peso que impede os pares raros e os muito frequentes de dominarem. O grupo de Stanford publicou vetores treinados em 6 bilhões de tokens de Wikipédia e notícias, que a seção 4 usou.
O fastText (Bojanowski et al., 2017) muda o que recebe um vetor: não a palavra, mas seus n-gramas de caracteres. O vetor de uma palavra é a soma dos vetores de seus pedaços:
def char_ngrams(word, n_min=3, n_max=5):
    w = f"<{word}>"                                  # < e > marcam o início e o fim
    return [w[i:i + n] for n in range(n_min, n_max + 1) for i in range(len(w) - n + 1)]

print(char_ngrams('latiu'))
print('shared with "latido":', sorted(set(char_ngrams('latiu')) & set(char_ngrams('latido'))))
['<la', 'lat', 'ati', 'tiu', 'iu>', '<lat', 'lati', 'atiu', 'tiu>', '<lati', 'latiu', 'atiu>']
shared with "latido": ['<la', '<lat', '<lati', 'ati', 'lat', 'lati']
Duas consequências. Uma palavra nunca vista no treino ainda recebe um vetor, montado com pedaços que outras palavras compartilham: se "latiu" nunca foi vista mas "latido" foi, seis dos pedaços já estão treinados. E as formas flexionadas, que o português tem de sobra (latir, latiu, latia, latindo), compartilham a maior parte dos pedaços, então ficam próximas mesmo quando algumas formas são raras. O lab mede os dois efeitos e um efeito colateral: palavras escritas de forma parecida mas com significados diferentes também são puxadas umas para as outras. O fastText também publicou vetores pré-treinados para 157 línguas, português incluído (Grave et al., 2018).
8. Analogias ao microscópio
Etapa 2. A seção 4 avaliou doze analogias com o most_similar e achou sete acertos. Há um truque discreto no most_similar: ele nunca devolve as palavras de entrada. Sem essa regra:
def unit(w):
    return glove.get_vector(w, norm=True)

for a, b, c in [('king', 'man', 'woman'), ('doctor', 'man', 'woman')]:
    v = unit(a) - unit(b) + unit(c)
    print(f"{a} - {b} + {c}, nothing excluded:", ', '.join(f"{w} {s:.2f}" for w, s in glove.similar_by_vector(v, topn=3)))
print(f"cos(king - queen, man - woman) = {cos(unit('king') - unit('queen'), unit('man') - unit('woman')):.2f}")
print(f"cos(king - queen, car - banana) = {cos(unit('king') - unit('queen'), unit('car') - unit('banana')):.2f}")
king - man + woman, nothing excluded: king 0.89, queen 0.85, throne 0.77
doctor - man + woman, nothing excluded: doctor 0.90, nurse 0.84, child 0.77
cos(king - queen, man - woman) = 0.58
cos(king - queen, car - banana) = -0.05
A palavra mais próxima de king − man + woman é o próprio king (0,89); queen vem em segundo. Tirar "man" e somar "woman" move o vetor só um pouco; a analogia funciona porque a regra remove o ponto de partida. A mesma regra explica um resultado muito citado como prova de machismo nos embeddings, doctor − man + woman = nurse (médico − homem + mulher = enfermeira): a palavra mais próxima é doctor (0,90); "nurse" só aparece porque "doctor" está excluída (Nissim, van Noord & van der Goot, 2020). As duas últimas linhas medem diretamente as "setas paralelas": os deslocamentos king − queen e man − woman têm cosseno 0,58, claramente relacionados mas longe de idênticos, enquanto um deslocamento sem relação dá −0,05. Analogias são uma regularidade real, porém aproximada; o lab a mede em milhares de perguntas padronizadas.
9. Viés: o que os vetores aprenderam sobre pessoas
Etapa 3. Vetores aprendidos de texto humano absorvem as associações desse texto, estereótipos inclusive (Bolukbasi et al., 2016; Caliskan, Bryson & Narayanan, 2017). Dá para medir isso sem analogias. Tire a média das diferenças entre oito pares de palavras de gênero (he − she, man − woman, father − mother, ...) para obter uma direção de gênero e projete nela palavras de profissões: valores positivos pendem para "he" (ele), negativos para "she" (ela).
pairs_gender = [('he', 'she'), ('man', 'woman'), ('father', 'mother'), ('brother', 'sister'),
                ('king', 'queen'), ('boy', 'girl'), ('son', 'daughter'), ('his', 'her')]
g = np.mean([unit(a) - unit(b) for a, b in pairs_gender], axis=0)
g /= np.linalg.norm(g)                   # uma direção "he - she", média de 8 pares
jobs = ['receptionist', 'nurse', 'homemaker', 'hairdresser', 'librarian', 'teacher', 'doctor',
        'accountant', 'carpenter', 'lawyer', 'programmer', 'engineer', 'architect', 'manager', 'captain']
print(pd.Series({w: unit(w) @ g for w in jobs}).sort_values().round(2).to_string())
print('for reference:', {w: round(float(unit(w) @ g), 2) for w in ['she', 'woman', 'man', 'he']})
receptionist   -0.31
homemaker      -0.30
nurse          -0.30
hairdresser    -0.25
librarian      -0.08
teacher         0.00
doctor          0.03
accountant      0.06
carpenter       0.09
lawyer          0.18
programmer      0.19
engineer        0.24
architect       0.32
manager         0.37
captain         0.42
for reference: {'she': -0.19, 'woman': -0.29, 'man': 0.1, 'he': 0.24}
"receptionist" (recepcionista), "homemaker" (dona de casa) e "nurse" (enfermeira) (−0,30) pendem mais para "she" do que a própria palavra "she" (−0,19); "manager" (gerente, 0,37) e "captain" (capitão, 0,42) pendem mais para "he" do que "he" (0,24). Nenhuma dessas palavras tem gênero por definição em inglês. Os vetores não inventaram isso; comprimiram quem aparece escrito em qual papel na Wikipédia e nas notícias. Há dois cuidados ao ler uma tabela assim. Primeiro, a própria direção é estimada a partir de poucos pares e um par sozinho pode ser ruidoso ("man" dá só +0,10 aqui). Segundo, uma palavra pode se deslocar por motivos que nada têm a ver com gênero: nas notícias, "captain" é muitas vezes um título esportivo ou militar. O que importa na prática é que um sistema construído sobre esses vetores, digamos um que ordena currículos pela similaridade com a descrição de uma vaga, herda a inclinação. Medi-la é o primeiro passo. Bolukbasi et al. propuseram remover a direção por projeção, mas trabalhos posteriores mostraram que isso mais esconde o viés do que o remove: o problema continua em aberto.
Lab avançado — pondo os vetores à prova
O lab fundamental comparou as três famílias pelos seus vizinhos, um julgamento a olho. Esta parte as avalia num teste padrão de 3.732 perguntas de analogia, experimenta o fastText em palavras nunca vistas e desenha o espaço, medindo o quanto um mapa 2-D merece confiança.
Como fazer este lab em aula (cerca de 25 min, em duplas)
- Continue no mesmo notebook e na mesma sessão do lab fundamental: os passos abaixo usam
vocab,pos,chunks,W_svd,W_w2v,W_gloveeglove. - Como antes, responda a cada Preveja com a dupla antes de rodar e tente cada Simulação antes de abrir a solução.
- Ritmo sugerido: passo 6 e a primeira simulação em 10 min; passo 7 em 6 min; passo 8 e a segunda simulação em 9 min.
Passo 6 — o teste de analogias: 3.732 perguntas
Preveja. O GloVe é famoso pelas analogias. Em 3.732 perguntas padronizadas, você espera que ele acerte quase todas, cerca de metade ou só algumas? E os dois modelos treinados com um milhão de palavras?
from gensim.test.utils import datapath

questions, section = [], None
for line in open(datapath('questions-words.txt')):   # o teste de analogias de Mikolov et al.
    if line.startswith(':'):
        section = 'syntactic' if line.startswith(': gram') else 'semantic'
        continue
    q = line.lower().split()
    if all(w in pos and w in glove.key_to_index for w in q):
        questions.append((section, *q))
print(len(questions), 'questions use only words that all three models know:',
      dict(Counter(s for s, *_ in questions)))

def analogy_accuracy(W):
    hits = Counter()
    for section, a, b, c, d in questions:            # "a está para b assim como c está para d": b - a + c ≈ d
        sims = W @ (W[pos[b]] - W[pos[a]] + W[pos[c]])
        sims[[pos[a], pos[b], pos[c]]] = -np.inf     # a regra usual: as entradas não podem ser a resposta
        hits[section] += vocab[np.argmax(sims)] == d
    n = Counter(s for s, *_ in questions)
    return {s: hits[s] / n[s] for s in ['semantic', 'syntactic']} | {'all': sum(hits.values()) / len(questions)}

print(pd.DataFrame({'PPMI + SVD': analogy_accuracy(W_svd), 'word2vec': analogy_accuracy(W_w2v),
                    'GloVe (pretrained)': analogy_accuracy(W_glove)}).T.round(3))
3732 questions use only words that all three models know: {'semantic': 418, 'syntactic': 3314}
                    semantic  syntactic    all
PPMI + SVD             0.287      0.099  0.120
word2vec               0.153      0.050  0.062
GloVe (pretrained)     0.722      0.585  0.600
Como ler. questions-words.txt vem com o gensim: as perguntas de analogia de Mikolov et al. (2013a), como athens greece baghdad iraq (semânticas: capitais, moedas, família) e walk walking swim swimming (sintáticas: tempos verbais, plurais, comparativos). Ficamos com as 3.732 perguntas cujas quatro palavras estão no nosso vocabulário e no GloVe. Todo modelo busca entre os mesmos 8.412 candidatos, então as notas são comparáveis. Um chute ao acaso acertaria cerca de 0,01%.
- O GloVe acerta 60,0% (72,2% nas semânticas). É o número por trás dos exemplos famosos: impressionante, mas também errado quatro vezes em dez.
- PPMI + SVD acerta 12,0%, o word2vec 6,2%. Com um milhão de palavras, o método de contagem ganha do de predição, em linha com Levy, Goldberg & Dagan (2015), que acharam que, com os mesmos dados e configurações comparáveis, nenhuma das famílias é sistematicamente melhor. A vantagem do word2vec nos artigos originais veio com bilhões de palavras e ajuste cuidadoso.
- As perguntas semânticas são mais fáceis para os três aqui, porque muitas são capitais e países, que a Wikipédia menciona juntos o tempo todo.
Simulação: a regra de exclusão em escala. A seção 8 mostrou, em dois exemplos, que o most_similar nunca devolve as palavras de entrada, e o passo 6 aplicou a mesma regra. Meça quanto a regra vale nas 3.732 perguntas: avalie o GloVe com e sem excluir as entradas e conte o que a busca devolve quando nada é excluído.
Solução
def analogy_answers(W, exclude):
    found = Counter()
    for section, a, b, c, d in questions:
        sims = W @ (W[pos[b]] - W[pos[a]] + W[pos[c]])
        if exclude:
            sims[[pos[a], pos[b], pos[c]]] = -np.inf     # a regra de costume
        got = vocab[np.argmax(sims)]
        found['right answer' if got == d else 'the input c' if got == c else
              'the input b' if got == b else 'the input a' if got == a else 'another word'] += 1
    return found

print(pd.DataFrame({'inputs excluded': analogy_answers(W_glove, True),
                    'nothing excluded': analogy_answers(W_glove, False)}).fillna(0).astype(int))
              inputs excluded  nothing excluded
right answer             2241              1389
another word             1491               452
the input c                 0              1766
the input b                 0               125
Sem a regra, os acertos do GloVe caem de 2.241 para 1.389, de 60,0% para 37,2% das perguntas. A resposta mais comum passa a ser a própria entrada c, 1.766 vezes: em athens greece baghdad ?, o vetor \(\text{greece} - \text{athens} + \text{baghdad}\) continua mais perto de baghdad, porque o deslocamento o move só um pouco. É o efeito king/queen da seção 8, medido no teste inteiro. A regra não é trapaça (a pergunta pede uma quarta palavra), mas significa que boa parte da acurácia famosa vem de proibir a resposta errada óbvia; ao ler uma nota de analogias, confira se as entradas foram excluídas.
Passo 7 — uma palavra nunca vista: fastText
Preveja. "compuetr" é um erro de digitação que nunca aparece no texto. O word2vec consegue dar um vetor a ela? E o fastText? E, para uma palavra que o fastText viu, como "cattle", os vizinhos vão ser de sentido ou de grafia?
from gensim.models import FastText

ft = FastText(chunks, vector_size=100, window=4, min_count=10, sg=1, epochs=5,
              bucket=200_000, workers=1, seed=0)
for w in ['computers', 'compuetr', 'microcomputers', 'unhappyness', 'cattle']:
    status = 'in vocabulary' if w in ft.wv.key_to_index else 'never seen   '
    print(f"{w:15s} {status}  ", ', '.join(n for n, _ in ft.wv.most_similar(w, topn=4)))
print('does word2vec know "compuetr"?', 'compuetr' in w2v.wv.key_to_index)
computers       in vocabulary   computer, programmers, programs, computing
compuetr        never seen      computer, computing, compact, computers
microcomputers  never seen      computers, programmers, computer, machines
unhappyness     never seen      sickness, illness, happiness, predecessor
cattle          in vocabulary   bottle, wattle, battle, battles
does word2vec know "compuetr"? False
Como ler. O fastText treina no mesmo texto, mas aprende vetores para n-gramas de caracteres (bucket é o tamanho da tabela que os guarda). O erro de digitação "compuetr" e a rara "microcomputers" nunca foram vistas, mas seus vetores, montados com pedaços, caem ao lado de "computer" e "computers"; o word2vec simplesmente não tem vetor para elas. As duas últimas linhas mostram o preço. "unhappyness" ganha "happiness", mas também "sickness" e "illness", que compartilham o sufixo -ness. E "cattle" (gado), uma palavra que ele viu, ganha bottle, wattle, battle: vizinhos de grafia, não de significado. Num corpus pequeno, os n-gramas falam mais alto que os contextos.
Passo 8 — desenhar o espaço
Preveja. 32 vetores de 50 números são desenhados em dois eixos. Os dois eixos do PCA vão guardar a maior parte da variância ou uma pequena parte? Qual mapa, PCA ou t-SNE, vai separar os grupos com mais clareza?
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE

words = ['king', 'queen', 'man', 'woman', 'prince', 'princess', 'paris', 'france', 'rome', 'italy',
         'tokyo', 'japan', 'berlin', 'germany', 'car', 'truck', 'bus', 'train', 'dog', 'cat', 'horse',
         'cow', 'apple', 'banana', 'mango', 'orange', 'walk', 'walked', 'swim', 'swam', 'run', 'ran']
X = np.array([glove.get_vector(w, norm=True) for w in words])
pca = PCA(n_components=2).fit(X)
maps = {'PCA': pca.transform(X),
        't-SNE': TSNE(n_components=2, perplexity=8, metric='cosine', init='pca',
                      random_state=0).fit_transform(X)}
print(f"PCA: the 2 axes keep {pca.explained_variance_ratio_.sum():.0%} of the variance of these {len(words)} vectors")

fig, axes = plt.subplots(1, 2, figsize=(12, 5))
for ax, (name, P) in zip(axes, maps.items()):
    ax.scatter(P[:, 0], P[:, 1], s=12)
    for w, (x, y) in zip(words, P):
        ax.annotate(w, (x, y), fontsize=8)
    ax.set_title(f'GloVe vectors, {name}')
plt.show()
Como ler. Os dois eixos do PCA guardam 36% da variância desses 32 vetores, então o mapa do PCA é uma sombra grosseira: os grupos (realeza, capitais e países, veículos, animais, frutas, verbos) aparecem, mas se sobrepõem. O mapa do t-SNE os separa com clareza, porque só tenta manter cada palavra ao lado de seus vizinhos mais próximos. Procure os pares: nos dois mapas, cada capital fica perto do seu país e os deslocamentos país → capital apontam em direções parecidas: é a regularidade das analogias vista em 2-D. Lembre a lição de redução de dimensionalidade: distâncias entre grupos no t-SNE não significam nada, então "as frutas estão longe dos verbos" não é uma descoberta.
Simulação: o mapa guarda os vizinhos? Para cada uma das 32 palavras, ache a palavra mais próxima em 50 dimensões (pelo cosseno) e a mais próxima em cada mapa 2-D (pela distância euclidiana). Quantas palavras mantêm o vizinho mais próximo no mapa do PCA? E no do t-SNE? Quais se perdem?
Solução
from sklearn.metrics.pairwise import cosine_similarity, euclidean_distances

true_nn = np.argsort(-cosine_similarity(X), axis=1)[:, 1]        # a coluna 0 é a própria palavra
for name, P in maps.items():
    map_nn = np.argsort(euclidean_distances(P), axis=1)[:, 1]
    lost = [f"{words[i]} ({words[j]})" for i, j in enumerate(true_nn) if map_nn[i] != j]
    print(f"{name}: {len(words) - len(lost)} of {len(words)} words keep their 50-D nearest neighbor")
    print('   lost, with the true neighbor:', ', '.join(lost))
PCA: 11 of 32 words keep their 50-D nearest neighbor
   lost, with the true neighbor: king (prince), queen (princess), prince (king), princess (queen), paris (france), france (paris), rome (italy), japan (tokyo), berlin (germany), germany (berlin), car (truck), truck (car), bus (train), cow (dog), apple (mango), banana (mango), orange (banana), swim (swam), swam (swim), run (ran), ran (run)
t-SNE: 25 of 32 words keep their 50-D nearest neighbor
   lost, with the true neighbor: king (prince), queen (princess), prince (king), princess (queen), rome (italy), cow (dog), orange (banana)
O mapa do PCA mantém o vizinho mais próximo de só 11 das 32 palavras: perde até paris → france, car → truck e swim → swam, pares que ficam colados em 50 dimensões. O t-SNE mantém 25, porque manter cada ponto ao lado dos vizinhos é exatamente o que ele otimiza; o que ele perde fica quase todo dentro do grupo da realeza, em que quatro palavras estão quase igualmente próximas. É a versão medida do conselho de redução de dimensionalidade: leia vizinhanças num mapa t-SNE, não leia nada nas distâncias entre os grupos e confira qualquer surpresa no espaço original, como fazem as linhas do simulador da seção 4.
Para fechar a aula. Em uma frase cada: (1) por que um documento inteiro como contexto dá vizinhos do mesmo assunto e uma janela pequena dá vizinhos do mesmo tipo? (2) O que a regra de exclusão esconde e quanto ela vale no teste de analogias? (3) Como uma palavra, como "receptionist", pode pender mais para "she" do que a própria palavra "she"?
Sua vez (avançado)
Em casa, com mais tempo:
- Analogias que falham do mesmo jeito. No código das analogias da seção 4, o teste bigger − big + small devolveu "larger". Escreva outras duas analogias que você espera que falhem pelo mesmo motivo (o tipo certo de palavra, a palavra errada), rode-as e explique o resultado.
- Um par não é uma direção. A tabela de gênero da seção 9 projeta palavras numa direção construída a partir de 8 pares. Reconstrua-a só com o par ('he', 'she') e compare a posição de "man" e de "doctor". O que isso diz sobre conclusões tiradas de um único par?
- Mais texto. Troque os 100 blocos do passo 1 por 300 (três milhões de palavras) e rode de novo os passos 1 a 6. Quanto mudam as notas de analogia de PPMI + SVD e do word2vec? A distância para o GloVe diminui?
- Viés na sua própria lista. Usando a direção de gênero da seção 9, projete quinze palavras à sua escolha (esportes, adjetivos como "brilliant" e "beautiful", nomes próprios) com os vetores GloVe. Quais resultados surpreendem? Construa uma segunda direção a partir de ('rich', 'poor') e repita.
Referências
- Harris, Z. S. "Distributional Structure." Word 10, no. 2–3 (1954): 146–162 — a hipótese distribucional. DOI
- Firth, J. R. "A Synopsis of Linguistic Theory, 1930–1955." In Studies in Linguistic Analysis, 1–32. Oxford: Blackwell (1957) — "You shall know a word by the company it keeps."
- Church, K. W.; Hanks, P. "Word Association Norms, Mutual Information, and Lexicography." Computational Linguistics 16, no. 1 (1990): 22–29 — informação mútua pontual para pares de palavras. ACL Anthology
- Deerwester, S.; Dumais, S. T.; Furnas, G. W.; Landauer, T. K.; Harshman, R. "Indexing by Latent Semantic Analysis." Journal of the American Society for Information Science 41, no. 6 (1990): 391–407 — a SVD da matriz termo–documento. DOI
- Mikolov, T.; Chen, K.; Corrado, G.; Dean, J. "Efficient Estimation of Word Representations in Vector Space." ICLR Workshop (2013) — word2vec (skip-gram e CBOW) e o conjunto de teste de analogias. arXiv:1301.3781
- Mikolov, T.; Sutskever, I.; Chen, K.; Corrado, G.; Dean, J. "Distributed Representations of Words and Phrases and their Compositionality." NeurIPS 26 (2013): 3111–3119 — amostragem negativa. arXiv:1310.4546
- Levy, O.; Goldberg, Y. "Neural Word Embedding as Implicit Matrix Factorization." NeurIPS 27 (2014): 2177–2185 — o skip-gram com amostragem negativa fatora uma matriz de PMI deslocada. Proceedings
- Levy, O.; Goldberg, Y.; Dagan, I. "Improving Distributional Similarity with Lessons Learned from Word Embeddings." TACL 3 (2015): 211–225 — vetores por contagem e por predição comparados em pé de igualdade. DOI
- Pennington, J.; Socher, R.; Manning, C. D. "GloVe: Global Vectors for Word Representation." EMNLP (2014): 1532–1543. DOI
- Bojanowski, P.; Grave, E.; Joulin, A.; Mikolov, T. "Enriching Word Vectors with Subword Information." TACL 5 (2017): 135–146 — fastText. DOI
- Grave, E.; Bojanowski, P.; Gupta, P.; Joulin, A.; Mikolov, T. "Learning Word Vectors for 157 Languages." LREC (2018) — vetores fastText pré-treinados, português incluído. arXiv:1802.06893
- Bolukbasi, T.; Chang, K.-W.; Zou, J.; Saligrama, V.; Kalai, A. "Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings." NeurIPS 29 (2016): 4349–4357. arXiv:1607.06520
- Caliskan, A.; Bryson, J. J.; Narayanan, A. "Semantics Derived Automatically from Language Corpora Contain Human-like Biases." Science 356, no. 6334 (2017): 183–186. DOI
- Nissim, M.; van Noord, R.; van der Goot, R. "Fair Is Better than Sensational: Man Is to Doctor as Woman Is to Doctor." Computational Linguistics 46, no. 2 (2020): 487–497 — como a regra de exclusão molda os resultados das analogias. DOI
- Arora, S.; Li, Y.; Liang, Y.; Ma, T.; Risteski, A. "Linear Algebraic Structure of Word Senses, with Applications to Polysemy." TACL 6 (2018): 483–495 — o vetor de uma palavra como mistura ponderada de seus sentidos. DOI
- Mahoney, M. "About the Test Data." Large Text Compression Benchmark (2011) — o text8, os primeiros 10⁸ bytes do dump da Wikipédia em inglês de março de 2006, limpos. mattmahoney.net/dc/textdata.html
- Jurafsky, D.; Martin, J. H. Speech and Language Processing, 3ª ed. (rascunho), capítulo 6 "Vector Semantics and Embeddings" — PPMI, word2vec e viés, em ritmo de livro-texto. Texto completo
Quiz
O quiz cobre a abordagem fundamental.