O caminho desta parte
- Outros caminhosLSA, GloVe, fastText
- Analogias ao microscópioa regra de exclusão; deslocamentos medidos
- Viésuma direção de gênero e seus cuidados
A mesma compressão em documentos: LSA
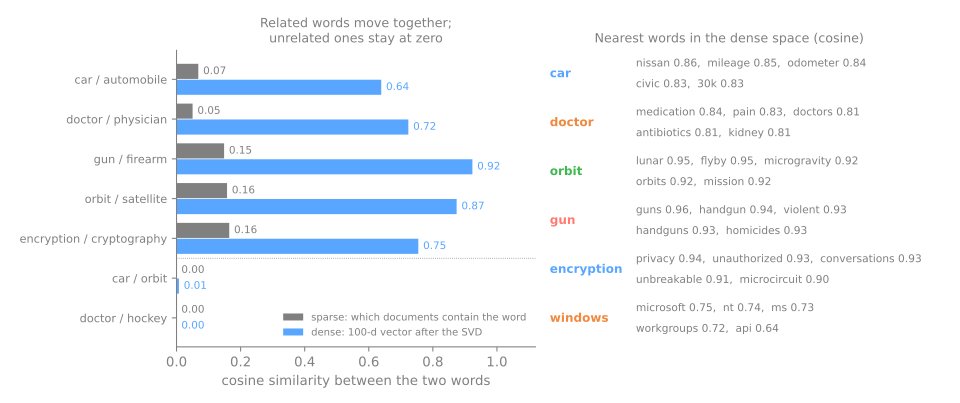
Análise semântica latente (LSA, Deerwester et al., 1990): SVD (decomposição em valores singulares) truncada da matriz TF-IDF (frequência do termo × frequência inversa nos documentos), 11.314 posts, 100 componentes.
car/automobile 0,07 → 0,64; gun/firearm 0,15 → 0,92; pares sem relação ficam em 0,00–0,01.
GloVe e fastText
GloVe (global vectors, Pennington et al., 2014)
De volta à contagem: ajusta vetores cujos produtos escalares aproximam o log das contagens de coocorrência de um corpus enorme.
fastText (Bojanowski et al., 2017)
Uma palavra é a soma dos seus n-gramas de caracteres:
latiu → <la, lat, ati, tiu, iu>, <lat, lati, …
6 pedaços em comum com latido
O truque silencioso: as palavras de entrada ficam de fora
Preveja. O most_similar nunca devolve uma palavra de entrada. Sem essa regra, o que fica mais perto de king − man + woman?
| sem excluir nada | as três mais próximas |
|---|---|
| king − man + woman | king 0,89, queen 0,85, throne 0,77 |
| doctor − man + woman | doctor 0,90, nurse 0,84, child 0,77 |
- "doctor − man + woman = nurse" só aparece porque "doctor" está proibida (Nissim et al., 2020).
- cos(king − queen, man − woman) = 0,58; um deslocamento sem relação: −0,05.
Viés: o que os vetores aprenderam sobre pessoas
A média de 8 diferenças (he − she, man − woman, …) dá uma direção de gênero; projete as profissões nela.
| receptionist | −0,31 |
| nurse | −0,30 |
| teacher | 0,00 |
| engineer | 0,24 |
| manager | 0,37 |
| captain | 0,42 |
Para referência: she −0,19, he 0,24. Receptionist pende mais para "she" que o próprio "she"; captain mais para "he" que "he".
Lendo uma tabela de viés com cuidado
a direção é estimada
A partir de 8 pares de palavras. Um par sozinho pode ser ruidoso: "man" projeta em só +0,10.
uma palavra se move por outros motivos
Nas notícias, "captain" é muitas vezes um título esportivo ou militar, não só um papel com gênero.
- Um sistema que ordena currículos pela similaridade com a descrição de uma vaga herda a inclinação.
- Remover a direção por projeção (Bolukbasi et al., 2016) mais esconde o viés do que o remove.
Resumo
- Um documento inteiro como contexto (LSA) dá vizinhos do mesmo assunto; uma janela pequena dá vizinhos do mesmo tipo.
- O GloVe ajusta o log das contagens globais de coocorrência; o fastText monta uma palavra com seus pedaços de caracteres, então palavras nunca vistas ganham vetor e vizinhos de grafia aparecem.
- O
most_similarexclui as palavras de entrada: boa parte da famosa acurácia das analogias vem de proibir a resposta errada óbvia. - Uma direção de gênero expõe estereótipos que os vetores comprimiram do texto; leia-a com seus cuidados.
Pondo os vetores à prova, passos 6 a 8
- Mesmo notebook, mesma sessão: os passos usam
vocab,pos,chunks,W_svd,W_w2v,W_gloveeglove. - O teste de analogias (3.732 perguntas), o fastText em palavras nunca vistas e um mapa do espaço com PCA (análise de componentes principais) e t-SNE (t-distributed stochastic neighbor embedding).
- Simulações: a regra de exclusão em escala (passo 6) e o mapa guarda os vizinhos? (passo 8).
Ritmo: passo 6 e a primeira simulação em 10 min; passo 7 em 6 min; passo 8 e a segunda em 9 min.