O problema: cada palavra é uma coluna própria
- No bag-of-words e no TF-IDF (frequência do termo × frequência inversa nos documentos) as colunas são ortogonais.
- "carro" e "automóvel" são tão pouco relacionados quanto "carro" e "banana".
- A representação sabe quais palavras um documento contém, nada sobre o que elas significam.
O caminho desta parte
- Contexto → sentidoa hipótese distribucional
- Contar e comprimircontagens de coocorrência → PPMI → SVD truncada
- Aprender prevendoskip-gram, CBOW, amostragem negativa
- Explorar o espaçovizinhos, relação, analogias, um vetor por palavra
Uma palavra que você nunca viu
- Um copo de tiquira gelada.
- A tiquira é feita de mandioca fermentada.
- Bebeu tiquira demais e passou mal.
- No Maranhão, servem tiquira nas festas.
A hipótese distribucional
Você deduziu pelas companhias da palavra: copo, gelada, fermentada, bebeu, demais, festas.
Harris, 1954
palavras que aparecem em contextos parecidos tendem a ter significados parecidos
Firth, 1957
"you shall know a word by the company it keeps"
Das contagens à PPMI, passo a passo
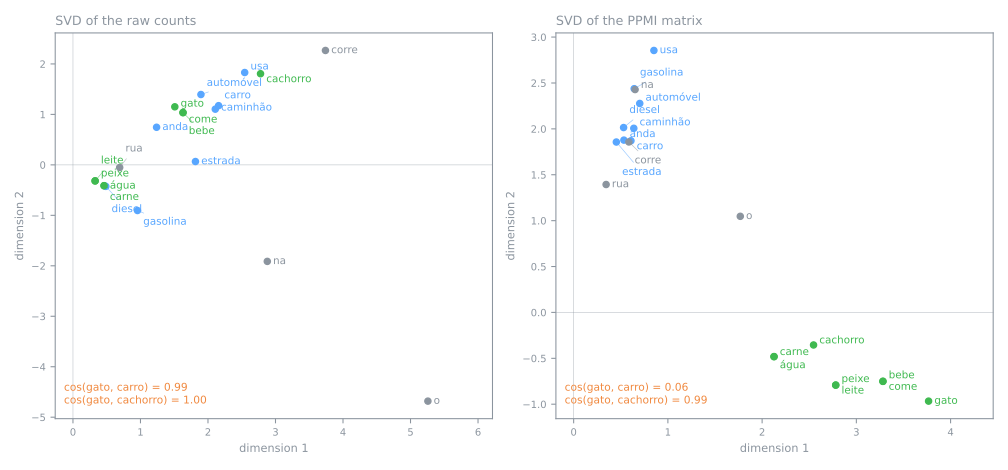
Onze frases, janela de duas palavras; PMI = informação mútua pontual. Preveja. Nas contagens brutas, qual contexto de "gato" é o mais forte? Depois da PMI, qual é o mais fraco?
SVD truncada: 20 colunas esparsas → 2 números densos
| palavra | dim 1 | dim 2 |
|---|---|---|
| gato | 3,77 | −0,97 |
| cachorro | 2,55 | −0,35 |
| leite | 2,78 | −0,79 |
| carro | 0,61 | 1,87 |
| automóvel | 0,70 | 2,28 |
| gasolina | 0,64 | 2,44 |
A SVD (decomposição em valores singulares; a PCA, análise de componentes principais, sem centrar) guarda as \(k\) direções que mais explicam a matriz.
Animais e comida: primeira coordenada grande. Veículos e combustível: a segunda.
A seção inteira em quatro colunas
| par | colunas do bag-of-words | contagens | PPMI | PPMI + SVD |
|---|---|---|---|---|
| gato / cachorro | 0,00 | 0,73 | 0,22 | 0,99 |
| carro / automóvel | 0,00 | 0,87 | 0,75 | 1,00 |
| gato / carro | 0,00 | 0,50 | 0,05 | 0,06 |
word2vec: aprendendo por predição
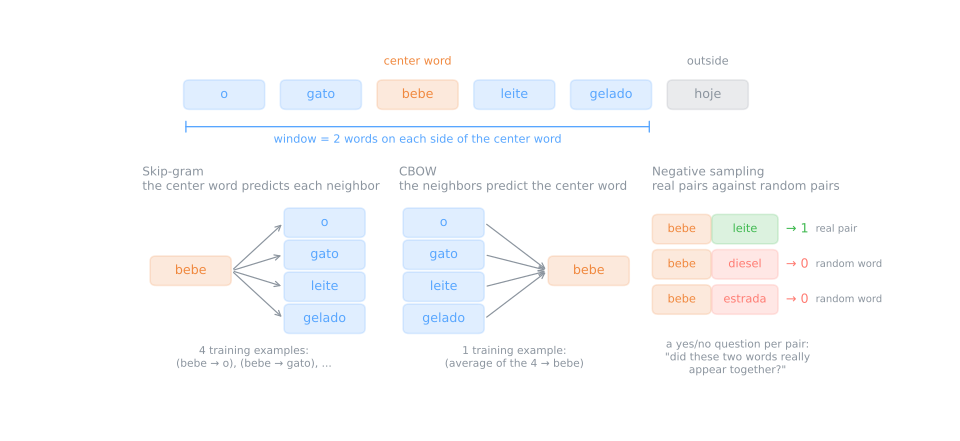
Mikolov et al., 2013. Deslize uma janela e gere exemplos de treino:
- skip-gram: o centro prevê cada vizinho → 18 exemplos de 6 palavras;
- CBOW (continuous bag-of-words): a média dos vizinhos prevê o centro → 6 exemplos.
Como os vetores se aproximam
- Toda palavra começa com um vetor aleatório. Um par (centro, contexto) é pontuado pelo produto escalar.
- O treino empurra os vetores para que os pares que de fato ocorrem tenham nota alta.
- Palavras nos mesmos contextos recebem os mesmos empurrões: a hipótese distribucional virada otimização.
amostragem negativa
Em vez de pontuar as 100.000 palavras: "essas duas apareceram mesmo juntas?" Real (bebe, leite) → 1; aleatório (bebe, diesel) → 0, com 5 a 20 palavras aleatórias por par real.
Treinando: os botões do gensim
| parâmetro | o que faz |
|---|---|
vector_size | números por palavra (de 100 a 300 é o típico) |
window | pequena (2–5): mesma função; grande (10+): mesmo assunto |
sg | 1 = skip-gram (mais lento, melhor para palavras raras); 0 = CBOW |
negative | palavras aleatórias por par real |
min_count | palavras mais raras que isso saem |
epochs, seed | passadas; seed e workers=1 para reprodutibilidade |
Vetores pré-treinados: GloVe, 400.000 palavras × 50 números
| palavra | mais próximas pelo cosseno |
|---|---|
| car | truck 0,92, cars 0,89, vehicle 0,88, driver 0,85, driving 0,84 |
| mango | pineapple 0,91, guava 0,90, papaya 0,89, pear 0,85, coconut 0,85 |
| brazil | portugal 0,88, argentina 0,87, rica 0,84, spain 0,83, costa 0,83 |
| python | reticulated 0,69, spamalot 0,66, php 0,64, owl 0,63, mouse 0,63 |
GloVe (global vectors): treinado em Stanford com 6 bilhões de tokens. Nenhum número sozinho significa algo ("car" começa com 0,48, −0,08, 1,46…); só a geometria significa. "python" mistura a cobra, o Monty Python e a programação.
Parecido não é sinônimo
| car / automobile | 0,70 |
| doctor / physician | 0,80 |
| hot / cold | 0,80 |
| good / bad | 0,80 |
| car / banana | 0,22 |
Um antônimo é a palavra mais intercambiável que existe: "a sopa está quente" / "a sopa está fria".
Analogias, medidas com honestidade
\(\text{king} - \text{man} + \text{woman} \approx\ ?\)
acertos
queen · tokyo · rome · swam · faster · worse · spanish
erros
- bigger − big + small = larger
- brother − man + woman = daughter
- glove − hand + foot = "50,000-square"
Capitais, tempos verbais, comparativos e línguas quase sempre funcionam; relações raras não são direções retas.
Simulador: vendo o espaço
Preveja. Clique numa palavra e compare os vizinhos em 50-D (as linhas) com o mapa: o mapa da PCA (24,5% da variância) engana? Depois experimente uma analogia pronta.
O limite: um vetor por palavra
bank
banks, securities, banking, investment, exchange, financial…
bank/money 0,64 · bank/river 0,41
apple
blackberry, chips, iphone, microsoft, ipad…
a fruta não aparece entre as dez
- Um vetor é aproximadamente uma média dos sentidos pesada pela frequência (Arora et al., 2018). Em português: banco, manga, vela.
- "O cachorro mordeu o homem" / "o homem mordeu o cachorro": as mesmas palavras, então só vetores de palavras não dizem quem mordeu quem.
Resumo
- Hipótese distribucional: contextos parecidos → vetores parecidos.
- À mão: contagens de coocorrência → PPMI (guarda o que supera o acaso) → SVD (junta contextos que se comportam igual).
- O word2vec prevê os vizinhos; com a amostragem negativa, perguntas de sim ou não. Chega perto do mesmo lugar que a contagem.
- Vetores pré-treinados: vizinhos medem relação (antônimos também); analogias funcionam parte das vezes.
- Um vetor por palavra, qualquer que seja o sentido.
Vetores de palavras de três jeitos, passos 1 a 5
- O primeiro milhão de palavras do text8 (Wikipédia em inglês, limpa).
- Contagem (PPMI + SVD), predição (word2vec) e pré-treinados (GloVe), comparados pelos vizinhos das mesmas palavras.
- Baixe o notebook do lab e abra no Colab ou no Jupyter; no Colab, rode
!pip install gensimantes. - Em cada passo, responda ao Preveja antes de rodar.
- Simulações: para que serve a PPMI (passo 3) e skip-gram ou CBOW (passo 4).
Ritmo: passos 1 e 2 em 8 min; passo 3 e a primeira simulação em 10 min; passo 4 e a segunda em 10 min; passo 5 em 7 min.