O problema: cada palavra é uma coluna própria
- No bag-of-words e no TF-IDF (frequência do termo × frequência inversa nos documentos) as colunas são ortogonais.
- "carro" e "automóvel" são tão pouco relacionados quanto "carro" e "banana".
- A representação sabe quais palavras um documento contém, nada sobre o que elas significam.
O caminho desta aula
- Contexto → sentidoa hipótese distribucional
- Contar e comprimircontagens de coocorrência → PPMI → SVD truncada
- Aprender prevendoword2vec, GloVe, fastText
- Explorar o espaçovizinhos, analogias, viés, um vetor por palavra
Uma palavra que você nunca viu
- Um copo de tiquira gelada.
- A tiquira é feita de mandioca fermentada.
- Bebeu tiquira demais e passou mal.
- No Maranhão, servem tiquira nas festas.
A hipótese distribucional
Você deduziu pelas companhias da palavra: copo, gelada, fermentada, bebeu, demais, festas.
Harris, 1954
palavras que aparecem em contextos parecidos tendem a ter significados parecidos
Firth, 1957
"you shall know a word by the company it keeps"
Um corpus de brinquedo: 11 frases
animais
o gato bebe leite · o gato come peixe · o cachorro bebe água · o cachorro come carne · o cachorro corre na rua
veículos
o carro usa gasolina · o carro corre na estrada · o automóvel usa gasolina · o automóvel anda na estrada · o caminhão usa diesel · o caminhão corre na estrada
Feito para que gato/cachorro e carro/automóvel nunca dividam uma frase, mas dividam os vizinhos.
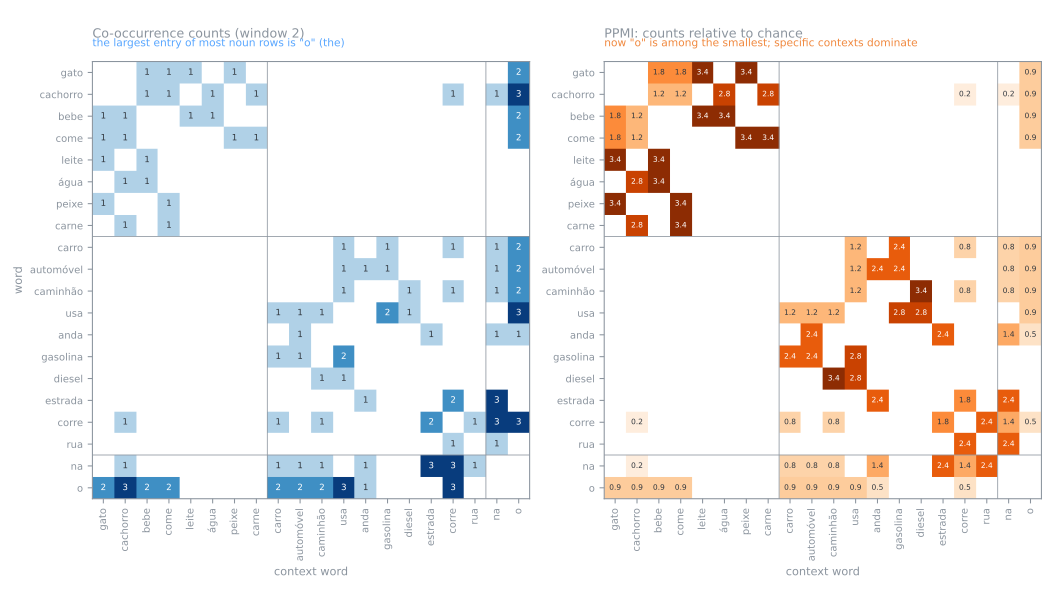
Para cada palavra, conte cada outra palavra numa janela de duas palavras à esquerda ou à direita: uma matriz 20 × 20, 126 pares (palavra, contexto).
Uma linha à mão: "gato"
- "o gato bebe leite": a janela tem o, bebe, leite.
- "o gato come peixe": a janela tem o, come, peixe.
| palavra | sua linha: o perfil de contextos |
|---|---|
| gato | bebe 1 · come 1 · leite 1 · o 2 · peixe 1 |
| cachorro | bebe 1 · carne 1 · come 1 · corre 1 · na 1 · o 3 · água 1 |
| carro | corre 1 · gasolina 1 · na 1 · o 2 · usa 1 |
| automóvel | anda 1 · gasolina 1 · na 1 · o 2 · usa 1 |
Documentos versus contextos
| par | colunas do bag-of-words | linhas de coocorrência |
|---|---|---|
| gato / cachorro | 0,00 | 0,73 |
| carro / automóvel | 0,00 | 0,87 |
| gato / carro | 0,00 | 0,50 |
PMI: contando o que surpreende
Não "com que frequência juntas?", mas "quanto mais que o acaso?": a informação mútua pontual (PMI, Church & Hanks, 1990).
\[ \text{PMI}(w, c) = \log_2 \frac{P(w, c)}{P(w)\,P(c)} = \log_2 \frac{n(w, c) \cdot N}{n(w) \cdot n(c)} \]PMI(gato, bebe)
\(\log_2 \frac{1 \times 126}{6 \times 6}\)
PMI(gato, o)
\(\log_2 \frac{2 \times 126}{6 \times 22}\)
o está ao lado de tudo (22 vezes como contexto): quase nada surpreende. A ordem das contagens brutas se inverte. Corte os negativos em zero: a PPMI (PMI positiva) \(= \max(\text{PMI}, 0)\).
A PPMI resolve o artigo e fica literal demais
| par | contagens | PPMI |
|---|---|---|
| gato / cachorro | 0,73 | 0,22 |
| carro / automóvel | 0,87 | 0,75 |
| gato / carro | 0,50 | 0,05 |
Gato e cachorro só dividem bebe e come: leite, água, peixe e carne são quatro colunas ortogonais.
SVD truncada: 20 colunas esparsas → 2 números densos
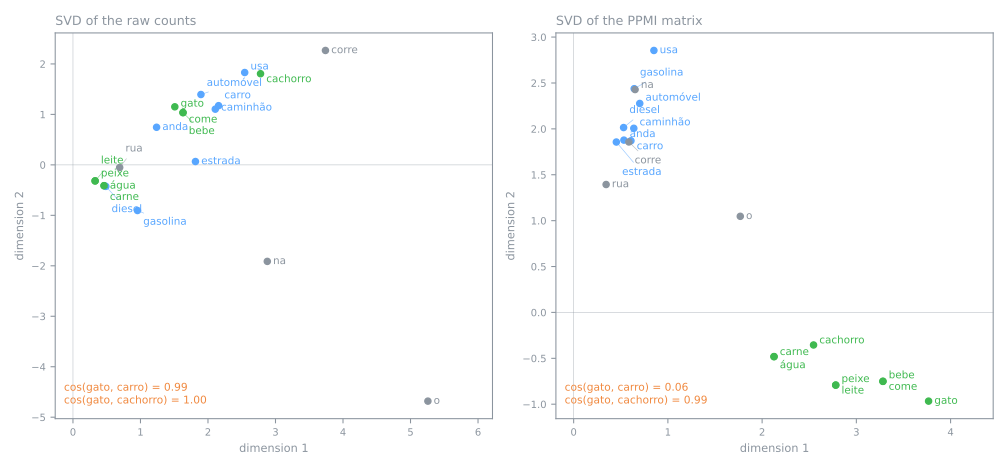
| palavra | dim 1 | dim 2 |
|---|---|---|
| gato | 3,77 | −0,97 |
| cachorro | 2,55 | −0,35 |
| leite | 2,78 | −0,79 |
| carro | 0,61 | 1,87 |
| automóvel | 0,70 | 2,28 |
| gasolina | 0,64 | 2,44 |
A SVD (decomposição em valores singulares; a PCA, análise de componentes principais, sem centrar) guarda as \(k\) direções que mais explicam a matriz.
Animais e comida: primeira coordenada grande. Veículos e combustível: a segunda.
A seção inteira em quatro colunas
| par | colunas do bag-of-words | contagens | PPMI | PPMI + SVD |
|---|---|---|---|---|
| gato / cachorro | 0,00 | 0,73 | 0,22 | 0,99 |
| carro / automóvel | 0,00 | 0,87 | 0,75 | 1,00 |
| gato / carro | 0,00 | 0,50 | 0,05 | 0,06 |
A mesma compressão em documentos: LSA
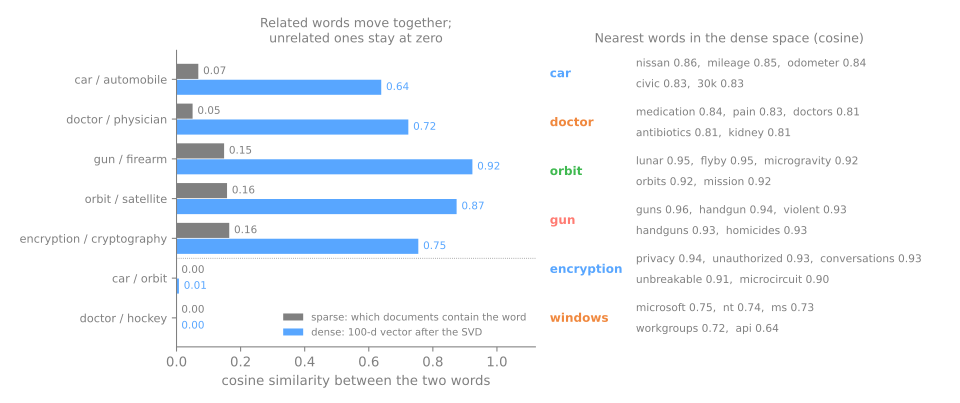
Análise semântica latente (LSA, Deerwester et al., 1990): SVD truncada da matriz TF-IDF, 11.314 posts, 100 componentes.
car/automobile 0,07 → 0,64; gun/firearm 0,15 → 0,92; pares sem relação ficam em 0,00–0,01.
word2vec: aprendendo por predição
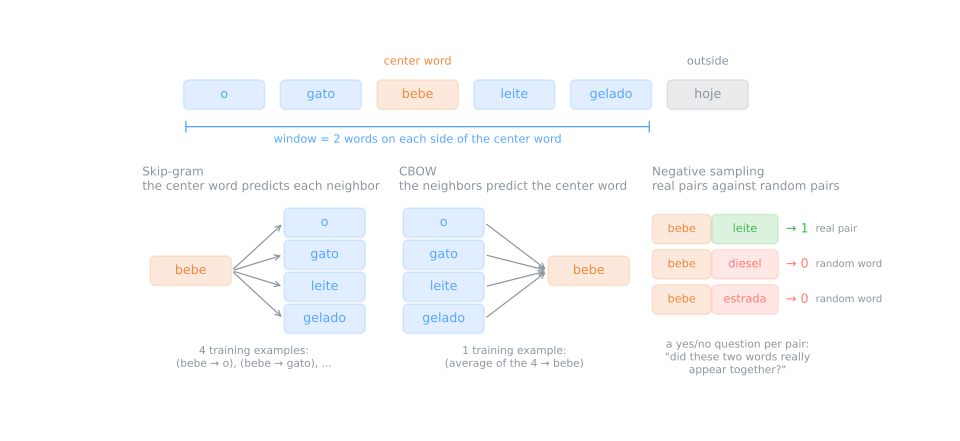
Mikolov et al., 2013. Deslize uma janela e gere exemplos de treino:
- skip-gram: o centro prevê cada vizinho → 18 exemplos de 6 palavras;
- CBOW (continuous bag-of-words): a média dos vizinhos prevê o centro → 6 exemplos.
Como os vetores se aproximam
- Toda palavra começa com um vetor aleatório. Um par (centro, contexto) é pontuado pelo produto escalar.
- O treino empurra os vetores para que os pares que de fato ocorrem tenham nota alta.
- Palavras nos mesmos contextos recebem os mesmos empurrões: a hipótese distribucional virada otimização.
amostragem negativa
Em vez de pontuar as 100.000 palavras: "essas duas apareceram mesmo juntas?" Real (bebe, leite) → 1; aleatório (bebe, diesel) → 0, com 5 a 20 palavras aleatórias por par real.
Treinando: os botões do gensim
| parâmetro | o que faz |
|---|---|
vector_size | números por palavra (de 100 a 300 é o típico) |
window | pequena (2–5): mesma função; grande (10+): mesmo assunto |
sg | 1 = skip-gram (mais lento, melhor para palavras raras); 0 = CBOW |
negative | palavras aleatórias por par real |
min_count | palavras mais raras que isso saem |
epochs, seed | passadas; seed e workers=1 para reprodutibilidade |
GloVe e fastText
GloVe (Pennington et al., 2014)
De volta à contagem: ajusta vetores cujos produtos escalares aproximam o log das contagens de coocorrência de um corpus enorme.
fastText (Bojanowski et al., 2017)
Uma palavra é a soma dos seus n-gramas de caracteres:
latiu → <la, lat, ati, tiu, iu>, <lat, lati, …
6 pedaços em comum com latido
Vetores pré-treinados: GloVe, 400.000 palavras × 50 números
| palavra | mais próximas pelo cosseno |
|---|---|
| car | truck 0,92, cars 0,89, vehicle 0,88, driver 0,85, driving 0,84 |
| mango | pineapple 0,91, guava 0,90, papaya 0,89, pear 0,85, coconut 0,85 |
| brazil | portugal 0,88, argentina 0,87, rica 0,84, spain 0,83, costa 0,83 |
| python | reticulated 0,69, spamalot 0,66, php 0,64, owl 0,63, mouse 0,63 |
Nenhum número sozinho significa algo ("car" começa com 0,48, −0,08, 1,46…); só a geometria significa. "python" mistura a cobra, o Monty Python e a programação.
Parecido não é sinônimo
| car / automobile | 0,70 |
| doctor / physician | 0,80 |
| hot / cold | 0,80 |
| good / bad | 0,80 |
| car / banana | 0,22 |
Um antônimo é a palavra mais intercambiável que existe: "a sopa está quente" / "a sopa está fria".
Analogias, medidas com honestidade
\(\text{king} - \text{man} + \text{woman} \approx\ ?\)
acertos
queen · tokyo · rome · swam · faster · worse · spanish
erros
- bigger − big + small = larger
- brother − man + woman = daughter
- glove − hand + foot = "50,000-square"
Capitais, tempos verbais, comparativos e línguas quase sempre funcionam; relações raras não são direções retas.
O truque silencioso: as palavras de entrada ficam de fora
| sem excluir nada | as três mais próximas |
|---|---|
| king − man + woman | king 0,89, queen 0,85, throne 0,77 |
| doctor − man + woman | doctor 0,90, nurse 0,84, child 0,77 |
- "doctor − man + woman = nurse" só aparece porque "doctor" está proibida (Nissim et al., 2020).
- cos(king − queen, man − woman) = 0,58; um deslocamento sem relação: −0,05.
Simulador: vendo o espaço
Preveja. Clique numa palavra e compare os vizinhos em 50-D (as linhas) com o mapa: o mapa da PCA (24,5% da variância) engana? Depois desmarque "excluir".
Viés: o que os vetores aprenderam sobre pessoas
A média de 8 diferenças (he − she, man − woman, …) dá uma direção de gênero; projete as profissões nela.
| receptionist | −0,31 |
| nurse | −0,30 |
| teacher | 0,00 |
| engineer | 0,24 |
| manager | 0,37 |
| captain | 0,42 |
Para referência: she −0,19, he 0,24. Receptionist pende mais para "she" que o próprio "she"; captain mais para "he" que "he".
O limite: um vetor por palavra
bank
banks, securities, banking, investment, exchange, financial…
bank/money 0,64 · bank/river 0,41
apple
blackberry, chips, iphone, microsoft, ipad…
a fruta não aparece entre as dez
- Um vetor é aproximadamente uma média dos sentidos pesada pela frequência (Arora et al., 2018). Em português: banco, manga, vela.
- "O cachorro mordeu o homem" / "o homem mordeu o cachorro": as mesmas palavras, então só vetores de palavras não dizem quem mordeu quem.
Resumo
- Hipótese distribucional: contextos parecidos → vetores parecidos.
- À mão: contagens de coocorrência → PPMI (tira o óbvio) → SVD (generaliza).
- O word2vec prevê vizinhos e chega perto do mesmo lugar que a contagem. O fastText usa pedaços de palavras.
- Vetores pré-treinados: vizinhos, relação (antônimos também), analogias aproximadas, viés absorvido.
- Um vetor por palavra, qualquer que seja o sentido.
Vetores de palavras de três jeitos
- O primeiro milhão de palavras do text8 (Wikipédia em inglês, limpa).
- Contagem (PPMI + SVD), predição (word2vec) e pré-treinados (GloVe): vizinhos, o teste de analogias (3.732 perguntas), o fastText em palavras nunca vistas e um mapa do espaço.
- Baixe o notebook do lab e abra no Jupyter ou no Colab; no Colab, rode
!pip install gensimantes. - Rode os blocos em ordem e compare com as saídas da página.
Downloads: 31 MB (text8) e 66 MB (GloVe).