E3.3 BERTopic
O BERTopic fica com a segunda resposta de O que é um tópico?: um tópico é um grupo de documentos. Esta página primeiro mede por que isso ajuda, em documentos curtos, onde as contagens de palavras acabam; depois roda os quatro passos do BERTopic um de cada vez nos 2.155 posts e confere que a classe BERTopic faz exatamente o mesmo em uma chamada. A sua abordagem avançada reproduz à mão os nomes dos tópicos, ajusta-os sem mexer nos grupos e lista o que um modelo ajustado sabe fazer.
- O que é um tópico?palavras que andam juntas ou documentos que andam juntos
- LDAalocação latente de Dirichlet: uma história de como as palavras são escritas
- NMFfatoração de matrizes não negativas: um documento como soma de partes
- BERTopicembeddings, redução, agrupamento, descrição
- Comparar e escolheros três lado a lado; as armadilhas
Preparação: o que esta página usa das anteriores
Esta página continua a E3.2 NMF. Se você começar por aqui, rode este bloco antes: ele reconstrói os dois corpora e a matriz TF-IDF dos posts. O BERTopic precisa de pip install bertopic (no Colab também).
import numpy as np
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer

docs_toy = [
    "the team won the game with a late goal",                 # esportes
    "fans cheered when the team scored a goal",
    "the coach said the game was a fair win for the team",
    "the rocket launch put a satellite in orbit",             # espaço
    "nasa delayed the rocket launch to the moon",
    "the satellite reached orbit around the moon",
    "bake the bread in a hot oven",                           # culinária
    "knead the dough and bake the bread slowly",
    "fresh bread from the oven smells great",
    "the team watched the rocket launch before the game",     # esportes + espaço
    "astronauts ate fresh bread on the moon",                 # espaço + culinária
]

def top_words(components, vocab, n=4):
    return [' '.join(vocab[row.argsort()[::-1][:n]]) for row in components]

from sklearn.datasets import fetch_20newsgroups

forums = ['comp.graphics', 'rec.sport.hockey', 'sci.space', 'soc.religion.christian']
ng = fetch_20newsgroups(subset='train', categories=forums, random_state=0,
                        remove=('headers', 'footers', 'quotes'))   # só o corpo do texto
long_enough = np.array([len(text.split()) >= 20 for text in ng.data])
docs = [text for text, keep in zip(ng.data, long_enough) if keep]
y = ng.target[long_enough]                                         # o fórum: usado só para conferir

from sklearn.metrics import adjusted_rand_score

settings = dict(stop_words='english', min_df=5, max_df=0.5,
                token_pattern=r'(?u)\b[a-zA-Z]{3,}\b')             # palavras de 3+ letras, sem números
cv = CountVectorizer(**settings)
X = cv.fit_transform(docs)
vocab = cv.get_feature_names_out()

from sklearn.decomposition import NMF
from sklearn.feature_extraction.text import TfidfVectorizer

tv = TfidfVectorizer(**settings)
T = tv.fit_transform(docs)                                  # mesmo vocabulário de X, pesos TF-IDF
Como esta página está organizada
Como toda página da aula, esta tem duas abordagens, cada uma com os seus slides. A abordagem fundamental faz parte do caminho fundamental da aula, que o quiz da aula cobre e o quiz do fim desta página revisa; a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | E se um tópico for um grupo de documentos, encontrado onde significado é distância? | De onde vêm os nomes dos tópicos? Como melhorá-los sem reagrupar? |
| conteúdo | documentos curtos, onde as contagens de palavras acabam; os quatro passos (embeddings, UMAP, HDBSCAN, c-TF-IDF) um de cada vez; o c-TF-IDF à mão em três grupos; o mesmo modelo em uma chamada | o c-TF-IDF nos 24 grupos dos posts, à mão; o vetorizador e o KeyBERTInspired; get_topic, find_topics, transform e os gráficos |
| no lab | passos 4 a 7 do lab da aula e a simulação os embeddings ou o HDBSCAN? | passos 8 a 10 |
| ao final, você sabe | dizer por que embeddings ajudam em textos curtos; rodar os quatro passos e dizer de que aula vem cada um; calcular uma pontuação c-TF-IDF; ler o tópico −1 | reproduzir as palavras dos tópicos do BERTopic; renomear tópicos com update_topics e conferir que as atribuições não mudaram; usar um modelo ajustado em documentos novos |
Abordagem fundamental
Uma pergunta guia esta parte: e se um tópico for um grupo de documentos? O BERTopic primeiro põe os documentos onde significado parecido é distância curta; depois procura regiões densas e, por fim, descreve cada região pelas suas palavras. Cada passo é uma aula que você já viu.
Esta parte segue um caminho em cinco etapas, desenhado abaixo: 1. por que embeddings; 2. embeddings e redução; 3. agrupar; 4. descrever; 5. em uma chamada. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Por que embeddingsdocumentos curtos compartilham poucas palavras
- Embeddings e redução384 números por post, depois UMAP para 5
- AgruparHDBSCAN; os outliers são o tópico −1
- Descreverc-TF-IDF, o grupo como documento
- Em uma chamadaa classe BERTopic, a mesma partição
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. Documentos curtos: onde as contagens de palavras acabam
Etapa 1. A LDA e a NMF só enxergam um documento pelas contagens de palavras. Um tweet, o título de uma avaliação ou o assunto de um chamado têm de cinco a vinte palavras, então dois documentos sobre o mesmo assunto muitas vezes não compartilham nenhuma. Para medir quanto isso importa, corte cada post do corpus nas primeiras \(n\) palavras e ajuste os dois modelos de novo (script da figura):
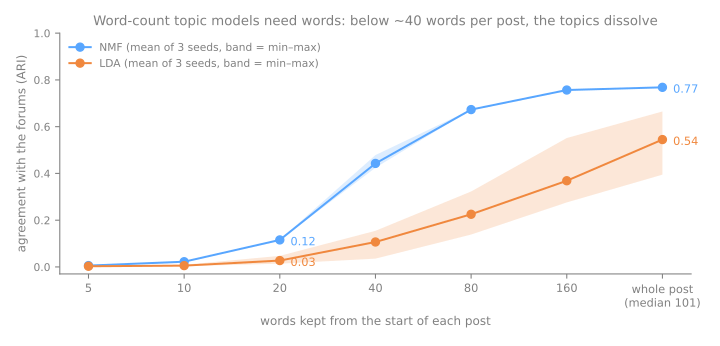
Com as primeiras 20 palavras, os dois modelos ficam perto do acaso: ARI de 0,12 para a NMF e 0,03 para a LDA. Um sentence embedding não precisa de palavras compartilhadas, porque foi treinado em quantidades enormes de texto para pôr perto frases de mesmo significado:
from sklearn.cluster import KMeans
from sklearn.metrics.pairwise import cosine_similarity
from sentence_transformers import SentenceTransformer

pair = ["I want my money back", "please process a refund"]
print(f"TF-IDF cosine:    {cosine_similarity(TfidfVectorizer().fit_transform(pair))[0, 1]:.2f}")
encoder = SentenceTransformer('all-MiniLM-L6-v2')
print(f"embedding cosine: {cosine_similarity(encoder.encode(pair))[0, 1]:.2f}")

short = [' '.join(text.split()[:20]) for text in docs]           # só as primeiras 20 palavras
T_short = TfidfVectorizer(**{**settings, 'min_df': 2}).fit_transform(short)
nmf_short = NMF(n_components=4, init='nndsvda', max_iter=500,
                random_state=0).fit_transform(T_short).argmax(axis=1)
E_short = encoder.encode(short, show_progress_bar=False)
km_short = KMeans(n_clusters=4, n_init=10, random_state=0).fit_predict(E_short)
print(f"first 20 words only -> ARI  NMF on TF-IDF {adjusted_rand_score(y, nmf_short):.3f}"
      f"   k-means on embeddings {adjusted_rand_score(y, km_short):.3f}")
TF-IDF cosine:    0.00
embedding cosine: 0.60
first 20 words only -> ARI  NMF on TF-IDF 0.115   k-means on embeddings 0.582
Os dois pedidos de reembolso não compartilham nenhuma palavra, então os vetores TF-IDF são ortogonais (cosseno 0); já os embeddings têm cosseno de 0,60. Nos posts de 20 palavras, um k-means simples sobre os embeddings chega a um ARI de 0,582, cinco vezes o da NMF. Essa é a ideia por trás do BERTopic: primeiro pôr os documentos num espaço em que distância reflete significado, depois procurar grupos.
2. BERTopic: tópicos como grupos de documentos
O BERTopic (Grootendorst, 2022) troca a história generativa por uma geométrica: gerar embeddings dos documentos para que significado parecido vire proximidade no espaço, achar as regiões densas e descrever cada região pelas suas palavras. É uma cadeia de quatro passos independentes; cada um é tema de uma aula que você já viu:
Esta seção roda os passos um de cada vez nos 2.155 posts e inspeciona a saída de cada um; a seguinte mostra que o BERTopic faz exatamente o mesmo em uma chamada. Fora deste site, instale-o com pip install bertopic (no Colab também); ele traz junto sentence-transformers, umap-learn e hdbscan.
Passo 1 — embeddings
Etapa 2. O primeiro passo transforma cada post num vetor de 384 números; uma verificação rápida mede depois se esse espaço põe juntos os posts do mesmo fórum:
from sklearn.neighbors import NearestNeighbors

E = encoder.encode(docs, show_progress_bar=False)       # etapa 1: um vetor de 384 dimensões por post
print(E.shape)

def same_forum_neighbors(V, metric, k=10):             # fração dos k posts mais próximos de cada post
    nn = NearestNeighbors(n_neighbors=k + 1, metric=metric).fit(V)   # que são do mesmo fórum
    idx = nn.kneighbors(V, return_distance=False)[:, 1:]
    return (y[idx] == y[:, None]).mean()

print(f"10 nearest neighbors in the same forum:  TF-IDF {same_forum_neighbors(T, 'cosine'):.3f}"
      f"   embeddings {same_forum_neighbors(E, 'cosine'):.3f}")
all-MiniLM-L6-v2 é um sentence-transformer pequeno (Reimers & Gurevych, 2019): 384 dimensões, rápido em CPU, treinado em inglês. Ele lê só as primeiras 256 subpalavras de cada post, o que basta aqui. Uma verificação rápida de que o espaço é útil antes de agrupar nele: para cada post, tome os 10 posts mais próximos e conte quantos são do mesmo fórum. Com vetores TF-IDF, 83,2%; com embeddings, 94,2%.
Passo 2 — reduzir com UMAP
O agrupamento por densidade sofre em 384 dimensões: as distâncias se concentram e todo ponto parece mais ou menos igualmente longe de todos os outros (a maldição da dimensionalidade). O BERTopic primeiro comprime os embeddings com o UMAP (McInnes, Healy & Melville, 2018), que preserva a vizinhança de cada ponto:
from umap import UMAP

umap_model = UMAP(n_neighbors=15, n_components=5, min_dist=0.0, metric='cosine',
                  random_state=42)                      # padrões do BERTopic, mais uma semente
Z = umap_model.fit_transform(E)                         # etapa 2: 384 -> 5 dimensões
print(Z.shape)
print(f"10 nearest neighbors in the same forum after UMAP: {same_forum_neighbors(Z, 'euclidean'):.3f}")
Cinco dimensões, não duas: o objetivo é agrupar, não desenhar; duas dimensões espremeriam demais. min_dist=0.0 deixa o UMAP juntar bem os pontos parecidos, que é o que um agrupador por densidade quer. As vizinhanças sobreviveram à compressão (95,4% dos vizinhos do mesmo fórum, um pouco mais que em 384 dimensões). O UMAP é estocástico; random_state o torna repetível, um ponto ao qual as armadilhas voltam.
Passo 3 — agrupar com HDBSCAN; outliers são o tópico −1
Etapa 3. O HDBSCAN (Campello, Moulavi & Sander, 2013) encontra regiões densas de qualquer forma e densidade, com um botão principal, min_cluster_size. Duas propriedades dele importam aqui: o número de grupos sai dos dados e ele não força todo ponto a entrar num grupo (pontos em regiões esparsas recebem o rótulo −1). O BERTopic usa o pacote hdbscan, o mesmo algoritmo do sklearn.cluster.HDBSCAN da aula de agrupamento, em outra implementação:
from hdbscan import HDBSCAN

hdbscan_model = HDBSCAN(min_cluster_size=10, metric='euclidean',
                        cluster_selection_method='eom', prediction_data=True)
labels = hdbscan_model.fit_predict(Z)                   # etapa 3: regiões densas; -1 = outlier
n_clusters = labels.max() + 1
print(n_clusters, 'clusters |', (labels == -1).sum(), f'outliers ({(labels == -1).mean():.1%})')

tab = pd.crosstab(labels, np.array(forums)[y], rownames=['cluster'], colnames=['forum'])
share = (tab.max(axis=1) / tab.sum(axis=1)).drop(-1)   # fração do fórum majoritário em cada grupo
print(f"clusters whose majority forum holds at least 90% of the posts: {(share >= 0.9).sum()} of {n_clusters}")
print(tab.loc[[-1, 0, 1, 2, 3]])
24 clusters | 431 outliers (20.0%)
clusters whose majority forum holds at least 90% of the posts: 21 of 24
forum    comp.graphics  rec.sport.hockey  sci.space  soc.religion.christian
cluster
-1                 197                 7        221                       6
 0                   0               516          4                       0
 1                   0                 3         10                     554
 2                  13                 0          1                       2
 3                  11                 0          1                       0
24 grupos (não 4) e 431 posts (20%) deixados de fora como outliers. Os grupos são puros: em 21 dos 24, pelo menos 90% dos posts vêm de um único fórum. Hóquei e religião formam, cada um, um grupo grande (516 e 554 posts), enquanto computação gráfica e espaço se partem em muitos grupos pequenos, que é o que eles são: formatos de arquivo, placas de vídeo, processamento de imagens, a Lua, o ônibus espacial... A maior parte dos outliers também são posts de computação gráfica e de espaço, os dois fóruns de conteúdo mais variado. Nem \(k\) nem o número de outliers foram fixados em lugar nenhum: os dois decorrem de min_cluster_size=10 e da densidade dos dados.
O simulador abaixo roda o mesmo algoritmo numa nuvem 2-D de brinquedo: um grupo grande e homogêneo, duas regiões feitas de lóbulos pequenos, um grupo médio e ruído espalhado. Mova min_cluster_size um valor por vez e observe os gráficos da direita: o número de tópicos cai aos poucos?
Não cai: o número fica parado por vários valores e depois despenca de uma vez; a fração de outliers salta junto. As armadilhas mostram o mesmo degrau nos posts: 24 tópicos com min_cluster_size=10 e 5 com 15.
Passo 4 — descrever cada grupo com c-TF-IDF
Etapa 4. Um grupo é uma lista de documentos; pessoas precisam de algumas palavras. O BERTopic junta todos os documentos de um grupo num único pseudodocumento longo e aplica aos pseudodocumentos um TF-IDF por classe (class-based TF-IDF):
em que \(n_{t,c}\) é a contagem da palavra \(t\) no grupo \(c\), o primeiro fator é a sua frequência dentro do grupo, \(f_t\) é a contagem de \(t\) em todos os grupos e \(A\) é o número médio de palavras por grupo. É o TF-IDF que você conhece, com o grupo no papel do documento: uma palavra pontua alto quando é frequente neste grupo e rara nos outros.
À mão, tome as nove frases de tema único do corpus feito à mão como três grupos:
classes = {'sports': docs_toy[0:3], 'space': docs_toy[3:6], 'cooking': docs_toy[6:9]}
joined = [' '.join(d) for d in classes.values()]         # um pseudodocumento por grupo
cv_c = CountVectorizer(stop_words='english')
C = cv_c.fit_transform(joined).toarray()                 # grupos x palavras: contagens
words_c = list(cv_c.get_feature_names_out())
size = C.sum(axis=1)                                     # palavras por grupo
A = int(size.mean())                                     # média de palavras por grupo (truncada)
print('words per cluster:', size, '  A =', A)

rows = []
for w in ['team', 'game', 'launch', 'moon', 'bread']:
    j = words_c.index(w)
    f = C[:, j].sum()                                    # frequência de w em todos os grupos
    idf = np.log(1 + A / f)
    rows.append([w, *C[:, j], f, round(idf, 3), *(C[:, j] / size * idf).round(3)])
print(pd.DataFrame(rows, columns=['word', 'n_sports', 'n_space', 'n_cooking', 'f', 'idf',
                                  'sports', 'space', 'cooking']).to_string(index=False))
words per cluster: [16 13 14]   A = 14
  word  n_sports  n_space  n_cooking  f   idf  sports  space  cooking
  team         3        0          0  3 1.735   0.325   0.00    0.000
  game         2        0          0  2 2.079   0.260   0.00    0.000
launch         0        2          0  2 2.079   0.000   0.32    0.000
  moon         0        2          0  2 2.079   0.000   0.32    0.000
 bread         0        0          3  3 1.735   0.000   0.00    0.372
O grupo de esportes tem 16 palavras, o de espaço 13 e o de culinária 14, então \(A = \lfloor 43/3 \rfloor = 14\) (o BERTopic trunca a média para um inteiro). team aparece 3 vezes, todas em esportes: \(\text{idf} = \log(1 + 14/3) = 1{,}735\); em esportes, a pontuação é \(3/16 \times 1{,}735 = 0{,}325\). game aparece só duas vezes, então o idf é maior (\(\log 8 = 2{,}079\)), mas a frequência é menor: \(2/16 \times 2{,}079 = 0{,}260\). O simulador percorre a mesma tabela uma palavra por vez, com as palavras de cada grupo desenhadas ao lado da fórmula:
O transformador do próprio BERTopic dá a mesma matriz:
from bertopic.vectorizers import ClassTfidfTransformer

ctfidf = ClassTfidfTransformer().fit_transform(C)                   # a classe do próprio BERTopic
by_hand = C / size[:, None] * np.log(1 + A / C.sum(axis=0))
print("BERTopic == by hand:", np.allclose(ctfidf, by_hand))
print(top_words(ctfidf, np.array(words_c)))
BERTopic == by hand: True
['team game goal won', 'orbit launch satellite moon', 'bread bake oven hot']
O vetorizador decide quais palavras podem dar nome a um tópico: o c-TF-IDF só pontua as palavras que ele mantém. É por isso que todo vetorizador desta página leva uma lista de stop words do inglês; sem ela, as palavras mais frequentes de qualquer grupo grande são the, of, to (a abordagem avançada mostra isso).
3. Os quatro passos em uma chamada
Etapa 5. O BERTopic encadeia os mesmos quatro passos. Passe a ele os mesmos objetos UMAP e HDBSCAN e um vetorizador com stop words; entregue também os embeddings do passo 1, para que ele não os calcule de novo:
from bertopic import BERTopic

cv_topics = CountVectorizer(stop_words='english', token_pattern=r'(?u)\b[a-zA-Z]{3,}\b')
topic_model = BERTopic(embedding_model=encoder, umap_model=umap_model,
                       hdbscan_model=hdbscan_model, vectorizer_model=cv_topics)
topics = np.array(topic_model.fit_transform(docs, embeddings=E)[0])   # reaproveita os vetores da etapa 1
print("same partition as the stages above (ARI):", round(adjusted_rand_score(labels, topics), 3))
info = topic_model.get_topic_info()
print(info[['Topic', 'Count', 'Name']].head(8).to_string(index=False))
same partition as the stages above (ARI): 1.0
 Topic  Count                                Name
    -1    431          -1_space_jpeg_launch_image
     0    567           0_god_jesus_people_church
     1    520             1_team_game_hockey_play
     2     66 2_image_graphics_package_processing
     3     55                3_card_mode_vesa_vga
     4     52            4_moon_lunar_prize_money
     5     43      5_space_nasa_shuttle_astronaut
     6     41                 6_van_het_orbit_een
ARI 1,0: a mesma partição dos posts dos passos 1 a 3, só renumerada por tamanho (o tópico 0 é o maior). Cada Name junta as quatro primeiras palavras do c-TF-IDF do tópico, calculado sobre os seus posts exatamente como no passo 4. Os outliers também ganham uma descrição (space, jpeg, launch, image: sobras dos dois fóruns mais variados). Sem embeddings=E, o fit_transform geraria ele mesmo os embeddings com o embedding_model; sem umap_model e hdbscan_model, usaria essas mesmas configurações, mas sem semente: cada rodada poderia dar tópicos diferentes.
4. Resumo: o BERTopic em quatro linhas
- Documentos curtos compartilham poucas palavras, então os modelos de contagem enxergam pouco; um sentence embedding põe perto documentos de mesmo significado mesmo sem nenhuma palavra em comum.
- Quatro passos independentes: embeddings (sentence-transformers), redução para umas 5 dimensões (UMAP), regiões densas (HDBSCAN), um nome para cada região (c-TF-IDF).
- O HDBSCAN define o número de tópicos a partir de
min_cluster_sizee da densidade; os posts das regiões esparsas ficam no tópico −1. - O c-TF-IDF é o TF-IDF com o grupo no papel do documento: uma palavra dá nome a um tópico quando é frequente no seu grupo e rara nos outros, entre as palavras que o vetorizador mantém.
No lab. Os passos 4 a 7 constroem o BERTopic um passo por vez em cinco outros fóruns e depois em uma chamada.
Para fechar a parte fundamental. Em uma frase cada: (1) por que o BERTopic reduz os embeddings para 5 dimensões e não para 2? (2) O que o tópico −1 guarda? Por que a LDA e a NMF não têm nada parecido? (3) Por que game tem peso maior que team no c-TF-IDF do passo 4 e, mesmo assim, pontua menos em esportes?
Sua vez (fundamental)
- Um tamanho de grupo menor. Refaça o passo 3 com
min_cluster_size=5. Quantos grupos e quantos outliers? Os grupos novos continuam puros? - O cosseno do seu par. Escreva em inglês duas frases que digam a mesma coisa sem nenhuma palavra em comum e calcule os cossenos na TF-IDF e nos embeddings, como na seção 1. Depois tente duas frases que compartilham muitas palavras mas querem dizer coisas diferentes.
Abordagem avançada
A abordagem fundamental deu nome aos tópicos com o c-TF-IDF do próprio BERTopic. Esta parte abre essa caixa: calcula à mão os nomes dos 24 grupos e os confere com os do BERTopic, troca os nomes sem mexer nos grupos e termina com o que um modelo ajustado oferece além da tabela. Os blocos de código continuam os das seções 1 a 3.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. nomes à mão; 2. ajustar as palavras; 3. um modelo ajustado como ferramenta. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Nomes à mãoc-TF-IDF nos 24 grupos, conferido
- Ajustar as palavrasstop words; KeyBERTInspired
- Um modelo ajustado como ferramentabusca, documentos novos, gráficos
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
5. c-TF-IDF nos posts, à mão
Etapa 1. O passo 4 calculou o c-TF-IDF em três grupos de brinquedo. Agora a mesma conta nos 24 grupos dos posts, mais o "grupo" −1 dos outliers, que o BERTopic também descreve. Antes de contar, o BERTopic troca quebras de linha e tabulações por espaços; o código faz o mesmo, com um vetorizador próprio:
from bertopic.vectorizers import ClassTfidfTransformer

frame = pd.DataFrame({'doc': docs, 'cluster': labels})
per_cluster = frame.groupby('cluster')['doc'].apply(' '.join)        # -1 também é um "grupo"
cleaned = [t.replace('\n', ' ').replace('\t', ' ') for t in per_cluster]   # como o BERTopic faz
cv_hand = CountVectorizer(stop_words='english', token_pattern=r'(?u)\b[a-zA-Z]{3,}\b')
W_ctfidf = ClassTfidfTransformer().fit_transform(cv_hand.fit_transform(cleaned)).toarray()
hand_words = dict(zip(per_cluster.index, top_words(W_ctfidf, cv_hand.get_feature_names_out(), 5)))
sizes = frame['cluster'].value_counts()
for c in [-1] + list(sizes.drop(-1).index[:5]):                     # os outliers, depois os 5 maiores
    print(f"cluster {c:>2}  {sizes[c]:>4} posts  {' '.join(hand_words[c].split()[:4])}")

same_words = all(' '.join(w for w, _ in topic_model.get_topic(t)[:5])
                 == hand_words[pd.Series(labels[topics == t]).mode()[0]] for t in set(topics))
print("same top-5 words as BERTopic, for every topic:", same_words)
cluster -1   431 posts  space jpeg launch image
cluster  1   567 posts  god jesus people church
cluster  0   520 posts  team game hockey play
cluster 15    66 posts  image graphics package processing
cluster  9    55 posts  card mode vesa vga
cluster 23    52 posts  moon lunar prize money
same top-5 words as BERTopic, for every topic: True
O HDBSCAN numera os grupos sem ordem especial: o grupo 1 é religião, o 15 processamento de imagens, o 23 a Lua; o BERTopic os renumera por tamanho (o grupo 1 virou o tópico 0). As palavras do topo de cada tópico são as calculadas à mão, comparadas nas 5 primeiras: mais abaixo na lista, palavras com pontuações empatadas podem sair em outra ordem.
6. Ajustar a representação, não os grupos
Etapa 2. As palavras que nomeiam um tópico são calculadas depois do agrupamento, então podem ser trocadas sem mexer nos grupos. Duas comparações no tópico 2 (processamento de imagens):
before = [w for w, _ in topic_model.get_topic(2)]
raw = BERTopic(embedding_model=encoder, umap_model=umap_model, hdbscan_model=hdbscan_model)
raw.fit(docs, embeddings=E)                                         # vetorizador padrão: sem lista de stop words
print('default vectorizer:', ' '.join(w for w, _ in raw.get_topic(2)))
print('stop words removed:', ' '.join(before))

from bertopic.representation import KeyBERTInspired
topic_model.update_topics(docs, vectorizer_model=cv_topics, representation_model=KeyBERTInspired())
print('KeyBERTInspired   :', ' '.join(w for w, _ in topic_model.get_topic(2)))
print("assignments unchanged:", (np.array(topic_model.topics_) == topics).all())
default vectorizer: image and for of to it or the graphics with
stop words removed: image graphics package processing software data analysis user program version
KeyBERTInspired   : graphical graphics rtrace plots tools interactive plotting software adobe tool
assignments unchanged: True
Com o vetorizador padrão do BERTopic, as palavras do topo de um tópico são and, for, of, to, the: palavras frequentes em todo lugar ainda ganham na frequência dentro de um grupo grande. Uma lista de stop words resolve isso (é por isso que vectorizer_model foi passado desde o início). O KeyBERTInspired vai além: reordena as palavras candidatas pelo cosseno entre o embedding de cada palavra e os documentos típicos do tópico, favorecendo palavras que capturam o sentido (graphical, plots, tools) sobre palavras apenas frequentes. O update_topics mudou as palavras e nada mais: as atribuições post-tópico são idênticas.
7. Um modelo ajustado como ferramenta
Etapa 3. Um modelo ajustado oferece mais que a tabela: get_topic(t) dá as palavras do topo com as pontuações, get_representative_docs(t) alguns documentos típicos, find_topics("rocket engines") busca tópicos pelo significado, transform(new_docs) atribui documentos novos aos tópicos existentes; visualize_topics(), visualize_barchart() ou visualize_documents() desenham gráficos interativos em Plotly. O reduce_topics junta tópicos parecidos depois do ajuste e o reduce_outliers dá um tópico aos outliers; as armadilhas medem quanto os dois custam. O lab avançado usa vários deles em cinco outros fóruns.
Sua vez (avançado)
- Outra representação. Chame
update_topicscomrepresentation_model=MaximalMarginalRelevance(diversity=0.5)(debertopic.representation). Como mudam as palavras do tópico 2 em comparação com oKeyBERTInspired? As atribuições mudam? - Busca pelo significado. Use
find_topicscom três consultas suas ("rocket engines", "church service", "3d rendering"). Quais tópicos voltam e com que similaridade? Alguma resposta surpreende? - As palavras dos outliers. Leia três dos 431 posts do tópico −1. As palavras space, jpeg, launch, image os descrevem ou só descrevem a mistura de fóruns de onde eles vêm?
Referências
- Grootendorst, M. "BERTopic: Neural Topic Modeling with a Class-based TF-IDF Procedure." arXiv (2022). arXiv:2203.05794
- Reimers, N.; Gurevych, I. "Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks." EMNLP-IJCNLP (2019) — os sentence-transformers por trás do passo 1. arXiv:1908.10084
- McInnes, L.; Healy, J.; Melville, J. "UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction." arXiv (2018). arXiv:1802.03426
- Campello, R. J. G. B.; Moulavi, D.; Sander, J. "Density-Based Clustering Based on Hierarchical Density Estimates." PAKDD (2013), LNCS 7819: 160–172 — o HDBSCAN. DOI
- BERTopic — a documentação da biblioteca.
Quiz
O quiz revisa a abordagem fundamental desta página; o quiz da aula cobre as cinco páginas.
Próxima: E3.4 Comparando os Modelos, os três modelos lado a lado e as armadilhas.