O caminho desta parte
- Por que embeddingsdocumentos curtos compartilham poucas palavras
- Embeddings e redução384 números por post, depois UMAP para 5
- AgruparHDBSCAN; os outliers são o tópico −1
- Descreverc-TF-IDF, o grupo como documento
- Em uma chamadaa classe BERTopic, a mesma partição
Documentos curtos: onde as contagens de palavras acabam
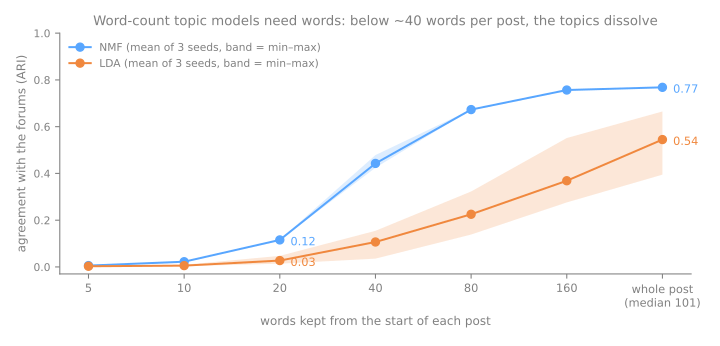
A LDA (alocação latente de Dirichlet) e a NMF (fatoração de matrizes não negativas) só veem contagens de palavras. Com as 20 primeiras palavras de cada post, ARI (índice de Rand ajustado) com os fóruns: NMF 0,12, LDA 0,03.
Significado como distância
cosseno na TF-IDF
cosseno dos embeddings
Nos posts de 20 palavras, um k-means simples nos embeddings chega a ARI 0,582, cinco vezes o da NMF.
BERTopic: quatro passos, cada um uma aula que você conhece
Passo 1 — embeddings
Cada post → 384 números com o all-MiniLM-L6-v2 (um sentence-transformer pequeno, em inglês, rápido numa CPU).
TF-IDF
embeddings
Passo 2 — reduzir com UMAP
- Em 384 dimensões as distâncias se concentram: o agrupamento por densidade sofre.
- UMAP (uniform manifold approximation and projection) para 5 dimensões, não 2: o objetivo é agrupar, não desenhar.
min_dist=0.0junta bem os pontos parecidos, o que um agrupador por densidade quer.
random_state.Passo 3 — agrupar com HDBSCAN
HDBSCAN (agrupamento hierárquico por densidade) acha regiões densas de qualquer forma; um botão principal, min_cluster_size=10.
grupos
min_cluster_size e da densidadeoutliers (−1)
puros
Hóquei (516) e religião (554) viram um grupo grande cada; computação gráfica e espaço se partem em muitos pequenos (formatos de arquivo, placas de vídeo, a Lua…).
Simulador: min_cluster_size, um valor por vez
Preveja. Suba o min_cluster_size de 2 a 40: o número de tópicos cai aos poucos?
Passo 4 — descrever cada grupo com c-TF-IDF
Junte os documentos de um grupo num pseudodocumento e aplique um TF-IDF por classe (c-TF-IDF):
\[ \text{c-TF-IDF}(t, c) = \frac{n_{t,c}}{\sum_{t'} n_{t',c}} \times \log\!\Big(1 + \frac{A}{f_t}\Big) \]- \(n_{t,c}\): contagem da palavra \(t\) no grupo \(c\); o denominador: todas as palavras de \(c\)
- \(f_t\): contagem de \(t\) em todos os grupos · \(A\): média de palavras por grupo
O c-TF-IDF à mão, passo a passo
As nove frases de tema único como três grupos. Preveja. team aparece 3 vezes e game 2, as duas só em esportes: qual ganha o peso maior, e qual a nota maior?
Os quatro passos em uma chamada
Os mesmos objetos e os embeddings do passo 1 em BERTopic(...): a mesma partição (ARI 1,0), renumerada por tamanho.
| tópico | posts | Name |
|---|---|---|
| −1 | 431 | -1_space_jpeg_launch_image |
| 0 | 567 | 0_god_jesus_people_church |
| 1 | 520 | 1_team_game_hockey_play |
| 2 | 66 | 2_image_graphics_package_processing |
| 3 | 55 | 3_card_mode_vesa_vga |
| 4 | 52 | 4_moon_lunar_prize_money |
| 5 | 43 | 5_space_nasa_shuttle_astronaut |
| 6 | 41 | 6_van_het_orbit_een |
Resumo
- Documentos curtos compartilham poucas palavras; um sentence embedding põe perto os documentos de mesmo significado mesmo assim.
- Quatro passos independentes: embeddings → UMAP → HDBSCAN → c-TF-IDF.
- O HDBSCAN define o número de tópicos; os posts esparsos vão para o tópico −1.
- O c-TF-IDF dá nome a um grupo por palavras frequentes nele e raras nos outros.
Para fechar a parte fundamental
- Por que o BERTopic reduz os embeddings para 5 dimensões e não para 2?
- O que o tópico −1 guarda? Por que a LDA e a NMF não têm nada parecido?
- Por que game tem peso maior que team e, mesmo assim, pontua menos em esportes?
No lab: os passos 4 a 7 e a simulação os embeddings ou o HDBSCAN? (página de visão geral). A seguir: os slides fundamentais da E3.4 Comparando os Modelos.