E3.1 LDA
A LDA (Latent Dirichlet Allocation, alocação latente de Dirichlet) fica com a primeira resposta de O que é um tópico?: um tópico é uma distribuição sobre palavras e um documento é uma mistura de tópicos. Esta página conta a sua história à mão, mostra o que a priori de Dirichlet controla e a roda em 2.155 posts reais de fóruns; depois confere, num corpus sintético, que o ajuste recupera os tópicos verdadeiros e a vê falhar nas onze frases escritas à mão. Todo número sai do código ao lado.
- O que é um tópico?palavras que andam juntas ou documentos que andam juntos
- LDAalocação latente de Dirichlet: uma história de como as palavras são escritas
- NMFfatoração de matrizes não negativas: um documento como soma de partes
- BERTopicembeddings, redução, agrupamento, descrição
- Comparar e escolheros três lado a lado; as armadilhas
Preparação: o que esta página usa das anteriores
Esta página continua a visão geral. Se você começar por aqui, rode este bloco antes: ele reconstrói o corpus escrito à mão.
import numpy as np
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer

docs_toy = [
    "the team won the game with a late goal",                 # esportes
    "fans cheered when the team scored a goal",
    "the coach said the game was a fair win for the team",
    "the rocket launch put a satellite in orbit",             # espaço
    "nasa delayed the rocket launch to the moon",
    "the satellite reached orbit around the moon",
    "bake the bread in a hot oven",                           # culinária
    "knead the dough and bake the bread slowly",
    "fresh bread from the oven smells great",
    "the team watched the rocket launch before the game",     # esportes + espaço
    "astronauts ate fresh bread on the moon",                 # espaço + culinária
]
cv_toy = CountVectorizer(stop_words='english')
X_toy = cv_toy.fit_transform(docs_toy)
words_toy = cv_toy.get_feature_names_out()
Como esta página está organizada
Como toda página da aula, esta tem duas abordagens, cada uma com os seus slides. A abordagem fundamental faz parte do caminho fundamental da aula, que o quiz da aula cobre e o quiz do fim desta página revisa; a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Que história a LDA conta sobre como um documento é escrito e o que ela encontra em posts reais? | O ajuste recupera mesmo os tópicos? Quando ele falha? |
| conteúdo | a história generativa e \(p(w \mid d)\) à mão; a priori de Dirichlet \(\alpha\); a LDA em 2.155 posts, lida pelas palavras do topo e pelo ARI com os fóruns | o ajuste num corpus sintético de tópicos conhecidos; as 11 frases escritas à mão, em que 53 palavras não bastam; as duas prioris e a semente no scikit-learn |
| no lab | passo 2 do lab da aula: a LDA em cinco outros fóruns | Sua vez (avançado) |
| ao final, você sabe | calcular \(p(w \mid d)\) de uma mistura; dizer o que um \(\alpha\) pequeno ou grande faz; ajustar a LDA e ler components_ e transform | testar um modelo em dados gerados pela sua própria história; explicar por que a LDA precisa de muitos documentos com palavras suficientes; escolher as prioris de propósito |
Abordagem fundamental
Uma pergunta guia esta parte: que história poderia ter escrito estas palavras? A LDA responde com um processo aleatório que sorteia um tópico para cada posição de palavra; ajustar a LDA é rodar essa história de trás para a frente. Esta parte conta a história à mão, mostra o que a sua priori controla e a roda em posts reais.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. contar a história; 2. a priori de Dirichlet; 3. ajustar posts reais. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Contar a históriaum tópico por posição, depois uma palavra desse tópico
- A priori de Dirichletquão misturado é um documento típico?
- Ajustar posts reais2.155 posts, palavras do topo, ARI com os fóruns
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. A história generativa
Etapa 1. A Latent Dirichlet Allocation (Blei, Ng & Jordan, 2003) imagina que cada documento foi escrito por um processo aleatório:
- cada tópico \(k\) é uma distribuição de probabilidade \(\varphi_k\) sobre o vocabulário;
- cada documento \(d\) tem sua própria mistura de tópicos \(\theta_d\), por exemplo \((0{,}8;\ 0{,}2)\);
- para cada posição de palavra do documento, sorteie um tópico \(z\) de \(\theta_d\) e depois sorteie a palavra de \(\varphi_z\).
É uma história de como as palavras foram parar ali, não uma afirmação de que as pessoas escrevem assim. A ordem das palavras não entra nela; é por isso que a LDA só precisa das contagens bag-of-words. A história fixa a probabilidade de cada palavra no documento \(d\):
À mão, com dois tópicos sobre seis palavras e um documento que é 80% esportes: \(p(\textit{team}) = 0{,}8 \times 0{,}40 + 0{,}2 \times 0{,}05 = 0{,}33\) e \(p(\textit{rocket}) = 0{,}8 \times 0{,}05 + 0{,}2 \times 0{,}40 = 0{,}12\). O código faz o mesmo para cada palavra e depois escreve um documento de 12 palavras seguindo a história:
vocab = np.array(['team', 'goal', 'game', 'rocket', 'orbit', 'moon'])
phi = np.array([[0.40, 0.30, 0.20, 0.05, 0.00, 0.05],     # tópico 0: "esportes"
                [0.05, 0.00, 0.05, 0.40, 0.30, 0.20]])    # tópico 1: "espaço"
theta = np.array([0.8, 0.2])                              # este documento: 80% esportes, 20% espaço

p_word = theta @ phi                                      # p(w|d) = soma em k de theta_k * phi_kw
print('  '.join(f"{w} {p:.2f}" for w, p in zip(vocab, p_word)))

rng = np.random.default_rng(0)
z = rng.choice(2, size=12, p=theta)                       # um tópico para cada posição de palavra...
words = [rng.choice(vocab, p=phi[k]) for k in z]          # ...depois uma palavra sorteada desse tópico
print(z)
print(' '.join(words))
team 0.33  goal 0.24  game 0.17  rocket 0.12  orbit 0.06  moon 0.08
[0 0 0 0 1 1 0 0 0 1 1 0]
game team game team moon orbit team goal team rocket orbit goal
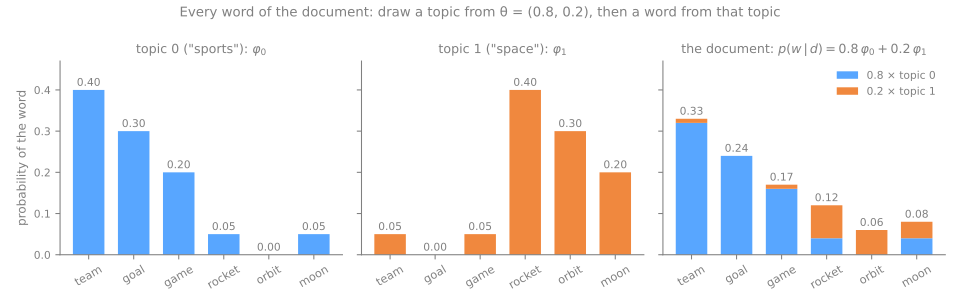
Quatro das doze posições sortearam o tópico 1: são justamente as posições de moon, orbit, rocket, orbit. O documento é quase todo esportes, com um pouco de espaço, como diz \(\theta\) (script da figura).
2. A priori de Dirichlet: quão misturado é um documento?
Etapa 2. O "Dirichlet" do nome é a distribuição da qual as misturas \(\theta_d\) são sorteadas. Seu parâmetro \(\alpha\) controla quão misturado é um documento típico:
rng = np.random.default_rng(1)
for alpha in [0.1, 1.0, 10.0]:
    thetas = rng.dirichlet([alpha] * 3, size=2000)        # misturas de tópicos de 2000 documentos
    print(f"alpha={alpha:<4}  one document: {thetas[0].round(2)}   "
          f"average largest share: {thetas.max(axis=1).mean():.2f}")
alpha=0.1   one document: [0. 1. 0.]   average largest share: 0.89
alpha=1.0   one document: [0.01 0.65 0.34]   average largest share: 0.62
alpha=10.0  one document: [0.18 0.46 0.36]   average largest share: 0.42
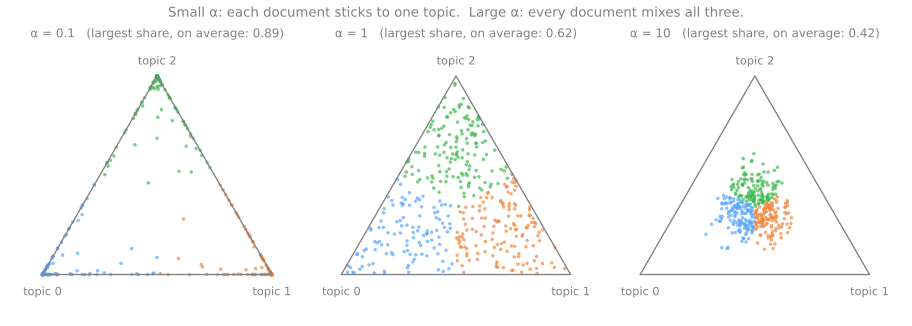
Com \(\alpha = 0{,}1\), um documento dá, em média, 89% das palavras a um único tópico; com \(\alpha = 10\), o maior tópico fica com só 42%, pouco acima do \(1/3\) de uma mistura perfeita (script da figura). No scikit-learn, \(\alpha\) é o doc_topic_prior de LatentDirichletAllocation, \(1/k\) por padrão: menor que 1, então a LDA espera documentos concentrados em poucos tópicos.
Experimente abaixo: arraste a mistura \(\theta\) do documento dentro do triângulo e veja as doze posições mudarem de cor uma a uma; depois ponha \(\alpha\) em 0,1 e em 10 e aperte sortear θ da Dirichlet(α) algumas vezes. Os três tópicos usam o \(\varphi\) do corpus sintético da abordagem avançada (0,35, 0,30 e 0,25 nas suas três palavras).
Com \(\alpha\) pequeno quase todo documento sorteado sai de uma cor só; com \(\alpha\) grande todo documento mistura os três tópicos. As barras são \(p(w \mid d)\): as doze palavras oscilam em torno delas.
3. LDA em posts reais
Etapa 3. Ajustar a LDA roda a história de trás para a frente: só a partir das palavras observadas, ela estima os tópicos \(\varphi\) e as misturas \(\theta\). No scikit-learn, LatentDirichletAllocation(n_components=k).fit(X) faz isso numa matriz de contagens; cada linha de components_, dividida pela sua soma, é um tópico estimado \(\varphi_k\); transform(X) dá o \(\theta_d\) de cada documento. A abordagem avançada confere, num corpus de tópicos conhecidos, que as estimativas estão certas.
O corpus real: posts de quatro fóruns da clássica coleção 20 Newsgroups, sem cabeçalhos, sem respostas citadas e sem a maior parte das assinaturas, descartados os posts com menos de 20 palavras. O fórum de cada post fica guardado à parte, em y, só para conferir os tópicos depois:
from sklearn.datasets import fetch_20newsgroups

forums = ['comp.graphics', 'rec.sport.hockey', 'sci.space', 'soc.religion.christian']
ng = fetch_20newsgroups(subset='train', categories=forums, random_state=0,
                        remove=('headers', 'footers', 'quotes'))   # só o corpo do texto
long_enough = np.array([len(text.split()) >= 20 for text in ng.data])
docs = [text for text, keep in zip(ng.data, long_enough) if keep]
y = ng.target[long_enough]                                         # o fórum: usado só para conferir
print(len(ng.data), '->', len(docs), 'posts with at least 20 words')
print(pd.Series(np.array(forums)[y]).value_counts())
2376 -> 2155 posts with at least 20 words
soc.religion.christian    565
sci.space                 535
rec.sport.hockey          534
comp.graphics             521
Name: count, dtype: int64
from sklearn.decomposition import LatentDirichletAllocation
from sklearn.metrics import adjusted_rand_score

def top_words(components, vocab, n=4):
    return [' '.join(vocab[row.argsort()[::-1][:n]]) for row in components]

settings = dict(stop_words='english', min_df=5, max_df=0.5,
                token_pattern=r'(?u)\b[a-zA-Z]{3,}\b')             # palavras de 3+ letras, sem números
cv = CountVectorizer(**settings)
X = cv.fit_transform(docs)
vocab = cv.get_feature_names_out()
print(X.shape)

lda = LatentDirichletAllocation(n_components=4, random_state=0).fit(X)
print(*top_words(lda.components_, vocab, 8), sep='\n')
lda_label = lda.transform(X).argmax(axis=1)       # cada post vai para o seu maior tópico
print(f"ARI with the forums: {adjusted_rand_score(y, lda_label):.3f}")
(2155, 5725)
jpeg don pts like think play period gif
god space people think just jesus time like
team game hockey season games nhl play year
image edu data graphics space available software program
ARI with the forums: 0.456
O vocabulário guarda palavras de três letras ou mais que aparecem em pelo menos 5 posts e em no máximo metade deles. top_words lista as palavras mais pesadas de cada linha de components_. Hóquei sai limpo (team game hockey season nhl). Os outros três tópicos saem borrados: religião e computação gráfica dividem, cada uma, o seu tópico com space; um terceiro tópico é feito de palavras como jpeg, pts, period, gif, formatos de arquivo misturados com tabelas de placar de hóquei. Para comparar os tópicos com os fóruns, cada post vai para o seu maior tópico e o resultado é comparado aos fóruns pelo índice de Rand ajustado (1 = partições idênticas, 0 = não melhor que o acaso): 0,456.
4. Resumo: a LDA em quatro linhas
- Um tópico é uma distribuição \(\varphi_k\) sobre palavras e um documento é uma mistura \(\theta_d\) de tópicos; cada posição de palavra sorteia um tópico e depois uma palavra.
- A probabilidade de uma palavra num documento é a mistura das probabilidades dos tópicos: \(p(w \mid d) = \sum_k \theta_{d,k}\, \varphi_{k,w}\).
- A priori de Dirichlet \(\alpha\) diz quão misturado é um documento típico: \(\alpha\) pequeno, um tópico por documento; \(\alpha\) grande, tudo misturado. O padrão do scikit-learn, \(1/k\), favorece documentos concentrados.
- O ajuste roda a história de trás para a frente sobre contagens bag-of-words:
components_guarda os tópicos etransformas misturas. Leia os tópicos pelas palavras do topo e confira-os com algo que o modelo não viu.
No lab. O passo 2 ajusta a LDA em cinco outros fóruns.
Para fechar a parte fundamental. Em uma frase cada: (1) por que a LDA só precisa das contagens de palavras e não da ordem delas? (2) Com os dois tópicos da seção 1, qual das seis palavras nunca poderia aparecer num documento que é 100% espaço? (3) Como seriam os documentos de um corpus cujo \(\alpha\) fosse 10?
Sua vez (fundamental)
- Outra mistura. Rode de novo o bloco da seção 1 com \(\theta = (0{,}3;\ 0{,}7)\) e outra semente. Quais palavras ficam mais prováveis e quantas das 12 posições sorteiam o tópico espaço?
- Mais tópicos. Reajuste a LDA nos posts com
n_components=8. Os tópicos borrados se separam? O ARI com os quatro fóruns sobe ou desce? Por que ele não deve ser lido aqui como uma nota de qualidade?
Abordagem avançada
A abordagem fundamental contou a história da LDA e a rodou em posts reais, mas um tópico borrado deixa uma dúvida: o modelo está errado ou os dados são difíceis? Esta parte resolve a questão com dois experimentos. Primeiro, um corpus gerado pela própria história, cujos tópicos verdadeiros são conhecidos; depois, as onze frases escritas à mão, em que as contagens trazem pouca evidência. Ela termina com os botões que o scikit-learn oferece. Os blocos de código continuam os das seções 1 a 3.
Esta parte segue um caminho em três etapas, desenhado abaixo: 1. recuperar tópicos conhecidos; 2. palavras de menos; 3. os botões. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Recuperar tópicos conhecidosum corpus sintético, escrito pela história
- Palavras de menos53 palavras, 20 sementes
- Os botõesα, η e o ponto de partida aleatório
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
5. Ajustando a LDA: a história de trás para a frente
Etapa 1. Ajustar a LDA inverte a história: só a partir das palavras observadas, estimar os tópicos \(\varphi\) e as misturas \(\theta\). O scikit-learn faz isso com inferência variacional, uma otimização iterativa que parte de um ponto aleatório. Para ver se funciona, gere um corpus com a própria história (assim os tópicos verdadeiros são conhecidos) e peça à LDA que os encontre:
from sklearn.decomposition import LatentDirichletAllocation

vocab9 = ['team', 'goal', 'game', 'rocket', 'orbit', 'moon', 'bread', 'oven', 'bake']
phi_true = np.full((3, 9), 0.10 / 6)                      # um pouco de cada palavra...
for k in range(3):
    phi_true[k, 3 * k:3 * k + 3] = [0.35, 0.30, 0.25]     # ...e 90% nas suas três palavras
rng = np.random.default_rng(0)
theta_true = rng.dirichlet([0.3] * 3, size=300)           # 300 documentos
X_syn = np.array([rng.multinomial(30, t @ phi_true) for t in theta_true])   # 30 palavras cada

lda_syn = LatentDirichletAllocation(n_components=3, random_state=0).fit(X_syn)
phi_hat = lda_syn.components_ / lda_syn.components_.sum(axis=1, keepdims=True)
order = [int(np.argmax(phi_hat[:, 3 * k])) for k in range(3)]   # alinha os tópicos com a verdade
print(pd.DataFrame(phi_hat[order], columns=vocab9).round(2))
theta_hat = lda_syn.transform(X_syn)[:, order]
print("correlation of true and estimated theta, per topic:",
      [round(float(np.corrcoef(theta_true[:, k], theta_hat[:, k])[0, 1]), 3) for k in range(3)])
   team  goal  game  rocket  orbit  moon  bread  oven  bake
0  0.35  0.31  0.25    0.02   0.01  0.02   0.01  0.02  0.02
1  0.01  0.01  0.02    0.36   0.31  0.26   0.01  0.01  0.01
2  0.01  0.01  0.01    0.01   0.01  0.02   0.34  0.32  0.26
correlation of true and estimated theta, per topic: [0.976, 0.974, 0.973]
components_ tem uma linha por tópico; dividida pela soma, a linha é o \(\varphi_k\) estimado. Os tópicos verdadeiros põem 0,35, 0,30 e 0,25 nas suas três palavras; a LDA os recupera com erro de 0,01. As misturas também voltam: a fatia estimada de cada tópico tem correlação de 0,97 com a verdadeira. Os tópicos saem numa ordem arbitrária (o tópico "2" de uma rodada pode ser o tópico "0" de outra); por isso o código primeiro os alinha com a verdade.
6. Palavras de menos: as frases escritas à mão
Etapa 2. Aquele corpus tinha 9.000 palavras. O escrito à mão tem 53:
lda_toy = LatentDirichletAllocation(n_components=3, random_state=0).fit(X_toy)
print(top_words(lda_toy.components_, words_toy))
print(lda_toy.transform(X_toy).round(2)[[0, 3, 6, 9]])

def clean(labels):            # docs 0-2, 3-5, 6-8 cada um num tópico; três tópicos diferentes
    return all(len(set(labels[i:i + 3])) == 1 for i in (0, 3, 6)) and len(set(labels[:9])) == 3

n_clean = sum(clean(LatentDirichletAllocation(n_components=3, random_state=s)
                    .fit(X_toy).transform(X_toy).argmax(axis=1)) for s in range(20))
print("seeds with a clean split:", n_clean, "of 20")
['bread fresh game oven', 'team goal game orbit', 'rocket launch bread delayed']
[[0.06 0.88 0.06]
 [0.07 0.08 0.86]
 [0.86 0.07 0.07]
 [0.06 0.07 0.87]]
seeds with a clean split: 1 of 20
Com a semente 0, a LDA mistura os temas: bread e game dividem um tópico, orbit fica com team. Cada documento ainda é atribuído com confiança a um tópico (0,86 a 0,88), mas os tópicos não são os três temas. Em 20 sementes, só uma separa de forma limpa as nove frases de tema único. Não há nada de errado com o código: com 53 palavras, as contagens trazem pouca evidência e a otimização se acomoda onde o ponto de partida aleatório a levar. A LDA precisa de muitos documentos e de palavras suficientes em cada um; no corpus sintético ela tinha as duas coisas. A página da NMF roda nas mesmas 11 frases.
7. Os botões: duas prioris e uma semente
Etapa 3. Uma segunda Dirichlet, de parâmetro \(\eta\), faz com as palavras de cada tópico o que \(\alpha\) faz com os tópicos de cada documento: um \(\eta\) pequeno dá tópicos concentrados em poucas palavras. No scikit-learn elas são doc_topic_prior (\(\alpha\)) e topic_word_prior (\(\eta\)) de LatentDirichletAllocation, ambas \(1/k\) por padrão, o que favorece documentos e tópicos concentrados em poucos itens. Duas outras escolhas não são prioris, mas mudam o resultado tanto quanto elas: o número de tópicos \(k\), fixado de antemão (a página da NMF discute como escolhê-lo), e o ponto de partida aleatório, random_state, que a seção 6 mostrou poder decidir tudo quando a evidência é pouca.
Sua vez (avançado)
- Menos dados, mesma história. Rode de novo a seção 5 com 30 documentos em vez de 300 e depois com 5 palavras por documento em vez de 30. Quão longe da verdade ficam os \(\varphi\) estimados em cada caso? O que importa mais: muitos documentos ou documentos longos?
- Uma priori errada. Gere o corpus sintético com
rng.dirichlet([3.0] * 3, ...)(documentos misturados) e ajuste a LDA comdoc_topic_prior=0.05. A LDA ainda recupera os tópicos? E as misturas? - Sementes nos posts. Ajuste a LDA da seção 3 com
random_statede 0 a 4 e calcule o ARI entre as rodadas. A loteria das 53 palavras da seção 6 também é um problema com 2.155 posts?
Referências
- Blei, D. M.; Ng, A. Y.; Jordan, M. I. "Latent Dirichlet Allocation." JMLR 3 (2003): 993–1022 — a história generativa e a sua inferência variacional. texto completo
Quiz
O quiz revisa a abordagem fundamental desta página; o quiz da aula cobre as cinco páginas.
Próxima: E3.2 NMF, os mesmos tópicos por fatoração de matrizes.