O caminho desta parte
- Contar a históriaum tópico por posição, depois uma palavra desse tópico
- A priori de Dirichletquão misturado é um documento típico?
- Ajustar posts reais2.155 posts, palavras do topo, ARI com os fóruns
LDA: uma história de como as palavras chegaram lá
Alocação latente de Dirichlet (latent Dirichlet allocation; Blei, Ng & Jordan, 2003):
- cada tópico \(k\) é uma distribuição de probabilidade \(\varphi_k\) sobre o vocabulário;
- cada documento \(d\) tem a sua mistura de tópicos \(\theta_d\), por exemplo \((0{,}8;\ 0{,}2)\);
- para cada posição de palavra: sorteie um tópico \(z\) de \(\theta_d\) e depois uma palavra de \(\varphi_z\).
\(\theta_{d,k}\): fatia do tópico \(k\) no documento \(d\) · \(\varphi_{k,w}\): probabilidade da palavra \(w\) no tópico \(k\). A ordem das palavras não entra: contagens bag-of-words bastam.
A história à mão
Preveja. Num documento que é 80% esportes, o que é mais provável, team ou rocket, e por quanto?
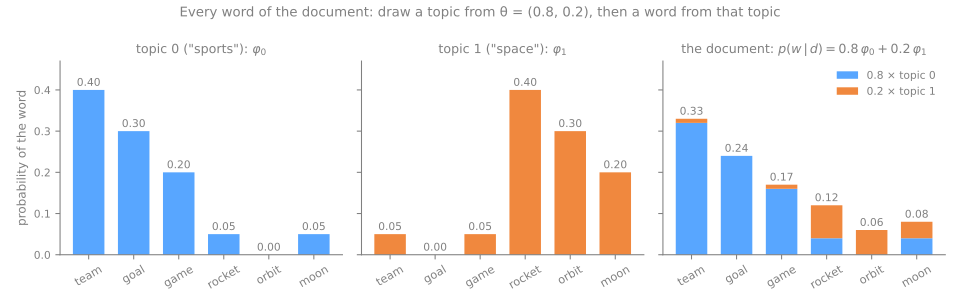
\(\theta = (0{,}8;\ 0{,}2)\): 80% esportes, 20% espaço.
\(p(\textit{team}) = 0{,}8 \times 0{,}40 + 0{,}2 \times 0{,}05 = 0{,}33\)
\(p(\textit{rocket}) = 0{,}8 \times 0{,}05 + 0{,}2 \times 0{,}40 = 0{,}12\)
Seguindo a história, 4 das 12 posições sortearam o tópico espaço, exatamente onde aparecem moon, orbit, rocket, orbit.
A priori de Dirichlet: quão misturado é um documento?
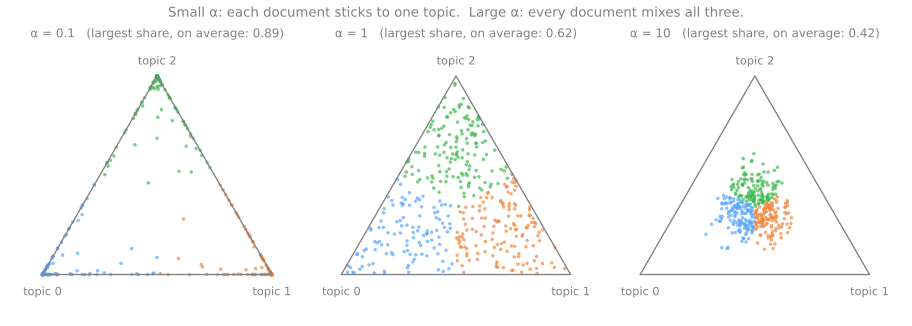
| \(\alpha\) | maior fatia |
|---|---|
| 0,1 | 0,89 |
| 1 | 0,62 |
| 10 | 0,42 |
\(\theta_d\) é sorteado de uma Dirichlet de parâmetro \(\alpha\). No scikit-learn, doc_topic_prior, \(1/k\) por padrão: documentos concentrados em poucos tópicos.
Simulador: escreva um documento do jeito da LDA
Preveja. Com \(\alpha = 0{,}1\), os documentos sorteados saem de uma cor só ou das três?
Da história ao scikit-learn
lda = LatentDirichletAllocation(
        n_components=4, random_state=0).fit(X)
phi = lda.components_     # uma linha por tópico
theta = lda.transform(X)  # uma linha por documento
label = theta.argmax(axis=1)
X: contagens bag-of-words, documentos × palavras.- Uma linha de
components_, dividida pela soma, é um \(\varphi_k\) estimado. - Uma linha de
transformé o \(\theta_d\) do documento.
A LDA em 2.155 posts reais
Quatro fóruns do 20 Newsgroups (computação gráfica, hóquei, espaço, religião); 5.725 palavras de 3 ou mais letras, em pelo menos 5 posts e no máximo em metade deles. Preveja: que fórum sai mais limpo?
| jpeg don pts like think play period gif |
| god space people think just jesus time like |
| team game hockey season games nhl play year |
| image edu data graphics space available software program |
Resumo
- Um tópico é uma distribuição \(\varphi_k\) sobre palavras; um documento, uma mistura \(\theta_d\) de tópicos.
- \(p(w \mid d) = \sum_k \theta_{d,k}\, \varphi_{k,w}\): as probabilidades dos tópicos, misturadas.
- \(\alpha\) pequeno: um tópico por documento; \(\alpha\) grande: tudo misturado.
- O ajuste roda a história de trás para a frente nas contagens:
components_guarda os tópicos etransformas misturas.
Para fechar a parte fundamental
- Por que a LDA só precisa das contagens de palavras e não da ordem delas?
- Qual das seis palavras nunca poderia aparecer num documento que é 100% espaço?
- Como seriam os documentos de um corpus com \(\alpha = 10\)?
No lab: o passo 2 ajusta a LDA em cinco outros fóruns (página de visão geral). A seguir: os slides fundamentais da E3.2 NMF.