U5.2 NMF
A NMF (non-negative matrix factorization, fatoração de matrizes não negativa) lê a mesma primeira resposta com álgebra linear em vez de probabilidade: um tópico é uma linha de pesos não negativos sobre as palavras e um documento é uma soma de tópicos. Esta página a constrói nas frases escritas à mão, compara-a com a SVD para mostrar por que a restrição de sinal importa e a roda nos posts. Ela termina com a pergunta que a LDA e a NMF deixam em aberto: quantos tópicos? E eles são bons?
- O que é um tópico?palavras que andam juntas ou documentos que andam juntos
- LDAalocação latente de Dirichlet: uma história de como as palavras são escritas
- NMFfatoração de matrizes não negativas: um documento como soma de partes
- BERTopicembeddings, redução, agrupamento, descrição
- Comparar e escolheros três lado a lado; as armadilhas
Preparação: o que esta página usa das anteriores
Esta página continua a U5.1 LDA. Se você começar por aqui, rode este bloco antes: ele reconstrói os dois corpora, as funções auxiliares e a LDA ajustada nos posts.
import numpy as np
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer

docs_toy = [
    "the team won the game with a late goal",                 # esportes
    "fans cheered when the team scored a goal",
    "the coach said the game was a fair win for the team",
    "the rocket launch put a satellite in orbit",             # espaço
    "nasa delayed the rocket launch to the moon",
    "the satellite reached orbit around the moon",
    "bake the bread in a hot oven",                           # culinária
    "knead the dough and bake the bread slowly",
    "fresh bread from the oven smells great",
    "the team watched the rocket launch before the game",     # esportes + espaço
    "astronauts ate fresh bread on the moon",                 # espaço + culinária
]

from sklearn.decomposition import LatentDirichletAllocation

def top_words(components, vocab, n=4):
    return [' '.join(vocab[row.argsort()[::-1][:n]]) for row in components]

def clean(labels):            # docs 0-2, 3-5, 6-8 cada um num tópico; três tópicos diferentes
    return all(len(set(labels[i:i + 3])) == 1 for i in (0, 3, 6)) and len(set(labels[:9])) == 3

from sklearn.datasets import fetch_20newsgroups

forums = ['comp.graphics', 'rec.sport.hockey', 'sci.space', 'soc.religion.christian']
ng = fetch_20newsgroups(subset='train', categories=forums, random_state=0,
                        remove=('headers', 'footers', 'quotes'))   # só o corpo do texto
long_enough = np.array([len(text.split()) >= 20 for text in ng.data])
docs = [text for text, keep in zip(ng.data, long_enough) if keep]
y = ng.target[long_enough]                                         # o fórum: usado só para conferir

from sklearn.metrics import adjusted_rand_score

settings = dict(stop_words='english', min_df=5, max_df=0.5,
                token_pattern=r'(?u)\b[a-zA-Z]{3,}\b')             # palavras de 3+ letras, sem números
cv = CountVectorizer(**settings)
X = cv.fit_transform(docs)
vocab = cv.get_feature_names_out()

lda = LatentDirichletAllocation(n_components=4, random_state=0).fit(X)
X ≈ W H, sem nada negativo
Etapa 3. A fatoração de matrizes não negativas (Lee & Seung, 1999) segue o caminho da álgebra linear. Escreva a matriz documentos × palavras \(X\) (aqui, TF-IDF) como o produto de duas matrizes menores:
Cada linha de \(H\) é um tópico: um peso para cada palavra. Cada linha de \(W\) diz quanto de cada tópico um documento contém. É o mesmo formato da fatoração da PCA; a única diferença é a restrição de que toda entrada seja \(\ge 0\). A NMF encontra \(W\) e \(H\) minimizando \(\lVert X - WH \rVert^2\) sob essa restrição.
from sklearn.decomposition import NMF
from sklearn.feature_extraction.text import TfidfVectorizer

tv_toy = TfidfVectorizer(stop_words='english')
T_toy = tv_toy.fit_transform(docs_toy)
nmf_toy = NMF(n_components=3, init='nndsvda', max_iter=1000, random_state=0).fit(T_toy)
W_toy, H_toy = nmf_toy.transform(T_toy), nmf_toy.components_
print(top_words(H_toy, tv_toy.get_feature_names_out()))
print(pd.DataFrame(W_toy, columns=['topic 0', 'topic 1', 'topic 2']).round(2))
print("clean split:", clean(W_toy.argmax(axis=1)))
['launch rocket satellite orbit', 'bread oven bake fresh', 'team game goal won']
    topic 0  topic 1  topic 2
0      0.00     0.00     0.71
1      0.00     0.00     0.54
2      0.00     0.00     0.56
3      0.62     0.00     0.00
4      0.47     0.01     0.00
5      0.48     0.01     0.00
6      0.00     0.57     0.00
7      0.00     0.44     0.00
8      0.00     0.54     0.00
9      0.29     0.00     0.45
10     0.10     0.41     0.00
clean split: True
Nas mesmas 11 frases em que a LDA falhou 19 vezes em 20, a NMF encontra os três temas: espaço, culinária, esportes. \(W\) se lê como a história a partir da qual as frases foram escritas. As frases de tema único têm um só peso claramente diferente de zero; "the team watched the rocket launch before the game" é 0,45 esportes e 0,29 espaço; "astronauts ate fresh bread on the moon" é quase toda culinária, com um pouco de espaço. Os pesos não são probabilidades (uma linha não soma 1), mas são fáceis de ler. init='nndsvda' parte de uma SVD da matriz em vez de um ponto aleatório, o que é uma das razões de o resultado ser estável.
Por que não negativa? Uma comparação com a SVD
Tire a restrição e você obtém a TruncatedSVD, a PCA das matrizes esparsas:
from sklearn.decomposition import TruncatedSVD

svd_toy = TruncatedSVD(n_components=3, random_state=0).fit(T_toy)
print("negative entries in the 3 x 33 topic-word matrix:  SVD", (svd_toy.components_ < -1e-9).sum(),
      "| NMF", (H_toy < 0).sum())
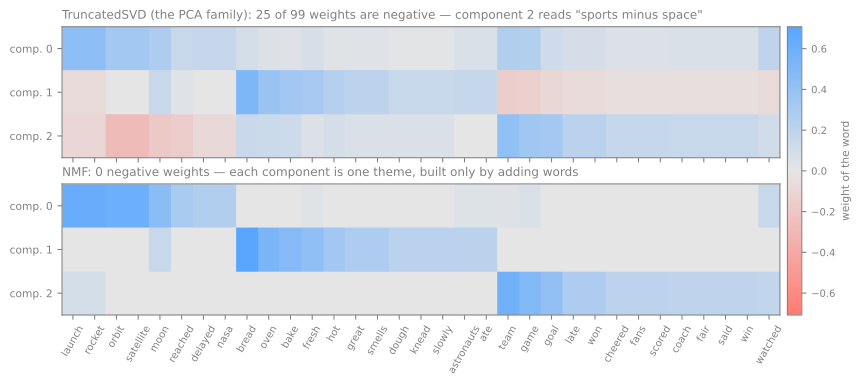
As componentes da SVD têm 25 pesos negativos. A componente 2 se lê "palavras de esportes menos palavras de espaço": uma direção que separa bem dois temas e descreve mal os dois. A NMF só consegue montar um documento somando partes, então cada parte acaba sendo um tema inteiro; é a representação "por partes" do artigo de Lee & Seung, em que a NMF aprendeu narizes e olhos a partir de imagens de rostos enquanto a PCA aprendia "eigenfaces" com sinais positivos e negativos (script da figura).
Abaixo, a mesma comparação é calculada ao vivo no seu navegador. A NMF começa de pesos positivos aleatórios: aperte passo algumas vezes e veja as linhas virarem temas enquanto o erro cai em direção ao da SVD; depois mude o \(k\).
A linha tracejada é o erro da SVD truncada, o menor que um produto de posto \(k\) pode alcançar; a NMF fica um pouco acima dele. Esse pequeno preço compra linhas que são temas inteiros, nunca "esportes menos espaço".
NMF nos posts
tv = TfidfVectorizer(**settings)
T = tv.fit_transform(docs)                                  # mesmo vocabulário de X, pesos TF-IDF
nmf = NMF(n_components=4, init='nndsvda', max_iter=500, random_state=0).fit(T)
print(*top_words(nmf.components_, vocab, 8), sep='\n')
nmf_label = nmf.transform(T).argmax(axis=1)
print(f"ARI with the forums: {adjusted_rand_score(y, nmf_label):.3f}")
graphics thanks files image program file know windows
god jesus people believe christ faith bible christians
game team hockey players play games season nhl
space nasa launch shuttle moon orbit lunar earth
ARI with the forums: 0.767
Os quatro tópicos da NMF são os quatro fóruns: computação gráfica, religião, hóquei, espaço, sem nada da mistura que a LDA mostrou. A concordância com os fóruns sobe de 0,456 para 0,767. É uma rodada em um corpus: o lab encontra um corpus em que a ordem se inverte. A próxima seção compara os dois com mais cuidado.
Quantos tópicos? E eles são bons?
A LDA e a NMF precisam do número de tópicos \(k\) de antemão. Não há rótulos para validar a escolha, então a escolha precisa de uma pontuação calculada só a partir dos documentos. Duas famílias de pontuações são comuns.
A perplexidade pergunta quão bem o modelo prevê palavras que não viu: ajuste a LDA em 80% dos posts e meça quão surpreso ele fica com os outros 20%. Menor é melhor. É a própria verossimilhança da LDA, então só existe para modelos probabilísticos.
A coerência pergunta se as palavras do topo de um tópico andam juntas. As medidas mais comuns se baseiam em quão frequentemente as palavras coocorrem nos documentos (Röder, Both & Hinneburg, 2015, comparam dezenas delas com julgamentos humanos). A mais simples de calcular à mão é a informação mútua pontual normalizada (NPMI) de duas palavras:
em que \(P(w)\) é a fração dos documentos que contêm \(w\). Ela vale 0 quando as duas palavras são independentes, 1 quando sempre aparecem juntas e \(-1\) quando nunca aparecem. À mão, para god e jesus nos posts:
B = CountVectorizer(stop_words='english', token_pattern=r'(?u)\b[a-zA-Z]{3,}\b',
                    binary=True).fit(docs)                 # referência: qual post contém qual palavra
Xb = B.transform(docs).tocsc()
col = B.vocabulary_
D = Xb.shape[0]

def n_docs(*ws):                                           # número de posts que contêm todas as palavras
    hit = np.ones(D, dtype=bool)
    for w in ws:
        hit &= Xb[:, col[w]].toarray().ravel() > 0
    return int(hit.sum())

n_i, n_j, n_ij = n_docs('god'), n_docs('jesus'), n_docs('god', 'jesus')
p_i, p_j, p_ij = n_i / D, n_j / D, n_ij / D
print(D, n_i, n_j, n_ij)
print(f"PMI = {np.log(p_ij / (p_i * p_j)):.3f}   NPMI = {np.log(p_ij / (p_i * p_j)) / -np.log(p_ij):.3f}")
Dos 2.155 posts, 304 contêm god, 159 contêm jesus e 101 contêm as duas. Se as palavras fossem independentes, as duas apareceriam juntas em \(0{,}141 \times 0{,}074 = 1{,}04\%\) dos posts; elas aparecem juntas em \(101/2155 = 4{,}69\%\), 4,5 vezes mais. \(\log 4{,}5 = 1{,}505\), dividido por \(-\log 0{,}0469 = 3{,}06\), dá uma NPMI de 0,492. A coerência de um tópico é a NPMI média sobre todos os pares das suas 10 palavras do topo; a coerência de um modelo é a média sobre os tópicos. Uma segunda pontuação, mais simples, a diversidade de tópicos (Dieng, Ruiz & Blei, 2020), é a fração de palavras distintas entre as palavras do topo de todos os tópicos: 1,0 quando dois tópicos nunca compartilham uma palavra do topo.
from itertools import combinations

def npmi(w1, w2):
    p1, p2, p12 = n_docs(w1) / D, n_docs(w2) / D, n_docs(w1, w2) / D
    return -1.0 if p12 == 0 else np.log(p12 / (p1 * p2)) / -np.log(p12)

def coherence(topics, n=10):           # NPMI média nos pares das top-n palavras de cada tópico
    return np.mean([np.mean([npmi(a, b) for a, b in combinations(t.split()[:n], 2)])
                    for t in topics])

def diversity(topics, n=10):           # fração de palavras distintas nas top-n de todos os tópicos
    ws = [w for t in topics for w in t.split()[:n]]
    return len(set(ws)) / len(ws)

for name, comp in [('LDA', lda.components_), ('NMF', nmf.components_)]:
    tops = top_words(comp, vocab, 10)
    print(f"{name}  coherence (NPMI) {coherence(tops):.3f}   diversity {diversity(tops):.2f}")
As duas pontuações concordam com o que vimos a olho: os tópicos da NMF são mais coerentes (0,369 contra 0,224) e não compartilham nenhuma palavra do topo, enquanto a LDA repete palavras como space, like e think entre tópicos. Agora a questão do \(k\). A figura calcula as duas pontuações para \(k\) de 2 a 20, com três sementes por ponto (script da figura):
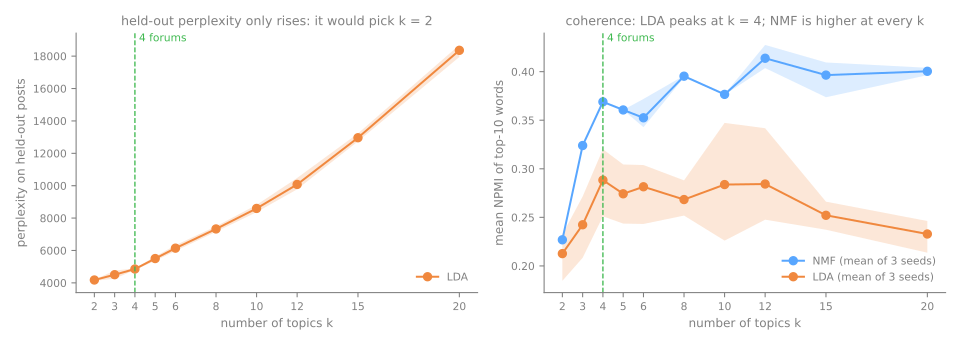
- A perplexidade em dados separados só sobe. Lida ao pé da letra, recomenda \(k = 2\). Esse comportamento da perplexidade do scikit-learn é conhecido. Um problema maior é que, mesmo quando a perplexidade se comporta bem, ela não acompanha o que as pessoas acham interpretável: Chang et al. (2009) viram que modelos com perplexidade melhor muitas vezes tinham tópicos que humanos julgavam piores.
- A coerência tem pico para a LDA em \(k = 4\), o número de fóruns, embora a faixa de variação entre sementes seja quase tão larga quanto a curva inteira. A coerência da NMF sobe até \(k = 4\) e depois fica num platô: dali em diante, a NMF divide os fóruns em subtemas igualmente coerentes.
A regra prática: varra uma faixa de \(k\), procure na curva de coerência um cotovelo em vez de um máximo; depois, leia os tópicos em dois ou três valores candidatos. O número de tópicos é uma escolha de granularidade (quatro fóruns ou doze subtemas?): nenhuma pontuação faz essa escolha por você.
Referências
- Lee, D. D.; Seung, H. S. "Learning the Parts of Objects by Non-negative Matrix Factorization." Nature 401 (1999): 788–791 — a NMF e as representações por partes. DOI
- Röder, M.; Both, A.; Hinneburg, A. "Exploring the Space of Topic Coherence Measures." WSDM (2015): 399–408 — medidas de coerência comparadas com julgamentos humanos. DOI
- Chang, J.; Boyd-Graber, J.; Gerrish, S.; Wang, C.; Blei, D. M. "Reading Tea Leaves: How Humans Interpret Topic Models." NeurIPS 22 (2009) — perplexidade melhor não quer dizer tópicos mais interpretáveis.
- Dieng, A. B.; Ruiz, F. J. R.; Blei, D. M. "Topic Modeling in Embedding Spaces." TACL 8 (2020): 439–453 — de onde vem a pontuação de diversidade de tópicos. DOI
Próxima: U5.3 BERTopic, tópicos como grupos de documentos.