Validação Cruzada e Vazamento de Dados
Nas últimas aulas, toda escolha foi feita do mesmo jeito. O k dos k vizinhos mais próximos (k-NN, do inglês k-nearest neighbors), o limiar de decisão e o class_weight da aula de curvas ROC (receiver operating characteristic) e PR (precisão–recall) para dados desbalanceados: separar um conjunto de validação dos dados de treino, testar as opções nele e ficar com a melhor. Esta aula mostra que um único split é uma loteria (a resposta depende de quais linhas caíram nele) e o substitui pela validação cruzada (CV, do inglês cross-validation). Depois, transforma a regra de ouro — nunca avaliar em dados de treino — em prática de engenharia: como detectar o vazamento de dados e como comparar modelos sem se enganar.
Toda afirmação abaixo é medida, não apenas enunciada: cada figura é produzida por um script Python curto que fica ao lado desta página; os blocos de código reproduzem os números citados no texto.
Como esta aula está organizada
A aula tem duas abordagens. Cada uma tem slides, texto e um lab para fazer em aula no Colab; o quiz do fim cobre a fundamental. Comece pela fundamental: a avançada parte dela.
| Abordagem fundamental | Abordagem avançada | |
|---|---|---|
| pergunta | Como medir o desempenho de uma receita sem depender da sorte de uma divisão? | Como não se enganar: vazamento, comparações injustas e a maldição do vencedor |
| conteúdo | treino/validação/teste, por que um split é uma loteria, k-fold, esquemas de CV, pré-processamento por fold | os cinco padrões de vazamento, comparação pareada, regra do empate, CV aninhada, reamostragem nos folds |
| lab em aula | câncer de mama: a CV em ação, passos 1 a 6 | comparar, verificar e testar, passos 7 a 13 |
| ao final, você sabe | montar treino/validação/teste; rodar k-fold e ler média ± desvio; escolher o esquema de CV certo; ajustar um hiperparâmetro com busca em grade | reconhecer os cinco vazamentos e medi-los; comparar candidatos fold a fold; declarar empates; saber quanto o próprio ajuste infla o número |
Os dois labs usam o mesmo notebook no Colab: a parte fundamental vai do passo 1 ao 6; a avançada, do 7 ao 13. Tudo roda no navegador; não é preciso baixar nada.
Abordagem fundamental
Uma pergunta guia esta parte: como medir o desempenho de uma receita sem depender da sorte de uma divisão? A resposta é trocar um conjunto de validação por \(k\) deles e reportar média ± desvio.
Esta parte segue um pipeline em quatro etapas, desenhado abaixo: 1. três conjuntos, os papéis de treino, validação e teste; 2. um split → k folds, a validação cruzada contra a sorte de um split; 3. folds honestos, o divisor certo e o pré-processamento reajustado em cada fold; 4. a receita honesta, posta em prática no lab. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Três conjuntostreino, validação, teste; por que a validação se desgasta
- Um split → k foldsa loteria de um split, k-fold, média ± desvio
- Folds honestoso divisor certo, pré-processamento reajustado em cada fold
- A receita honestacinco regras, depois o lab: ajustar C com busca em grade
Slides da abordagem fundamental
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
1. Treino / validação / teste
Etapa 1. Antes de qualquer modelo, decida que dados podem julgá-lo: três conjuntos, três papéis.
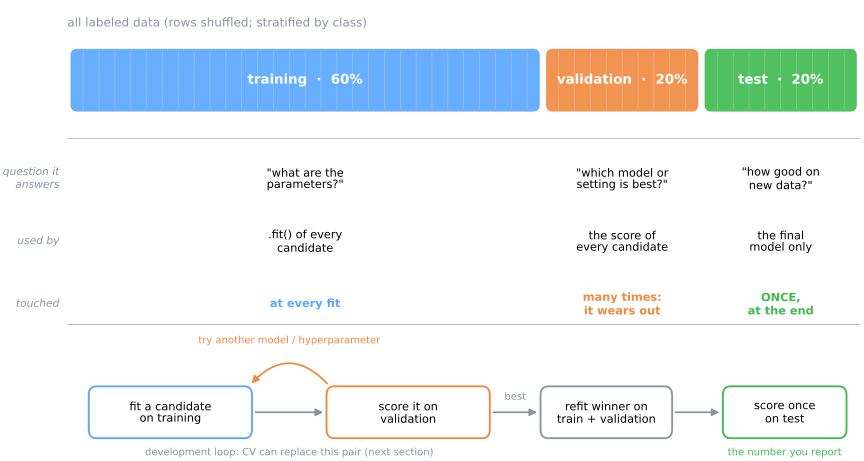
- Conjunto de treino — o modelo aprende seus parâmetros aqui;
- Conjunto de validação — usado para escolher entre modelos e valores de hiperparâmetros. Como você toma decisões nele, o desempenho nele se torna otimisticamente enviesado com o tempo;
- Conjunto de teste — simula o futuro. Usado uma vez, no fim de tudo. Se você itera contra o conjunto de teste, ele silenciosamente vira um conjunto de validação e você deixa de ter uma estimativa honesta.
A linha de baixo é o fluxo de trabalho. O laço de desenvolvimento — ajustar no treino, avaliar na validação, tentar outra coisa — roda quantas vezes você quiser; é justamente essa repetição que desgasta o conjunto de validação. Escolhido o vencedor, ele costuma ser reajustado em treino + validação (mais dados, mesma receita); só então entra em cena o conjunto de teste, uma única vez (script da figura). Em código:
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split

X, y = load_breast_cancer(return_X_y=True)                      # qualquer tabela de atributos e rótulos
X_temp, X_test, y_temp, y_test = train_test_split(X, y, test_size=0.2, random_state=42,
                                                  stratify=y)   # mantém as proporções de classe
X_train, X_val, y_train, y_val = train_test_split(X_temp, y_temp, test_size=0.25,
                                                  random_state=42, stratify=y_temp)
print(len(X_train), len(X_val), len(X_test))
O resultado é uma divisão 60/20/20: test_size=0.25 dos 80% restantes é 20% do total. stratify=y preserva as proporções de classe em cada divisão — importante para classificação desbalanceada (ver ROC, PR e Dados Desbalanceados).
Por que um conjunto em que você escolhe deixa de ser honesto
"O desempenho na validação se torna otimisticamente enviesado" soa abstrato. É mais fácil de ver onde não há nada a encontrar. Tome um conjunto de puro ruído — 20 colunas aleatórias e um alvo no cara ou coroa —, de modo que nenhum modelo consiga de fato passar de 50%. Divida em 50/25/25, treine 100 árvores de decisão com hiperparâmetros aleatórios (as árvores chegam na aula de árvores de decisão; qualquer modelo com botões serviria) e faça o que todo mundo faz: fique com a de melhor escore na validação.
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

rng = np.random.default_rng(0)
X, y = rng.normal(size=(400, 20)), rng.integers(0, 2, 400)       # nenhum sinal
X_tmp, X_te, y_tmp, y_te = train_test_split(X, y, test_size=0.25, random_state=0)
X_tr, X_va, y_tr, y_va = train_test_split(X_tmp, y_tmp, test_size=1/3, random_state=0)

results = []
for k in range(100):                                             # 100 "configurações"
    m = DecisionTreeClassifier(max_depth=int(rng.integers(1, 8)),
                               max_features=int(rng.integers(1, 21)),
                               random_state=k).fit(X_tr, y_tr)
    results.append((m.score(X_va, y_va), m.score(X_te, y_te)))

best_val, its_test = max(results, key=lambda r: r[0])           # escolhe pela validação
print(f"vencedor na validação: {best_val:.1%}   mesmo modelo no teste: {its_test:.1%}")
Repetindo o experimento 30 vezes e tirando a média, obtém-se a figura abaixo (script):
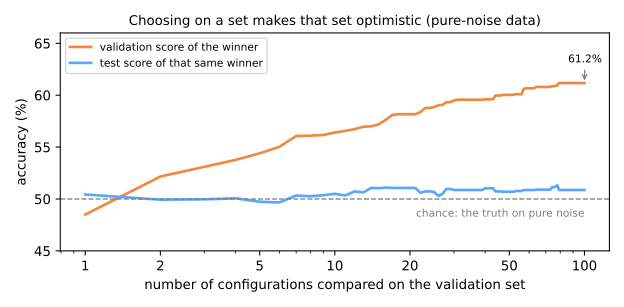
Com uma única configuração, validação e teste concordam: ambos rondam 50%. À medida que você compara mais, o escore de validação do vencedor sobe a 61,2%, enquanto o mesmo vencedor, medido em dados intocados, fica em 50,9%. Nenhum modelo melhorou. Você apenas escolheu aquele que por acaso concordou com as peculiaridades aleatórias daquelas 100 linhas de validação; quanto mais candidatos, maior a peculiaridade sortuda que você encontra. É a maldição do vencedor (winner's curse), razão de ser das regras acima:
- o escore do modelo escolhido, no conjunto usado para escolhê-lo, é enviesado para cima — por uma quantia que cresce com o número de coisas que você testou;
- só se pode citar o escore de um conjunto que não participou de decisão nenhuma. Esse é o conjunto de teste, que só permanece honesto enquanto você não decide nada com ele.
Em dados reais a diferença é menor, porque o sinal verdadeiro domina as peculiaridades sortudas, mas, em média, ela aponta para o mesmo lado.
2. Validação cruzada
Um único split é uma loteria
Etapa 2. Um único split de validação tem um segundo problema, independente do primeiro: o resultado depende de quais linhas caíram nele. Mantenha tudo fixo — o conjunto de câncer de mama (569 linhas), uma regressão logística com escalonamento — e mude só o random_state de uma divisão 80/20:
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score, train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_breast_cancer(return_X_y=True)
pipe = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))

for seed in [0, 1, 2, 3, 4]:
    X_tr, X_va, y_tr, y_va = train_test_split(X, y, test_size=0.2, random_state=seed, stratify=y)
    print(seed, f"{pipe.fit(X_tr, y_tr).score(X_va, y_va):.3f}")
Fazendo isso para 300 sementes (script):
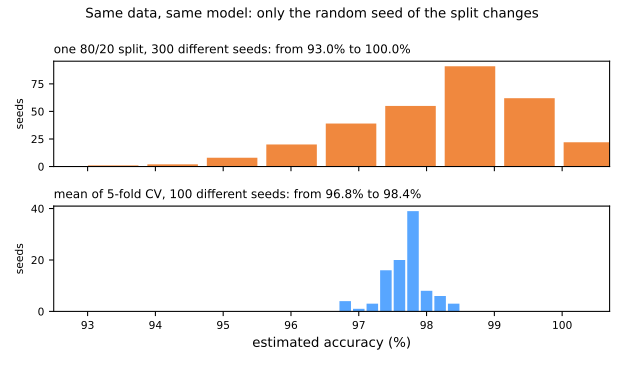
O mesmo modelo, nos mesmos dados, "tira" qualquer nota de 93,0% a 100,0%, com desvio-padrão de 1,3 ponto. Um aluno que reporta 100% e outro que reporta 93% podem ter escrito código idêntico. Com 114 linhas de validação, cada linha vale 0,88 ponto de acurácia, então basta um punhado de casos difíceis cair de um lado ou de outro para mudar o resultado.
O painel de baixo é a correção: a média de uma validação cruzada 5-fold, em 100 embaralhamentos diferentes, fica entre 96,8% e 98,4% (desvio-padrão de 0,34 — quatro vezes menor). As duas estimativas se centram no mesmo valor; a validação cruzada não é mais otimista, apenas muito menos refém da sorte.
O simulador abaixo roda o mesmo experimento num conjunto de duas classes cuja acurácia verdadeira conhecemos (78%, medida em 20 000 pontos novos). Com \(n = 80\) linhas (o controle n é o número de linhas), aperte Sortear 100: o hold-out cai em qualquer lugar entre uns 60% e 100%, enquanto a média da CV fica numa faixa de poucos pontos. Depois aperte Novo conjunto algumas vezes.
O segundo experimento mostra o que a validação cruzada não corrige. Com \(n = 80\), a faixa azul estreita fica em 80,0–87,5% para um conjunto e em 72,5–78,8% para o seguinte — às vezes longe da linha branca. A CV reduz muito a sorte da divisão; não consegue remover a sorte da amostra, porque todos os folds saem das mesmas 80 linhas. Um conjunto pequeno que por acaso é fácil parece fácil sob qualquer esquema de validação. Só mais dados ajudam: leve o controle a 600 e a faixa da CV encolhe para uns 2 pontos, perto da verdade, enquanto um único hold-out ainda se espalha por uns 20. Por isso a média ± desvio da CV deve ser lida como "o desempenho desta receita em dados como os meus" — e o "como os meus" pesa de verdade quando \(n\) é pequeno.
k-fold, passo a passo
Validação cruzada k-fold (tipicamente \(k = 5\) ou \(10\)):
- particione os dados de treino em \(k\) folds;
- para cada fold: treine nos outros \(k-1\) e avalie nele;
- reporte a média (e o desvio-padrão!) dos \(k\) escores.
from sklearn.model_selection import cross_val_score, StratifiedKFold, train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42,
                                                    stratify=y)   # a CV substitui o conjunto de validação
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(pipe, X_train, y_train, cv=cv, scoring='f1')
print(scores.round(3))
print(f"{scores.mean():.3f} ± {scores.std():.3f}")
Toda observação serve de validação exatamente uma vez e o modelo é avaliado em todas as linhas em vez de 20% delas — é daí que vem a redução de variância. O preço são \(k\) ajustes em vez de um. A dispersão dos \(k\) escores também é informação: se os folds dão 0,97, 0,96, 0,98, 0,71, 0,97, a média esconde um modelo que falha feio em algum subconjunto dos dados; aquele fold merece uma olhada.
Os \(k\) modelos são descartados depois. A CV avalia uma receita (algoritmo + hiperparâmetros + pré-processamento); o modelo que vai para produção é essa receita reajustada uma vez em todos os dados de treino.
Escolhendo um esquema de CV
Etapa 3. Os divisores diferem apenas em quais linhas podem cair juntas num fold de validação. A figura torna isso concreto. Considere 60 linhas dispostas como costumam estar num arquivo real — ordenadas por classe (as 12 positivas no fim) e por paciente (12 pacientes de tamanhos diferentes, um bloco cada na faixa roxa) — e os cinco folds que cada divisor produz (script):
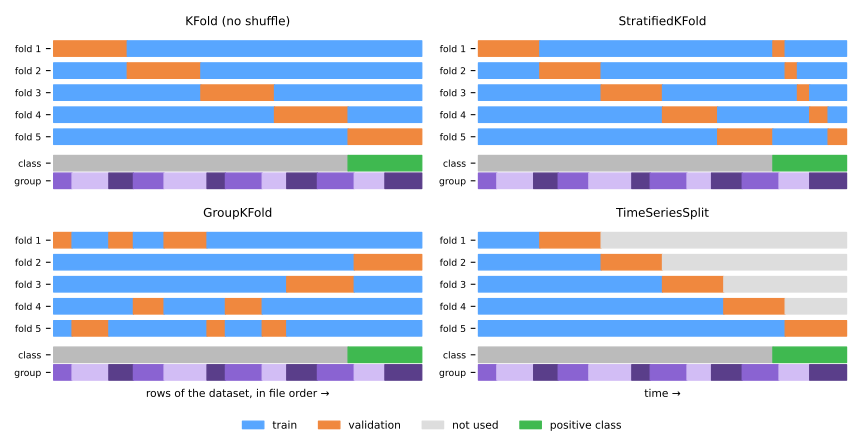
- KFold sem embaralhar corta o arquivo em blocos consecutivos. Como o arquivo está ordenado, o fold 5 valida em todas as positivas e os folds 1–4 em nenhuma — quatro folds em que o recall é indefinido. Passe sempre
shuffle=True, a menos que a ordem tenha significado (tempo); - StratifiedKFold leva a mesma fração de cada classe para cada fold: todo fold de validação recebe 2–3 positivas;
- GroupKFold nunca divide um paciente: cada bloco roxo cai inteiro num único fold de validação, então o modelo é sempre avaliado em pacientes que nunca viu;
- TimeSeriesSplit só valida no futuro da sua janela de treino; a janela cresce e a parte cinza (o futuro do futuro) não é usada.
Embaralhar não basta para tornar o KFold seguro em dados desbalanceados. Com 100 linhas e 8 positivas:
import numpy as np
from sklearn.model_selection import KFold, StratifiedKFold

y = np.array([1] * 8 + [0] * 92); X = np.zeros((100, 1))
for name, cv in [('KFold', KFold(5)),
                 ('KFold shuffled', KFold(5, shuffle=True, random_state=0)),
                 ('StratifiedKFold', StratifiedKFold(5, shuffle=True, random_state=0))]:
    print(f"{name:16s}", [int(y[va].sum()) for _, va in cv.split(X, y)])
Positivas por fold de validação. Em 1 000 sementes, o KFold embaralhado deixou pelo menos um fold sem nenhuma positiva em 65% das vezes. A estratificação garante 1 ou 2 em todo fold.
| Método | Quando usar | Vantagens | Cuidado com |
|---|---|---|---|
| K-Fold | regressão, dados balanceados (com shuffle=True) | simples, eficiente | folds podem ficar sem nenhuma linha de uma classe rara |
| Stratified K-Fold | classificação (especialmente desbalanceada) | mantém as proporções de classe em cada fold | só estratifica pelo alvo |
| Leave-One-Out (LOO) | conjuntos muito pequenos (< 100–200 amostras) | usa quase todos os dados para treinar | muito lento (\(n\) ajustes, um por linha); cada fold avalia uma única linha (acerto ou erro), então o desvio por fold não significa nada e recall ou a área sob a curva ROC (AUC) não podem ser calculados por fold: junte as previsões com cross_val_predict |
| TimeSeriesSplit | dados temporais / séries temporais | respeita a ordem cronológica | os primeiros folds treinam com poucos dados; use gap quando o alvo olha para a frente |
| Group K-Fold | dados agrupados (pacientes, usuários, ...) | evita vazamento entre linhas relacionadas | exige uma coluna de grupo |
O padrão do scikit-learn quando você escreve cv=5 é StratifiedKFold para classificadores e KFold sem embaralhar nos demais casos. O conjunto de teste fica fora de todo o procedimento: a validação cruzada substitui o conjunto de validação, não o de teste.
O pré-processamento precisa reiniciar em cada fold
Escalonamento, codificação, imputação e seleção de atributos precisam ser reajustados do zero dentro de cada fold. Se você faz StandardScaler().fit_transform() ou SelectKBest().fit() no conjunto inteiro antes do cross_val_score/GridSearchCV, as estatísticas do fold de validação vazam para o treino. Para um passo que olha o y (seleção de atributos, target encoding) o escore sai otimista, às vezes muito; para um que não olha (um scaler, um imputador pela média) o erro costuma ser pequeno e pode ir para qualquer lado (Moscovich & Rosset, 2022), mas você só conhece o tamanho medindo. Passar um Pipeline torna isso automático: em cada fold, todos os passos são ajustados apenas na porção de treino daquele fold e depois aplicados congelados à porção de validação. Cada fold recebe seu próprio scaler, seus próprios atributos selecionados e seu próprio modelo. O tamanho do erro resultante é medido na abordagem avançada.
Ideia-chave
A validação cruzada avalia uma receita, não um modelo: algoritmo + hiperparâmetros + pré-processamento. Os \(k\) modelos ajustados são descartados; o que vai para produção é a mesma receita reajustada uma vez em todos os dados de treino.
3. Resumo: a receita da validação honesta
Etapa 4. Tudo o que veio acima, como uma receita a seguir, depois posta em prática no lab:
- Tranque o conjunto de teste antes de qualquer coisa, com
stratifyse for classificação. - Troque o split de validação pela CV:
StratifiedKFold(5, shuffle=True, random_state=...)para classificação. - Monte cada candidato como um
Pipeline, com todo passo ajustado dentro, para que a CV o reajuste em cada fold. - Reporte média ± desvio, nunca só a média, e olhe os folds individuais antes de confiar na média.
- Reuse um único objeto
cvem todos os candidatos, para que a comparação seja pareada.
| erro comum | sintoma | correção |
|---|---|---|
KFold sem embaralhar num arquivo ordenado | folds sem nenhuma linha de uma classe | shuffle=True ou StratifiedKFold |
escalonar ou selecionar antes do cross_val_score | um escore errado, sem aviso; otimista se o passo olha o y | o passo dentro do Pipeline |
| citar só a média dos folds | "0,95" esconde se é ± 0,005 ou ± 0,05 | sempre média ± desvio |
| iterar contra o conjunto de teste | ele vira um conjunto de validação | decidir na CV, tocar o teste uma vez |
Lab fundamental — a CV em ação
Um experimento completo, da tabela crua até um único número honesto, usando tudo o que foi visto acima. O cenário: uma ferramenta de triagem que marca tumores de mama como malignos a partir de 30 medidas de uma imagem de biópsia. Deixar passar um câncer é muito pior do que um alarme falso, então a métrica que importa é o recall da classe maligna, com a área sob a curva ROC (ROC AUC) ao lado. Duas famílias competem: a regressão logística (com a força de regularização C e o class_weight) e o k-NN (com n_neighbors e weights). Os passos 3 a 6 fazem a validação cruzada da regressão logística e ajustam o C dela; os passos 7 a 13 ficam no lab avançado.
Como fazer este lab em aula (cerca de 35 min, em duplas)
- Abra o notebook do lab no Colab. Não é preciso baixar nem instalar nada: o Colab roda no navegador. Para guardar as suas respostas, salve uma cópia no seu Drive (Arquivo → Salvar uma cópia no Drive) antes de editar. Rode as células em ordem, numa mesma sessão.
- Este lab corresponde aos passos 1 a 6 do notebook. O lab avançado continua no mesmo notebook, a partir do passo 7.
- Cada passo começa com um Preveja: responda com a dupla antes de rodar a célula. Errar a previsão é o que torna o resultado memorável.
- Depois de rodar, compare com a saída e a leitura desta página. Toda saída aqui é exatamente o que o código imprime.
- As Simulações pedem que vocês escrevam um pequeno experimento em Python: mudar uma entrada e observar o que acontece com a saída. Nada de conta à mão. A solução fica recolhida logo abaixo: tente antes de abrir.
- Ritmo sugerido: passos 1 a 3 em 10 min; passo 4 e a simulação em 12 min; passos 5 e 6 com a simulação em 13 min.
Passo 1 — carregar e corrigir o rótulo
Preveja. No conjunto do scikit-learn, target = 1 é benigno. Se você calcular o "recall" sem mexer nisso, o que exatamente estaria medindo?
import numpy as np
import pandas as pd
from sklearn.datasets import load_breast_cancer

data = load_breast_cancer(as_frame=True)
X = data.data                     # 30 medidas numéricas de cada tumor
y = 1 - data.target               # o scikit-learn codifica benigno = 1; invertemos para 1 = maligno
print(X.shape)
print(y.value_counts())
Confira o que 1 significa antes de calcular qualquer coisa. Na cópia do scikit-learn deste conjunto, target = 1 é benigno. Do jeito que vem, o "recall" mediria o quanto achamos pacientes saudáveis. Invertemos o rótulo para que a classe positiva seja a que queremos pegar: 212 malignos (37%) contra 357 benignos.
Passo 2 — trancar o conjunto de teste
Preveja. Esta é a única divisão feita à mão no lab inteiro. Por que o stratify importa aqui, com 37% de malignos? Até que passo o X_test não pode ser tocado?
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42)
print(X_train.shape, X_test.shape)
print(f"fração maligna: treino {y_train.mean():.3f} · teste {y_test.mean():.3f}")
Esta é a única divisão feita à mão. Daqui até o passo 12, X_test e y_test não são tocados. stratify=y mantém a fração de 37% de malignos idêntica dos dois lados.
Passo 3 — um baseline, para os números significarem algo
Preveja. Um modelo que sempre responde "benigno" vai tirar que acurácia, com 37% de malignos? E que recall?
from sklearn.dummy import DummyClassifier
from sklearn.model_selection import StratifiedKFold, cross_val_score

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

dummy = DummyClassifier(strategy='most_frequent')          # sempre diz "benigno"
for metric in ['accuracy', 'recall']:
    s = cross_val_score(dummy, X_train, y_train, cv=cv, scoring=metric)
    print(f"{metric:8s} {s.mean():.3f}")
Um modelo que sempre responde "benigno" tira 62,6% de acurácia e não pega nenhum câncer. Qualquer acurácia abaixo disso é pior do que não fazer nada; mesmo 90% não impressiona muito nestes dados. Por isso o resto do lab acompanha o recall. O objeto cv definido aqui é reutilizado em todos os passos seguintes, então toda comparação usa os mesmos cinco folds.
Passo 4 — CV 5-fold com várias métricas
Preveja. Os cinco folds vão dar o mesmo recall? Se variarem, você diria que a diferença vem do modelo ou de quais tumores caíram em cada fold?
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_validate
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))

res = cross_validate(model, X_train, y_train, cv=cv, return_train_score=True,
                     scoring=['accuracy', 'precision', 'recall', 'f1', 'roc_auc'])
folds = pd.DataFrame(res).drop(columns=['fit_time', 'score_time'])
print(folds[['train_recall', 'test_accuracy', 'test_precision', 'test_recall', 'test_roc_auc']].round(3))
print(folds.agg(['mean', 'std']).T.round(3))
   train_recall  test_accuracy  test_precision  test_recall  test_roc_auc
0         0.978          0.956           1.000        0.882         0.995
1         0.963          0.967           0.943        0.971         0.999
2         0.963          1.000           1.000        1.000         1.000
3         0.978          0.978           1.000        0.941         0.987
4         0.971          0.967           0.943        0.971         0.998
                  mean    std
test_accuracy    0.974  0.017
train_accuracy   0.988  0.004
test_precision   0.977  0.031
train_precision  0.997  0.004
test_recall      0.953  0.045
train_recall     0.971  0.007
test_f1          0.964  0.023
train_f1         0.984  0.005
test_roc_auc     0.996  0.005
train_roc_auc    0.998  0.001
Como ler:
- Fold a fold. O recall vai de 0,882 no fold 0 a 1,000 no fold 2. Cada fold de validação tem 34 tumores malignos, então 0,882 são 4 perdidos e 1,000 é nenhum. Mesmo modelo, mesmos dados: a diferença é quais tumores caíram em qual fold, a "sorte da divisão" medida no começo desta aula.
- Média ± desvio. O resumo honesto é recall 0,953 ± 0,045 e ROC AUC 0,996 ± 0,005. Cite o desvio junto com a média: um recall de 0,95 ± 0,05 e outro de 0,95 ± 0,005 são afirmações muito diferentes.
- Treino vs validação. O recall de treino é 0,971 e o de validação 0,953, uma diferença de menos de 2 pontos. (O desvio impresso aqui, 0,045, vem do
pandas, que divide por \(k-1\); onumpydos passos 6 e 8 dá 0,040 para os mesmos cinco folds.) O modelo não está sobreajustando muito. Também não está subajustando: os dois números são altos. - Sem vazamento. O scaler está dentro do pipeline, então o
cross_validateo reajusta nas 364 linhas de treino de cada fold.
Simulação: a sorte da divisão, medida. A aula afirmou que um único split é uma loteria. Meça isso nos dados do lab: para 20 sementes, compare a acurácia de um único hold-out 80/20 com a média de uma CV 5-fold. Que faixa cada um percorre?
Solução
single, kfold = [], []
for seed in range(20):
    Xa, Xb, ya, yb = train_test_split(X_train, y_train, test_size=0.2, stratify=y_train,
                                      random_state=seed)
    single.append(model.fit(Xa, ya).score(Xb, yb))        # um único hold-out
    k = StratifiedKFold(5, shuffle=True, random_state=seed)
    kfold.append(cross_val_score(model, X_train, y_train, cv=k, scoring='accuracy').mean())
for name, v in [('um hold-out 80/20', single), ('média da CV 5-fold', kfold)]:
    v = np.array(v)
    print(f"{name:20s} de {v.min():.3f} a {v.max():.3f}   desvio {v.std():.3f}")
Mesmo modelo, mesmos dados, 20 relatórios diferentes. Com um único hold-out, a nota vai de 93,4% a 100,0%: duas duplas com código idêntico podem reportar números separados por quase 7 pontos e a que sorteou melhor parece ter feito um trabalho melhor. A média da CV percorre menos de um ponto e meio (desvio cinco vezes menor), porque cada semente apenas reembaralha quais linhas caem em qual fold — todas acabam validadas de todo jeito. É por isso que a CV, e não um split, é o que se reporta.
Passo 5 — uma média mais estável: CV repetida
Preveja. Repetir a CV 5-fold dez vezes com embaralhamentos diferentes muda mais a média ou a confiança que você tem nela?
from sklearn.model_selection import RepeatedStratifiedKFold

rcv = RepeatedStratifiedKFold(n_splits=5, n_repeats=10, random_state=42)
rec = cross_val_score(model, X_train, y_train, cv=rcv, scoring='recall')
print(f"{len(rec)} escores · recall {rec.mean():.3f} ± {rec.std():.3f} · "
      f"de {rec.min():.3f} a {rec.max():.3f}")
O recall do passo 4 depende de como aqueles cinco folds específicos foram cortados. Repetir a CV 5-fold dez vezes com embaralhamentos diferentes dá 50 escores e uma média (0,947) que depende muito menos de uma escolha de random_state. A dispersão dos folds individuais, de 0,853 a 1,000, lembra o quanto um único fold com 34 positivos é ruidoso. O preço são 50 ajustes em vez de 5, irrelevante aqui.
Passo 6 — ajustar C com uma busca em grade
Preveja. C pequeno é penalidade forte. Com C = 0,001, o recall de treino e o de validação vão ficar os dois baixos, os dois altos ou longe um do outro? E com C = 1000?
Lembre que o C faz o papel de \(1/\alpha\), o inverso da força da penalidade \(\alpha\) do Ridge (a menos de um fator constante): C pequeno = penalidade forte.
from sklearn.model_selection import GridSearchCV

grid = GridSearchCV(model, {'logisticregression__C': np.logspace(-3, 3, 13)},
                    cv=cv, scoring='recall', return_train_score=True)
grid.fit(X_train, y_train)

table = pd.DataFrame(grid.cv_results_)[['param_logisticregression__C', 'mean_train_score',
                                        'mean_test_score', 'std_test_score']]
table.columns = ['C', 'recall treino', 'recall val', 'desvio val']
print(table.round(3).to_string(index=False))
print(f"melhor: C = {grid.best_params_['logisticregression__C']:g} · recall {grid.best_score_:.3f}")
       C  recall treino  recall val  desvio val
   0.001          0.694       0.700       0.088
   0.003          0.843       0.841       0.084
   0.010          0.878       0.865       0.061
   0.032          0.929       0.912       0.042
   0.100          0.957       0.935       0.043
   0.316          0.965       0.947       0.051
   1.000          0.971       0.953       0.040
   3.162          0.978       0.941       0.037
  10.000          0.978       0.941       0.032
  31.623          0.985       0.941       0.032
 100.000          0.997       0.947       0.022
 316.228          1.000       0.947       0.022
1000.000          1.000       0.947       0.022
melhor: C = 1 · recall 0.953
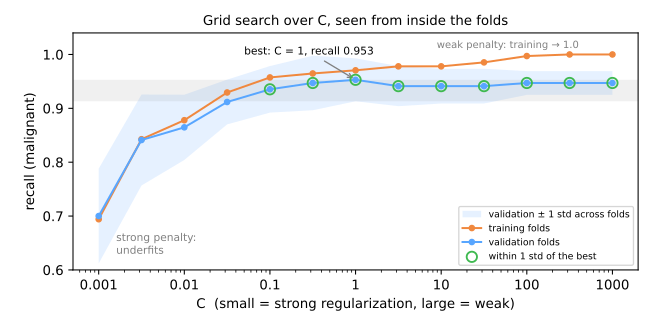
A figura mostra a tabela. C pequeno significa regularização forte: com C = 0,001 os coeficientes são esmagados para perto de zero e o modelo perde 30% dos cânceres no treino e na validação. Isso é subajuste, visível porque as duas curvas estão juntas num valor baixo. Na direção de C grande, o recall de treino sobe a 1,000 enquanto o de validação fica em torno de 0,94–0,95. A diferença se abre: é o começo do sobreajuste.
A busca em grade escolhe C = 1 com 0,953. Olhe os círculos verdes antes de comemorar: todo C de 0,1 a 1000 está a menos de um desvio-padrão entre folds (0,040) do vencedor. Essa régua é grosseira: os treze valores foram avaliados nos mesmos cinco folds e compará-los fold a fold é mais preciso (a solução da simulação abaixo faz isso). Aqui as duas concordam: as diferenças não passam do ruído entre folds, então as evidências não mostram que C = 1 supera os outros. Escolher C = 1 é aceitável. Afirmar que C = 1 é melhor que C = 10 não é. É também de novo a maldição do vencedor: 0,953 é o melhor de 13 estimativas ruidosas, portanto levemente otimista.
Até aqui só uma família foi ajustada — e só um de seus botões. Os passos 7 a 9, no lab avançado, ampliam a busca e colocam uma segunda família ao lado.
Simulação: a regra de um erro-padrão. A busca escolheu C = 1, mas a figura sugere um platô. Aplique a regra de um erro-padrão (Breiman et al., 1984): calcule o erro-padrão da melhor média (desvio entre folds dividido por \(\sqrt{5}\)), veja quantas configurações caem dentro dele e fique com a mais simples — aqui, o C mais regularizado.
Solução
t = pd.DataFrame(grid.cv_results_)[['param_logisticregression__C', 'mean_test_score', 'std_test_score']]
t.columns = ['C', 'recall', 'std']
i = t['recall'].idxmax()
se = t.loc[i, 'std'] / np.sqrt(5)                          # erro-padrão da melhor média
ok = t[t['recall'] >= t.loc[i, 'recall'] - se]
print(f"melhor: C = {t.loc[i, 'C']:g}, recall {t.loc[i, 'recall']:.3f}, um erro-padrão = {se:.3f}")
print(f"dentro de um EP: C de {ok['C'].min():g} a {ok['C'].max():g} ({len(ok)} de {len(t)} configurações)")
print(f"o C mais simples (mais regularizado) dessa faixa: C = {ok['C'].min():g}, recall {ok.loc[ok['C'].idxmin(), 'recall']:.3f}")

folds = np.array([grid.cv_results_[f'split{k}_test_score'] for k in range(5)]).T   # 13 valores de C x 5 folds
d = folds[i] - folds                                       # C = 1 menos cada C, fold a fold
tie = d.mean(axis=1) < d.std(axis=1)                       # regra pareada: diferença média dentro da dispersão
print(f"empates pareados com C = 1: C de {t['C'][tie].min():g} a {t['C'][tie].max():g}")
for j in [3, 4, 8]:                                        # C = 0,0316; 0,1 e 10
    print(f"C = 1 menos C = {t.loc[j, 'C']:<6.3g} em tumores por fold: {np.round(d[j] * 34).astype(int)}")
melhor: C = 1, recall 0.953, um erro-padrão = 0.018
dentro de um EP: C de 0.1 a 1000 (9 de 13 configurações)
o C mais simples (mais regularizado) dessa faixa: C = 0.1, recall 0.935
empates pareados com C = 1: C de 0.1 a 1000
C = 1 menos C = 0.0316 em tumores por fold: [1 0 3 2 1]
C = 1 menos C = 0.1    em tumores por fold: [1 0 2 0 0]
C = 1 menos C = 10     em tumores por fold: [0 0 2 0 0]
Nove das treze configurações caem a menos de um erro-padrão da vencedora. A regra de um erro-padrão escolhe entre elas a mais simples: C = 0,1, dez vezes mais regularizada que C = 1, por uma perda de 0,018 de recall que a convenção de um erro-padrão trata como ruído. As últimas linhas repetem a comparação fold a fold, a verificação pareada mais precisa da parte avançada (cada fold tem 34 tumores malignos): pela regra dela, todo C de 0,1 a 1000 também empata com C = 1. Contra C = 0,1 e C = 10, o C = 1 pega no máximo dois tumores a mais num fold e o mesmo número na maioria dos folds; contra C = 0,0316 ele pega mais em quatro dos cinco folds e isso não é empate. Escolher C = 1 continua defensável; o que não é defensável é afirmar que C = 1 é melhor que C = 10. A regra é uma convenção para não pagar por complexidade que os dados não confirmam.
Para fechar a parte fundamental. Em uma frase cada: (1) o que a validação cruzada avalia, um modelo ou uma receita? (2) Por que o desvio entre folds precisa ser reportado junto com a média? (3) O que acontece se o StandardScaler for ajustado antes do cross_val_score?
Sua vez (fundamental)
Para casa:
- Quantos folds? Repita o passo 4 com
cv=StratifiedKFold(3, ...)e com10. O que acontece com a média e com o desvio entre folds? Quanto custa em tempo de ajuste? - Sem estratificar. Troque o
StratifiedKFolddo passo 3 porKFold(5, shuffle=True, random_state=42)e olhe quantos malignos caem em cada fold de validação (for _, va in cv.split(X_train, y_train): print(y_train.iloc[va].sum())). Com 37% de positivos a diferença é pequena; refaça imaginando 3% e explique por que a estratificação viraria obrigatória. - Fora do pipeline. Ajuste um
StandardScalerem todo oX_train, transforme e rode ocross_val_scoresó com aLogisticRegression. Compare com o passo 4. A diferença é grande aqui? Por que você não pode concluir daí que escalonar fora do pipeline é seguro?
Abordagem avançada
A parte fundamental deu uma estimativa estável. Esta parte pergunta como ela pode mentir: informação que vaza para dentro do treino, comparações que medem quem se esforçou mais em vez de qual algoritmo serve e o número do vencedor, que é otimista por construção. Os blocos de código desta parte são independentes: cada um monta os próprios dados.
Esta parte segue um pipeline em quatro etapas: 1. achar os vazamentos, cinco padrões, cada um medido; 2. comparar com justiça, métrica primeiro, candidatos ajustados nos mesmos folds; 3. avaliar o vencedor, validação cruzada aninhada e reamostragem dentro dos folds; 4. de ponta a ponta, um experimento sem vazamento e o lab. Cada etapa leva à sua seção e, nos slides, uma faixa embaixo mostra em que etapa você está.
- Achar os vazamentoscinco padrões, cada um medido; o teste do cheiro
- Comparar com justiçamétrica primeiro, candidatos ajustados, mesmos folds, empates
- Avaliar o vencedorvalidação cruzada (CV) aninhada, reamostragem dentro dos folds
- De ponta a pontaos passos em ordem, depois o lab: comparar, verificar e testar
Slides da abordagem avançada
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e Esc mostra todos os slides. Abrir os slides numa aba nova
4. Vazamento de dados
Etapa 1. Vazamento = informação de fora do fold de treino se infiltrando no treino. O modelo parece brilhante na avaliação e desaba em produção, onde a informação vazada ainda não existe.
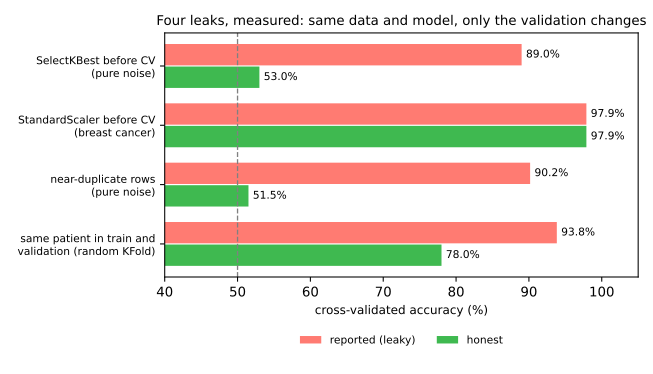
A figura abaixo resume quatro dos padrões clássicos, cada um medido duas vezes nos mesmos dados com o mesmo modelo: uma vez com o vazamento, outra com uma validação honesta (script). As seções seguintes tratam de um por vez.
1. Pré-processamento antes da divisão
Ajustar um scaler, imputador ou seletor de atributos em todos os dados antes da divisão vaza estatísticas do conjunto de teste para o treino. Você viu isso em Pré-processamento; a cura é estrutural — coloque todo passo ajustado dentro de um Pipeline para que seja reajustado em cada fold.
Quanto isso custa depende do que o passo aprende. Compare dois passos, ambos ajustados antes da CV:
import numpy as np
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.pipeline import make_pipeline

rng = np.random.default_rng(5)
X, y = rng.normal(size=(100, 5000)), rng.integers(0, 2, 100)     # 5000 colunas de ruído
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)

# ERRADO: o seletor olha os 100 rótulos, depois a CV roda nas colunas sobreviventes
X_sel = SelectKBest(f_classif, k=20).fit_transform(X, y)
print(cross_val_score(LogisticRegression(max_iter=1000), X_sel, y, cv=cv).mean())   # 0.89

# CERTO: o seletor é reajustado dentro de cada fold, nas 80 linhas de treino do fold
pipe = make_pipeline(SelectKBest(f_classif, k=20), LogisticRegression(max_iter=1000))
print(cross_val_score(pipe, X, y, cv=cv).mean())                                    # 0.53
89% em dados sem sinal nenhum. Entre 5 000 colunas aleatórias, algumas se correlacionam com os rótulos por puro acaso — inclusive com os rótulos das linhas que depois serão usadas na validação. O seletor escolhe justamente essas; cada fold então "confirma" um padrão que ajudou a escolher. Dentro do pipeline, o seletor só enxerga as linhas de treino do fold; suas escolhas são ruído para as linhas de validação e o escore volta ao acaso. Isso não é exemplo de brinquedo: Ambroise & McLachlan (2002) o encontraram em artigos publicados de expressão gênica, em que milhares de genes e algumas dezenas de pacientes são a situação normal.
O mesmo erro com um StandardScaler no câncer de mama não muda nada mensurável aqui (97,9% nos dois casos). Um scaler aprende apenas a média e o desvio-padrão de cada coluna e nunca olha para y; 569 linhas bastam para fixar bem essas estatísticas. Isso não é uma licença: um imputador, um target encoder, um sobreamostrador como o SMOTE (Synthetic Minority Over-sampling Technique) ou qualquer coisa que olhe para y ou para poucas linhas pode vazar muito. Você não tem como saber o tamanho do vazamento sem rodar as duas versões (o SMOTE é medido mais adiante). O pipeline faz a pergunta desaparecer.
Vazamento, medido em puro ruído
O simulador isola o mecanismo. Gere um alvo binário no cara ou coroa e centenas de colunas de ruído gaussiano puro. Não há nada a aprender — um pipeline honesto tem de parar em 50%. Agora selecione o atributo mais correlacionado com o alvo, depois separe, depois ajuste. A seleção viu as linhas de teste — e isso basta:
| colunas de ruído | reportado | honesto |
|---|---|---|
| 20 | 58,9% | 50,4% |
| 120 | 63,0% | 50,7% |
| 300 | 65,8% | 49,9% |
A tabela é o que o simulador mostra com as 60 amostras padrão; cada valor é a média de 200 sorteios. A barra honesta se recusa a sair do acaso, exatamente como deveria. A barra reportada sobe com o número de colunas, porque com mais colunas há mais chance de alguma delas se correlacionar com o alvo por sorte — e o passo de seleção a encontra com prazer. Dezesseis pontos de acurácia, fabricados do nada, ao reordenar duas linhas de código. É de novo a maldição do vencedor da primeira seção, agora escondida dentro de um passo de pré-processamento.
2. Atributos que conhecem o futuro
Uma coluna registrada depois do momento da previsão: prever readmissão hospitalar usando number_of_followup_visits; prever churn usando account_closed_date is null. Impecável na tabela histórica, inexistente no momento da previsão. Nenhuma escolha de esquema de CV pega este — o vazamento está nas colunas, não na divisão. Pergunte de todo atributo: "esse valor está disponível no momento em que a previsão precisa ser feita?"
3. Linhas duplicadas ou quase duplicadas
O mesmo registro (ou cópias trivialmente perturbadas) caindo em treino e teste — comum após aumento de dados (data augmentation), sobreamostragem ou junções. O modelo é avaliado em perguntas que memorizou. Para medir, tome 300 linhas de ruído com rótulos aleatórios e dê a cada linha uma gêmea quase idêntica:
import numpy as np
from sklearn.model_selection import GroupKFold, KFold, cross_val_score
from sklearn.neighbors import KNeighborsClassifier

rng = np.random.default_rng(4)
X, y = rng.normal(size=(300, 10)), rng.integers(0, 2, 300)       # rótulos no cara ou coroa
X2 = np.vstack([X, X + rng.normal(0, 0.01, X.shape)])             # cada linha + sua gêmea
y2 = np.concatenate([y, y])
twin = np.concatenate([np.arange(300), np.arange(300)])           # a qual par a linha pertence

knn = KNeighborsClassifier(n_neighbors=1)
print(cross_val_score(knn, X, y, cv=KFold(5, shuffle=True, random_state=0)).mean())    # 0.487
print(cross_val_score(knn, X2, y2, cv=KFold(5, shuffle=True, random_state=0)).mean())  # 0.902
print(cross_val_score(knn, X2, y2, cv=GroupKFold(5), groups=twin).mean())              # 0.515
Os 90% dão para prever à mão. A gêmea de uma linha de validação cai nos folds de treino com probabilidade 4/5; aí o 1-NN (k-NN com um único vizinho) a encontra e copia seu rótulo — sempre certo. Senão, ele chuta — certo metade das vezes: \(0{,}8 \times 1 + 0{,}2 \times 0{,}5 = 0{,}9\). Remova duplicatas antes de dividir ou, quando as cópias são legítimas (várias versões aumentadas de uma imagem), mantenha cada família num único fold com GroupKFold, como faz a última linha.
4. Vazamento de grupo
Múltiplas linhas por entidade (várias imagens por paciente, vários pedidos por cliente) divididas aleatoriamente: o modelo reconhece o paciente, não a doença. A simulação: 60 pacientes, 10 exames cada. Cada paciente tem uma "impressão digital" pessoal forte em 10 medidas (anatomia, o aparelho usado); uma medida carrega um sinal real de doença, mais fraco. O modelo é uma floresta aleatória (aula de random forest), usada aqui como caixa-preta.
import numpy as np
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GroupKFold, KFold, cross_val_score

def patients(n_pat, seed, per=10):
    r = np.random.default_rng(seed)
    sick = r.integers(0, 2, n_pat)
    fingerprint = r.normal(0, 3, (n_pat, 10))
    pid = np.repeat(np.arange(n_pat), per)                       # id do paciente de cada exame
    X = fingerprint[pid] + r.normal(0, 0.5, (n_pat * per, 10))
    X[:, 0] = 2.0 * sick[pid] + r.normal(0, 1, n_pat * per)      # o sinal real
    return X, sick[pid], pid

X, y, pid = patients(60, seed=1)
rf = RandomForestClassifier(n_estimators=200, random_state=0)
print(cross_val_score(rf, X, y, cv=KFold(5, shuffle=True, random_state=0)).mean())  # 0.938
print(cross_val_score(rf, X, y, cv=GroupKFold(5), groups=pid).mean())               # 0.780

X_new, y_new, _ = patients(200, seed=99)                          # um hospital novo
print(rf.fit(X, y).score(X_new, y_new))                                              # 0.7545
O KFold aleatório reporta 93,8%. Com 10 exames por paciente, cerca de 7 dos outros 9 estão nos folds de treino sempre que um é validado; a floresta só precisa reconhecer a impressão digital para lembrar o rótulo daquele paciente. O GroupKFold mantém todos os exames de um paciente num único fold e reporta 78,0%. A última linha é o juiz: 200 pacientes nunca vistos dão 75,45% — a estimativa agrupada era a honesta. Pergunte sempre qual é a unidade sobre a qual vou prever em produção (um paciente novo, um cliente novo, uma loja nova) e faça dela a unidade da divisão.
5. Vazamento temporal
Embaralhar aleatoriamente dados com marca de tempo treina o modelo no futuro para prever o passado. A demonstração mais crua usa uma série que não pode ser prevista, por construção: um passeio aleatório, em que cada dia é o anterior mais um passo gaussiano aleatório. O único atributo é o número do dia \(t\):
import numpy as np
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import KFold, TimeSeriesSplit, cross_val_score

rng = np.random.default_rng(3)
t = np.arange(500).reshape(-1, 1)
price = 50 + np.cumsum(rng.normal(0, 1, 500))                     # um passeio aleatório

rf = RandomForestRegressor(n_estimators=200, random_state=0)
print(cross_val_score(rf, t, price, cv=KFold(5, shuffle=True, random_state=0)).mean())  #  0.99
print(cross_val_score(rf, t, price, cv=TimeSeriesSplit(5)).mean())                      # -1.78

naive = [r2_score(price[va], np.full(len(va), price[tr[-1]]))      # "amanhã = último valor visto"
         for tr, va in TimeSeriesSplit(5).split(t)]
print(np.mean(naive))                                                                   # -1.70
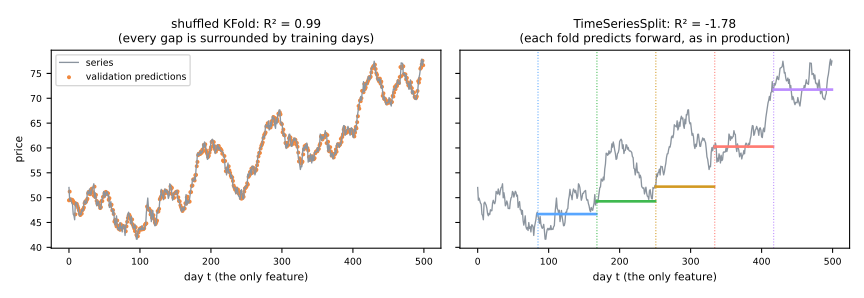
O KFold embaralhado reporta R² = 0,99 (R² é o coeficiente de determinação, 1 para um ajuste perfeito; erro absoluto médio de 0,67). À esquerda dá para ver por quê: todo dia de validação está cercado de dias de treino, então a floresta só lê o valor de ontem e de amanhã. Isso é interpolação, algo que a produção nunca oferece — o preço de amanhã não está na tabela. O TimeSeriesSplit faz a pergunta real — preveja dias que você ainda não alcançou — e a floresta só consegue estender o último valor que viu como uma reta horizontal: R² = −1,78 (erro absoluto médio de 4,64). Não leia o sinal negativo como "pior que qualquer previsão sensata": o R² de cada fold é medido contra a média daquele fold de validação, um valor que ninguém conhece de antemão. A melhor previsão honesta de um passeio aleatório, "amanhã é igual ao último valor visto", tira −1,70 nos mesmos folds (a última linha do código). Aqui essa é a resposta correta: um passeio aleatório não tem nada a ensinar. Divida sempre cronologicamente, valide com TimeSeriesSplit e construa atributos só com valores disponíveis antes do momento previsto (defasagens, médias móveis que terminam ontem).
O teste do cheiro
Se os resultados parecem bons demais — 99% de acurácia num problema difícil, um atributo com importância implausível, uma enorme diferença entre métricas offline e de produção — suspeite de vazamento primeiro, não de genialidade. Confira os principais atributos em um relatório de explicabilidade: atributos vazados costumam dominá-lo. E rode o teste mais barato que existe: embaralhe y logo no início e rode o pipeline inteiro de novo, pré-processamento incluído. Com rótulos aleatórios o escore tem de cair à linha de base embaralhada (o acaso daquele modelo e daquela métrica, não necessariamente 50%); se não cair, algum passo está aprendendo com os rótulos fora dos folds, como o seletor do padrão 1. Passar no teste prova menos: duplicatas, grupos, ordem temporal e colunas vazadas também perdem a ligação com os rótulos embaralhados, então os padrões 2 a 5 passam nele de qualquer jeito.
5. Comparando modelos com validação cruzada
Etapa 2. As aulas de classificação deixaram uma prateleira de candidatos: uma regressão logística, um k-NN com seu k e os remédios para o desbalanceamento, class_weight e reamostragem. Até aqui, cada hiperparâmetro foi escolhido num único split de validação e nada dizia qual deles colocar em produção. A validação cruzada responde a isso, desde que a própria comparação seja justa. Seis regras, cada uma medida abaixo:
- escolha a métrica a partir do problema, antes de olhar para qualquer modelo;
- ajuste todo candidato antes de compará-los;
- avalie todos os candidatos nos mesmos folds e compare-os fold a fold;
- quando dois candidatos estão dentro do ruído um do outro, prefira o mais simples;
- o escore do vencedor é otimista: avalie a escolha inteira com CV aninhada ou com o conjunto de teste trancado;
- a reamostragem, como qualquer outro passo ajustado, acontece dentro dos folds.
Escolha a métrica primeiro
O conjunto de dados é um daqueles em que o SMOTE foi apresentado (Chawla et al., 2002), já visto no laboratório da aula de ROC e dados desbalanceados: mammography, 11 183 pequenas regiões de mamografias, cada uma descrita por 6 números calculados a partir da imagem. Só 260 delas (2,3%) são calcificações, o achado que um sistema de triagem não pode deixar passar. Primeiro trancamos um conjunto de teste; depois passamos cinco candidatos pelo mesmo objeto cv:
import numpy as np
import pandas as pd
from sklearn.datasets import fetch_openml
from sklearn.dummy import DummyClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_validate, train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler

mammo = fetch_openml(data_id=310, as_frame=True)
X, y = mammo.data, (mammo.target == '1').astype(int)            # 1 = calcificação
X_dev, X_test, y_dev, y_test = train_test_split(X, y, test_size=0.2, stratify=y, random_state=0)
print(X_dev.shape, f"positivos: {y_dev.sum()} ({y_dev.mean():.1%})")

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)  # UM objeto cv para todos os candidatos
candidates = {
    'dummy':             DummyClassifier(strategy='most_frequent'),
    'logistic':          make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)),
    'logistic balanced': make_pipeline(StandardScaler(),
                                       LogisticRegression(max_iter=1000, class_weight='balanced')),
    'logistic degree 2': make_pipeline(PolynomialFeatures(2), StandardScaler(),
                                       LogisticRegression(max_iter=1000)),
    'k-NN':              make_pipeline(StandardScaler(), KNeighborsClassifier()),
}
metrics = ['accuracy', 'roc_auc', 'average_precision']
results, rows = {}, {}
for name, est in candidates.items():
    results[name] = cross_validate(est, X_dev, y_dev, cv=cv, scoring=metrics)
    rows[name] = {m: f"{results[name]['test_' + m].mean():.3f} ± {results[name]['test_' + m].std():.3f}"
                  for m in metrics}
print(pd.DataFrame(rows).T)
(8946, 6) positivos: 208 (2.3%)
                        accuracy        roc_auc average_precision
dummy              0.977 ± 0.000  0.500 ± 0.000     0.023 ± 0.000
logistic           0.983 ± 0.001  0.923 ± 0.036     0.622 ± 0.050
logistic balanced  0.901 ± 0.009  0.921 ± 0.034     0.585 ± 0.048
logistic degree 2  0.986 ± 0.001  0.948 ± 0.025     0.710 ± 0.043
k-NN               0.986 ± 0.002  0.904 ± 0.035     0.623 ± 0.070
A acurácia não distingue os candidatos: o dummy que nunca marca nada já tira 97,7%. O ROC AUC espreme os quatro modelos de verdade entre 0,90 e 0,95. Com 2,3% de positivos, o que importa é quão limpo está o topo do ranking, porque o radiologista olha primeiro as regiões marcadas. Isso é a precisão média (average precision, AP, a área sob a curva precisão–recall da aula de ROC e dados desbalanceados), que separa os candidatos: de 0,023 para o dummy (a prevalência, que é o que um ranking aleatório obtém) até 0,710. É a métrica do resto desta seção. A métrica é escolhida a partir do problema, antes de ver qual modelo ela favorece; veja Métricas de Classificação para as métricas com limiar e a aula de ROC e dados desbalanceados para as de ranking. O limiar em si é escolhido depois, só para o vencedor.
Uma linha merece uma segunda olhada. class_weight='balanced' não apenas move o limiar: ele muda os coeficientes ajustados e, aqui, deixa o ranking pior (AP 0,585 contra 0,622), enquanto o ROC AUC quase não se mexe. Pesos de classe são um hiperparâmetro como outro qualquer, a ser decidido por validação cruzada.
Ajuste todo candidato antes de comparar
A tabela acima compara modelos com suas configurações padrão. Isso mede os padrões, não os algoritmos. Cada família ganha sua própria busca em grade, todas no mesmo cv. O botão da regressão logística é o C: por padrão, o LogisticRegression do scikit-learn soma à entropia cruzada a penalidade L2 que você viu no Ridge; o C faz o papel de \(1/\alpha\), o inverso da força dessa penalidade (a menos de um fator constante): C pequeno = penalidade forte, C grande = penalidade fraca, C=np.inf = o modelo puro da aula de regressão logística.
from sklearn.model_selection import GridSearchCV

grids = {
    'logistic':          {'logisticregression__C': np.logspace(-3, 3, 7),
                          'logisticregression__class_weight': [None, 'balanced']},
    'logistic degree 2': {'logisticregression__C': np.logspace(-3, 3, 7)},
    'k-NN':              {'kneighborsclassifier__n_neighbors': [5, 15, 25, 35, 51, 75, 101],
                          'kneighborsclassifier__weights': ['uniform', 'distance']},
}
searches = {}
for name, grid in grids.items():
    searches[name] = GridSearchCV(candidates[name], grid, cv=cv, scoring='average_precision')
    searches[name].fit(X_dev, y_dev)
    s = searches[name]
    params = ', '.join(f"{k.split('__')[1]}={v}" for k, v in s.best_params_.items())
    print(f"{name:18s} {len(s.cv_results_['params']):2d} configs · "
          f"AP {s.best_score_:.3f} ± {s.cv_results_['std_test_score'][s.best_index_]:.3f} · {params}")
logistic           14 configs · AP 0.623 ± 0.050 · C=1000.0, class_weight=None
logistic degree 2   7 configs · AP 0.711 ± 0.049 · C=0.1
k-NN               14 configs · AP 0.712 ± 0.054 · n_neighbors=25, weights=distance
Com os padrões, a regressão logística de grau 2 batia o k-NN por 0,087 (0,710 contra 0,623). Ajustados, a diferença some: 0,712 contra 0,711. O k = 5 padrão era simplesmente uma má escolha para este problema. Com 2,3% de positivos, a maioria das vizinhanças de 5 não contém calcificação nenhuma; o escore de um k-NN uniforme (a fração de vizinhos positivos) só pode assumir 6 valores, um ranking muito grosseiro. Com 25 vizinhos ponderados pela distância, os escores ficam finos e a AP salta. Se você tivesse ajustado as regressões logísticas e deixado o k-NN no padrão, teria declarado um vencedor que os dados não sustentam. Um modelo ajustado contra um não ajustado mede quem se esforçou mais, não qual algoritmo serve ao problema.
A grade da logística também testou class_weight='balanced' e o rejeitou, confirmando o que a primeira tabela sugeria.
Compare fold a fold
Todos os candidatos foram avaliados nos mesmos cinco folds de validação, então os escores vêm em pares: o fold 3 são as mesmas 1 789 linhas para todo modelo. Olhe as diferenças fold a fold, para dois pares: logística contra logística balanceada e os dois líderes ajustados.
def fold_scores(search):
    """Os 5 escores de validação da configuração escolhida pelo GridSearchCV."""
    i = search.best_index_
    return np.array([search.cv_results_[f'split{k}_test_score'][i] for k in range(5)])

pairs = {'logistic - balanced': (results['logistic']['test_average_precision'],
                                 results['logistic balanced']['test_average_precision']),
         'k-NN - degree 2':     (fold_scores(searches['k-NN']),
                                 fold_scores(searches['logistic degree 2']))}
for name, (a, b) in pairs.items():
    d = a - b
    print(f"{name:20s} {a.round(3)} - {b.round(3)}")
    print(f"{'':20s} = {d.round(3)}  ->  {d.mean():+.3f} ± {d.std():.3f}")
logistic - balanced  [0.67  0.643 0.567 0.556 0.672] - [0.652 0.603 0.527 0.533 0.611]
                     = [0.018 0.04  0.041 0.023 0.061]  ->  +0.036 ± 0.015
k-NN - degree 2      [0.715 0.771 0.734 0.609 0.729] - [0.738 0.761 0.678 0.631 0.747]
                     = [-0.023  0.011  0.056 -0.022 -0.018]  ->  +0.001 ± 0.030
O primeiro par parece um empate se você só lê média ± desvio: 0,622 ± 0,050 contra 0,585 ± 0,048, dois intervalos que se sobrepõem quase por inteiro. Fold a fold não há empate nenhum. A logística simples vence todos os folds, por 0,036 ± 0,015. Os desvios-padrão grandes vêm dos folds, não dos modelos: alguns folds são difíceis para todo mundo (o fold 3 dá 0,556 e 0,533) e outros fáceis para todo mundo; subtrair fold a fold cancela essa dificuldade compartilhada. O segundo par é um empate de verdade: a diferença média (+0,001) é minúscula perto da dispersão (0,030) e o sinal troca de fold para fold.
Cinco folds é pouco. Repetir a CV 5-fold dez vezes com embaralhamentos diferentes dá 50 pares:
from sklearn.model_selection import RepeatedStratifiedKFold, cross_val_score

rcv = RepeatedStratifiedKFold(n_splits=5, n_repeats=10, random_state=0)
duels = {'logistic - balanced': (candidates['logistic'], candidates['logistic balanced']),
         'k-NN - degree 2':     (searches['k-NN'].best_estimator_,
                                 searches['logistic degree 2'].best_estimator_)}
for name, (m1, m2) in duels.items():
    a = cross_val_score(m1, X_dev, y_dev, cv=rcv, scoring='average_precision')
    b = cross_val_score(m2, X_dev, y_dev, cv=rcv, scoring='average_precision')
    d = a - b
    print(f"{name:20s} diferença {d.mean():+.3f} ± {d.std():.3f} · "
          f"primeiro à frente em {(d > 0).sum()} de {len(d)} folds")
logistic - balanced  diferença +0.041 ± 0.025 · primeiro à frente em 49 de 50 folds
k-NN - degree 2      diferença +0.011 ± 0.037 · primeiro à frente em 31 de 50 folds
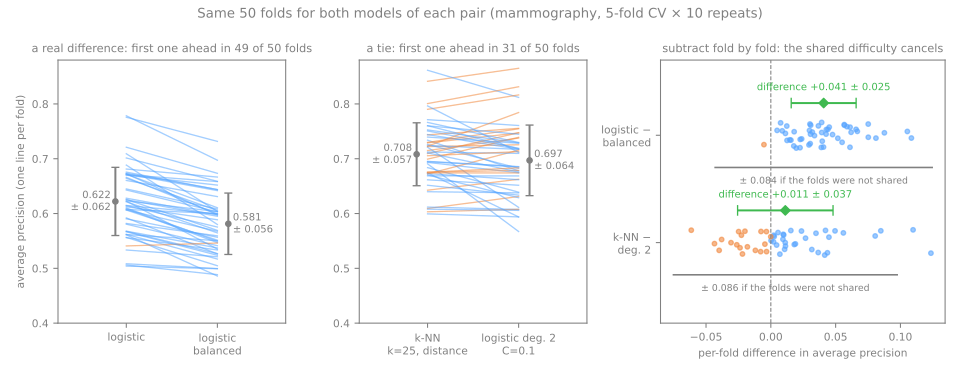
A figura desenha uma linha por fold. À esquerda, as linhas são quase paralelas e quase todas descem: o que torna um fold difícil o torna difícil para os dois modelos; o balanceado é quase sempre um pouco pior. No meio, as linhas se cruzam em todas as direções. À direita, as barras verdes mostram a dispersão da diferença fold a fold; as barras cinza mostram qual seria essa dispersão se os dois modelos tivessem sido avaliados em folds sem relação (± 0,084 e ± 0,086), entre duas e três vezes e meia mais largas. É esse o motivo de um único objeto cv com semente fixa: a comparação fica pareada. Uma comparação pareada enxerga diferenças que duas médias ± desvio separadas esconderiam.
Daí sai uma regra de bolso: se a diferença média é menor que o desvio-padrão das diferenças por fold, chame de empate. Não a leve além disso. Os folds compartilham a maior parte das linhas de treino, então não são medições independentes; um teste t pareado de livro-texto aplicado a eles é confiante demais. Dietterich (1998) e Nadeau & Bengio (2003) estudam o problema e propõem testes corrigidos; para escolher um modelo, a regra de bolso e uma olhada na figura bastam.
Quando dá empate, prefira o modelo mais simples
O k-NN e a regressão logística de grau 2 estão empatados. O que desempata é tudo o que a métrica não mede. O modelo logístico são 28 números (os 27 atributos de grau 2 e um intercepto) e prevê com um produto escalar; o k-NN carrega as 8 946 linhas de treino e as percorre a cada previsão. A menos que outra coisa pese mais, coloque a regressão logística em produção. É a navalha de Occam, operacionalizada.
Dentro de uma única família, a versão clássica dessa ideia é a regra de um erro-padrão (Breiman et al., 1984): entre as configurações cuja média está a menos de um erro-padrão da melhor, fique com a mais simples. O erro-padrão de uma média sobre 5 folds é o desvio-padrão entre folds dividido por \(\sqrt{5}\). No k-NN, um k maior faz a média de mais vizinhos e dá um modelo mais suave, mais simples:
res = pd.DataFrame(searches['k-NN'].cv_results_)
res = res[res['param_kneighborsclassifier__weights'] == 'distance']
table = pd.DataFrame({'k': res['param_kneighborsclassifier__n_neighbors'].to_numpy(),
                      'AP': res['mean_test_score'].to_numpy(),
                      'std': res['std_test_score'].to_numpy()})
best = table['AP'].idxmax()
se = table.loc[best, 'std'] / np.sqrt(5)                # erro-padrão da melhor média
print(table.round(3).to_string(index=False))
print(f"melhor: k = {table.loc[best, 'k']}, AP {table.loc[best, 'AP']:.3f} · um erro-padrão = {se:.3f}")
print(f"maior k a menos de um EP do melhor: {table[table['AP'] >= table.loc[best, 'AP'] - se]['k'].max()}")
  k    AP   std
  5 0.674 0.067
 15 0.707 0.064
 25 0.712 0.054
 35 0.708 0.054
 51 0.693 0.054
 75 0.675 0.052
101 0.662 0.050
melhor: k = 25, AP 0.712 · um erro-padrão = 0.024
maior k a menos de um EP do melhor: 51
O melhor k é 25 (AP 0,712). Tudo acima de 0,712 − 0,024 = 0,688 é indistinguível dele; a configuração mais simples dessa faixa é k = 51: o dobro de vizinhos, por uma perda de 0,019 que a convenção de um erro-padrão trata como ruído. A curva de C do lab (passo 6) usa a faixa mais folgada de um desvio-padrão inteiro. As duas são convenções para o mesmo conselho: não pague por complexidade que os dados não conseguem confirmar.
A maldição do vencedor, de novo: validação cruzada aninhada
Etapa 3. O escore vencedor, 0,712, é o melhor de 35 configurações (14 + 7 + 14), cada uma medida nos mesmos folds usados para escolhê-la. A primeira seção mostrou aonde isso leva: o melhor de muitas estimativas ruidosas é otimista. Para saber quanto vale o procedimento inteiro ("ajustar três famílias, ficar com a melhor") em dados novos, é preciso avaliá-lo em linhas que não participaram dele. A validação cruzada aninhada faz isso com dois laços:
from sklearn.base import clone
from sklearn.metrics import average_precision_score

outer = StratifiedKFold(n_splits=5, shuffle=True, random_state=1)
nested, winners = [], []
for tr, va in outer.split(X_dev, y_dev):
    # o procedimento completo, só na parte de treino externa
    fitted = {name: clone(s).fit(X_dev.iloc[tr], y_dev.iloc[tr]) for name, s in searches.items()}
    winner = max(fitted, key=lambda name: fitted[name].best_score_)
    winners.append(winner)
    proba = fitted[winner].predict_proba(X_dev.iloc[va])[:, 1]
    nested.append(average_precision_score(y_dev.iloc[va], proba))
print('vencedor em cada fold externo:', winners)
print(f"best_score_ do vencedor:  {max(s.best_score_ for s in searches.values()):.3f}")
print(f"CV aninhada da escolha:   {np.mean(nested):.3f} ± {np.std(nested):.3f}")
vencedor em cada fold externo: ['logistic degree 2', 'k-NN', 'logistic degree 2', 'k-NN', 'logistic degree 2']
best_score_ do vencedor:  0.712
CV aninhada da escolha:   0.702 ± 0.050
Saem duas coisas. A estimativa aninhada, 0,702, fica abaixo do 0,712 que a busca em grade reportou. E o vencedor muda de um fold externo para o outro, o k-NN em uns e a logística de grau 2 em outros: o próprio procedimento não consegue distingui-los, exatamente o que a comparação pareada dizia. Uma rodada aninhada também é ruidosa, então a figura a repete com dez embaralhamentos externos diferentes (script da figura):
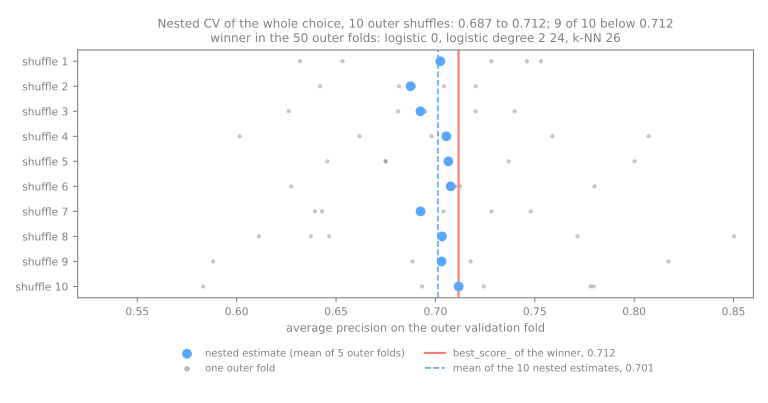
Nove das dez estimativas aninhadas ficam abaixo de 0,712, a décima cai em cima dele e a média é 0,701. Aqui a maldição custa cerca de um ponto de AP, porque são só três famílias e o sinal é forte; com centenas de configurações num conjunto pequeno ela custa muito mais, como mostrou o experimento de puro ruído no começo desta aula. A CV aninhada é cara (aqui, 5 folds externos × (35 configurações × 5 folds internos + 3 reajustes dos vencedores) = 890 ajustes) e avalia o procedimento, não um modelo ajustado: o modelo que vai para produção continua sendo o procedimento rodado uma vez em todos os dados de desenvolvimento. Quando há dados suficientes, o conjunto de teste trancado dá a mesma proteção com uma única medição. A CV aninhada serve para quando um conjunto de teste seria pequeno demais para significar algo ou quando você quer saber quanto a sua própria seleção de modelos infla os números.
A reamostragem vai dentro dos folds
O SMOTE, da aula de ROC e dados desbalanceados, é um passo ajustado: ele olha as linhas da minoria e fabrica novas entre vizinhas. Por isso pertence ao pipeline, como o scaler. O atalho tentador é sobreamostrar a tabela inteira uma vez e depois fazer a validação cruzada:
from imblearn.over_sampling import SMOTE
from imblearn.pipeline import make_pipeline as make_imb_pipeline

knn25 = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=25, weights='distance'))
scoring = ['average_precision', 'recall', 'precision']

# ERRADO: sobreamostra primeiro, depois faz a CV na tabela reamostrada
X_res, y_res = SMOTE(random_state=0).fit_resample(X_dev, y_dev)
wrong = cross_validate(knn25, X_res, y_res, cv=cv, scoring=scoring)

# CERTO: o SMOTE é um passo do pipeline, então em cada fold só vê a parte de treino
smote_knn = make_imb_pipeline(StandardScaler(), SMOTE(random_state=0),
                              KNeighborsClassifier(n_neighbors=25, weights='distance'))
right = cross_validate(smote_knn, X_dev, y_dev, cv=cv, scoring=scoring)
plain = cross_validate(knn25, X_dev, y_dev, cv=cv, scoring=scoring)       # sem SMOTE nenhum

print(f"depois do SMOTE: {len(y_res)} linhas, {y_res.mean():.0%} positivas")
for name, r in [('SMOTE antes da CV', wrong), ('SMOTE no pipeline', right), ('sem SMOTE', plain)]:
    print(f"{name:18s}", '  '.join(f"{m} {r['test_' + m].mean():.3f}" for m in scoring))
depois do SMOTE: 17476 linhas, 50% positivas
SMOTE antes da CV  average_precision 0.979  recall 0.963  precision 0.952
SMOTE no pipeline  average_precision 0.601  recall 0.875  precision 0.270
sem SMOTE          average_precision 0.712  recall 0.448  precision 0.846
O atalho reporta uma AP de 0,979, um modelo que seria uma sensação científica. Dois erros se somam. Um vazamento: a maioria dos positivos de um fold de validação agora é sintética, cada um interpolado entre duas calcificações reais que em geral estão nos folds de treino. É o vazamento de linhas duplicadas do padrão 3. O k-NN, que prevê a partir das linhas mais próximas, encontra os pais na hora. O recall não depende de quão comuns são os positivos, então mostra só o vazamento: 0,963 contra um honesto 0,875. O mundo errado: os folds de validação agora são metade positivos em vez de 2,3%; precisão e AP dependem dessa proporção. Uma precisão de 0,952 medida num mundo 50/50 diz pouco sobre o mundo real: com 2,3% de prevalência há cerca de quarenta negativos para cada positivo, então a mesma taxa de alarmes falsos produz muito mais alarmes falsos por acerto e a precisão cai muito abaixo de 0,952.
As linhas honestas também respondem à pergunta da aula de ROC e dados desbalanceados para este conjunto. O SMOTE no pipeline sobe o recall no limiar padrão (0,875 contra 0,448), mas abre mão da maior parte da precisão (0,270 contra 0,846) e baixa a AP (0,601 contra 0,712): o próprio ranking piorou. Então a reamostragem é só mais um candidato, a ser colocado no pipeline, rodado nos mesmos folds e julgado com a mesma métrica que todo o resto. Aqui ela perde.
Escolhendo o melhor modelo, em ordem
- Tranque o conjunto de teste. 2. Escolha a métrica a partir do problema. 3. Monte cada candidato como um pipeline, com todo passo ajustado dentro (scaler, codificador, SMOTE). 4. Crie um objeto
cvcom semente fixa e use-o para tudo, inclusive para umDummyClassifier. 5. Ajuste cada candidato comGridSearchCVnessecv. 6. Compare os candidatos ajustados fold a fold; se a diferença média for menor que a dispersão das diferenças, é empate e fica o mais simples. 7. Reajuste o vencedor em todos os dados de desenvolvimento e meça-o uma vez no conjunto de teste ou avalie o procedimento inteiro com CV aninhada.
6. Um experimento sem vazamento, de ponta a ponta
Etapa 4. O fluxo honesto completo, condensado num único bloco, no conjunto de câncer de mama — divisão hold-out, pipeline, CV estratificada dentro de uma busca em grade, uma medição final. O modelo é uma floresta aleatória, de novo uma caixa-preta aqui: a receita não depende dele.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, StratifiedKFold, GridSearchCV
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import roc_auc_score

# 1. Divisão hold-out final (muito importante!)
X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.15, random_state=42, stratify=y)

# 2. Pipeline: todo passo ajustado dentro, para que a CV o reajuste por fold
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('clf', RandomForestClassifier(random_state=42)),
])

# 3. Desenvolvimento do modelo: busca em grade com CV estratificada só no TREINO
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
param_grid = {
    'clf__n_estimators': [100, 200, 300],
    'clf__max_depth': [5, 10, 20],
}
grid = GridSearchCV(pipeline, param_grid, cv=cv, scoring='roc_auc', n_jobs=-1)
grid.fit(X_train, y_train)
print(grid.best_params_)
print(f"ROC AUC de CV do vencedor: {grid.best_score_:.4f}")

# 4. O modelo de produção: o GridSearchCV (refit=True, o padrão) já reajustou
#    a melhor configuração em TODO o X_train
final_model = grid.best_estimator_

# 5. Avaliação honesta — só agora, só uma vez
proba = final_model.predict_proba(X_test)[:, 1]
print(f"ROC AUC de teste:          {roc_auc_score(y_test, proba):.4f}")
{'clf__max_depth': 10, 'clf__n_estimators': 200}
ROC AUC de CV do vencedor: 0.9923
ROC AUC de teste:          0.9931
Os dois números concordam. Isso descarta um otimismo grande vindo do ajuste, mas não todo vazamento: um vazamento que o teste compartilha (duplicatas dos dois lados da divisão, o mesmo paciente nos dois lados, uma coluna que codifica a resposta) inflaria os dois números do mesmo jeito. Concordar é necessário, não suficiente. Note que grid.best_score_ é o escore do vencedor entre 9 candidatos nos mesmos folds usados para escolhê-lo, então a maldição do vencedor diz que ele é levemente otimista; com 9 candidatos e sinal forte o viés é invisível aqui, mas com centenas de candidatos num conjunto pequeno não é. O escore de teste é o que você reporta. Se precisar de uma estimativa de CV honesta de todo o procedimento de ajuste sem um conjunto de teste, envolva o GridSearchCV em outro cross_val_score (validação cruzada aninhada, medida acima): o laço interno escolhe, o externo avalia.
7. Exercícios
- No conjunto iris, compare validação cruzada K-Fold, Stratified K-Fold e Leave-One-Out: reporte a acurácia média de cada um (e o desvio dos dois esquemas k-fold) e explique as diferenças. Por que o desvio dos 150 escores do Leave-One-Out não significa nada e por que você não conseguiria calcular o recall por fold do Leave-One-Out? (Dica: o
cross_val_predictjunta as previsões.) Depois rodeKFold(3)sem embaralhar e explique o resultado (dica: como o iris está ordenado?). - Usando o índice BOVESPA (preços de
Closeviayfinance, ticker^BVSP, 2 anos): useTimeSeriesSplit(5, gap=20)para a validação cruzada (ogapdescarta os 20 dias antes de cada bloco de validação, cujos alvos entrariam nele) e ajuste uma regressão linear para prever o índice 20 dias à frente. Depois avalie o mesmo modelo comKFoldembaralhado e comTimeSeriesSplit(5)sem o gap. Quais escores são maiores e por que eles são desonestos? - Rode de novo o experimento do
SelectKBestcomk = 1, 20, 200e com 500, 5 000 e 20 000 colunas de ruído. Quando o vazamento é maior? Explique em termos da maldição do vencedor. - Tome o experimento sem vazamento acima, troque
y_trainpornp.random.permutation(y_train)e rode de novo. Que escore você deveria obter? Agora acrescente 500 colunas de puro ruído aoX_train(np.hstack([X_train, rng.normal(size=(len(X_train), 500))])) e umSelectKBest(k=5)ajustado nele inteiro, com os rótulos permutados, antes da busca em grade. Compare com o mesmo seletor dentro do pipeline, para três permutações diferentes. O que acontece com o escore com rótulos permutados? - Refaça a comparação de modelos nos dados de mamografia com
scoring='roc_auc'em vez da precisão média. A ordem dos candidatos ajustados muda? Qual métrica os separa mais e por que isso importa quando só 2,3% das linhas são positivas?
Lab avançado — comparar, verificar e testar
Os passos 7 a 13 ampliam a busca para duas famílias, comparam-nas fold a fold, verificam o vencedor e o medem uma única vez no conjunto de teste trancado no passo 2.
Como fazer este lab em aula (cerca de 35 min, em duplas)
- Use o mesmo notebook do Colab do lab fundamental e vá até o passo 7. Nada para baixar.
- Os passos 7 a 13 usam os objetos dos passos 2 a 6 (
X,X_train,X_test,cv,model,dummy). Se a sessão do Colab for nova (ou tiver expirado), clique na célula do passo 7 e use Ambiente de execução → Executar anteriores (Ctrl+F8) antes de continuar. - A dinâmica é a mesma: Preveja antes de rodar, compare com a página e tente as Simulações antes de abrir a solução.
- Ritmo sugerido: passos 7 e 8 em 10 min; passo 9 e a simulação em 12 min; passos 10 e 11 em 8 min; passos 12 e 13 com a simulação em 10 min.
Passo 7 — ajustar os candidatos nos mesmos folds
Preveja. Cada família ganha a própria grade. Por que as duas precisam usar o mesmo objeto cv? O que você mediria se ajustasse a logística e deixasse o k-NN no padrão?
from sklearn.neighbors import KNeighborsClassifier

knn = make_pipeline(StandardScaler(), KNeighborsClassifier())
search_lr = GridSearchCV(model, {'logisticregression__C': np.logspace(-3, 3, 13),
                                 'logisticregression__class_weight': [None, 'balanced']},
                         cv=cv, scoring=['recall', 'roc_auc'], refit='recall')
search_knn = GridSearchCV(knn, {'kneighborsclassifier__n_neighbors': [1, 3, 5, 7, 9, 11, 15, 21, 31],
                                'kneighborsclassifier__weights': ['uniform', 'distance']},
                          cv=cv, scoring=['recall', 'roc_auc'], refit='recall')

for name, search in [('logística', search_lr), ('k-NN', search_knn)]:
    search.fit(X_train, y_train)
    i = search.best_index_
    best_params = ', '.join(f"{k.split('__')[1]}={v:.3g}" if isinstance(v, float) else f"{k.split('__')[1]}={v}"
                            for k, v in search.best_params_.items())
    print(f"{name:9s} {len(search.cv_results_['params'])} configurações · melhor: {best_params}")
    print(f"{'':9s} recall {search.best_score_:.3f} · ROC AUC {search.cv_results_['mean_test_roc_auc'][i]:.3f}")
logística 26 configurações · melhor: C=0.316, class_weight=balanced
          recall 0.959 · ROC AUC 0.995
k-NN      18 configurações · melhor: n_neighbors=3, weights=uniform
          recall 0.935 · ROC AUC 0.989
Cada família ganha a própria grade e as duas grades usam o mesmo objeto cv, então cada uma das 44 configurações é avaliada nos mesmos cinco folds. scoring lista duas métricas: refit='recall' diz qual delas escolhe o vencedor, enquanto o ROC AUC é registrado ao lado, de modo que uma configuração que comprasse recall com um ranking ruim apareceria.
A grade da logística é a do passo 6 com class_weight acrescentado, o que muda um pouco o resultado: C = 0,316 com pesos de classe balanceados chega a um recall de 0,959, contra 0,953 de C = 1 sem eles. Como a aula de ROC e dados desbalanceados explicou, pesar mais a classe maligna, com seus 37%, empurra o modelo a marcar mais. O k-NN prefere k = 3 e chega a 0,935. Isso ainda não é um veredito: os dois próximos passos verificam se essas diferenças são maiores que o ruído.
Passo 8 — comparar tudo nos mesmos folds
Preveja. A logística ajustada está à frente do k-NN ajustado por cerca de 0,024 de recall e os desvios entre folds são 0,030 e 0,039. Isso basta para declarar um vencedor?
candidates = {'dummy': dummy,
              'logistic, default': model,
              'logistic, tuned': search_lr.best_estimator_,
              'k-NN, default': knn,
              'k-NN, tuned': search_knn.best_estimator_}
scores = {name: cross_validate(est, X_train, y_train, cv=cv, scoring=['recall', 'roc_auc'])
          for name, est in candidates.items()}
summary = pd.DataFrame({name: {'recall': s['test_recall'].mean(), 'recall std': s['test_recall'].std(),
                               'ROC AUC': s['test_roc_auc'].mean(), 'AUC std': s['test_roc_auc'].std()}
                        for name, s in scores.items()}).T
print(summary.round(3))
                   recall  recall std  ROC AUC  AUC std
dummy               0.000       0.000    0.500    0.000
logistic, default   0.953       0.040    0.996    0.005
logistic, tuned     0.959       0.030    0.995    0.005
k-NN, default       0.918       0.034    0.987    0.014
k-NN, tuned         0.935       0.039    0.989    0.013
Uma tabela, um conjunto de folds, cinco candidatos (default = configuração padrão, tuned = ajustado). O dummy está lá para ancorar a escala: recall zero, ROC AUC 0,5. O ajuste parece ajudar um pouco as duas famílias: o k-NN vai de 0,918 a 0,935, a regressão logística de 0,953 a 0,959. Leia esses ganhos com cuidado: cada linha ajustada é avaliada nos mesmos folds que a escolheram (de novo a maldição do vencedor) e 0,953 → 0,959 é um único tumor em 170. A logística ajustada está à frente do k-NN ajustado nas duas métricas, mas olhe os desvios-padrão: 0,030 e 0,039 de recall são maiores que a diferença entre os dois modelos ajustados, 0,024. Se essa diferença é real é uma pergunta para as diferenças pareadas.
Passo 9 — diferenças pareadas e o vencedor
Preveja. Em vez de comparar duas médias, compare fold a fold. Você espera que a logística vença em todos os cinco folds ou que o sinal da diferença troque?
a, b = scores['logistic, tuned'], scores['k-NN, tuned']
d_recall = a['test_recall'] - b['test_recall']
d_auc = a['test_roc_auc'] - b['test_roc_auc']
print(pd.DataFrame({'recall logística': a['test_recall'], 'recall k-NN': b['test_recall'],
                    'tumores': np.round(d_recall * 34).astype(int),   # 34 malignos por fold de validação
                    'diferença AUC': d_auc}).round(3))
for name, d in [('recall', d_recall), ('ROC AUC', d_auc)]:
    print(f"{name:7s} diferença: média {d.mean():+.3f} · desvio {d.std():.3f} · "
          f"logística à frente em {(d > 0).sum()} de 5 folds")
   recall logística  recall k-NN  tumores  diferença AUC
0             0.912        0.941       -1         -0.003
1             0.971        1.000       -1         -0.001
2             1.000        0.912        3          0.003
3             0.941        0.882        2          0.020
4             0.971        0.941        1          0.013
recall  diferença: média +0.024 · desvio 0.047 · logística à frente em 3 de 5 folds
ROC AUC diferença: média +0.006 · desvio 0.009 · logística à frente em 3 de 5 folds
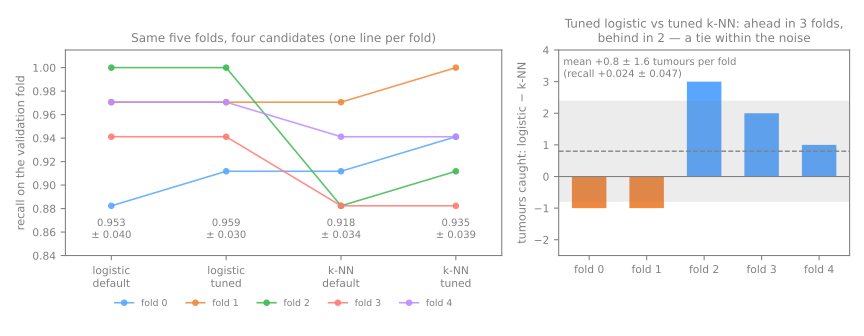
Cada fold de validação tem 34 tumores malignos, então uma diferença de recall é um número inteiro de tumores. A logística ajustada pega um tumor a menos que o k-NN nos folds 0 e 1 e pega 3, 2 e 1 a mais nos folds 2 a 4: em média 0,8 tumor por fold, com dispersão de 1,6. Em recall, a diferença média (+0,024) é cerca de metade do seu desvio-padrão (0,047). Pela regra desta aula, é um empate. O ROC AUC conta a mesma história: +0,006 ± 0,009.
A regra para escolher o vencedor precisa ser escrita antes de olhar, senão ela se dobra ao resultado. A nossa: vence o candidato com o melhor recall médio, a menos que a diferença seja menor que a dispersão das diferenças por fold; nesse caso, desempata a segunda métrica e depois a simplicidade. Aqui a segunda métrica também não desempata: a diferença de ROC AUC, +0,006 ± 0,009, é empate pela mesma regra. Então decide a simplicidade e aí não é apertado: a regressão logística são 31 coeficientes em vez de 455 tumores guardados, seus coeficientes podem ser lidos (passo 13) e suas probabilidades são a matéria-prima para escolher um limiar. O vencedor é a regressão logística ajustada, C = 0,316 com pesos de classe balanceados. Seu 0,959 continua sendo o melhor de 26 configurações, portanto levemente otimista.
Simulação: mais folds mudam o veredito? Cinco folds é pouco. Refaça a comparação pareada com RepeatedStratifiedKFold(5, n_repeats=10), que dá 50 pares, e conte em quantos cada modelo ficou à frente. O empate do passo 9 se mantém?
Solução
rcv = RepeatedStratifiedKFold(n_splits=5, n_repeats=10, random_state=0)
a = cross_val_score(search_lr.best_estimator_, X_train, y_train, cv=rcv, scoring='recall')
b = cross_val_score(search_knn.best_estimator_, X_train, y_train, cv=rcv, scoring='recall')
d = a - b
print(f"logística {a.mean():.3f} ± {a.std():.3f}   k-NN {b.mean():.3f} ± {b.std():.3f}")
print(f"diferença pareada em {len(d)} folds: {d.mean():+.3f} ± {d.std():.3f}")
print(f"logística à frente em {(d > 0).sum()}, empate em {(d == 0).sum()}, atrás em {(d < 0).sum()}")
logística 0.964 ± 0.029   k-NN 0.935 ± 0.041
diferença pareada em 50 folds: +0.028 ± 0.030
logística à frente em 32, empate em 16, atrás em 2
Com dez vezes mais folds, a diferença média mal se move (+0,028 contra +0,024) e continua do tamanho da própria dispersão: pela regra de bolso da aula, ainda é empate. Mas a contagem conta uma história mais rica que a regra: em 50 folds a logística ficou atrás em apenas 2, empatada em 16 e à frente em 32. A regra "média menor que o desvio = empate" é conservadora de propósito, porque os folds compartilham linhas de treino e não são medições independentes. Aqui ela diz "não afirme superioridade" e a contagem diz "mas, se precisar escolher um, não há motivo para preferir o k-NN" — que é exatamente o que o passo 9 faz, desempatando pela simplicidade.
Passo 10 — teste de sanidade: embaralhe os rótulos
Preveja. Com os rótulos embaralhados, não há nada a aprender. Você espera que o recall caia para zero, para 0,5 ou para algum outro valor? (Dica: o vencedor usa class_weight='balanced'.)
from sklearn.model_selection import permutation_test_score

best = search_lr.best_estimator_                 # o vencedor do passo 9
score, perm_scores, p_value = permutation_test_score(
    best, X_train, y_train, cv=cv, scoring='recall', n_permutations=100, random_state=0)
print(f"rótulos reais: {score:.3f}")
print(f"rótulos embaralhados: média {perm_scores.mean():.3f}, melhor de 100 {perm_scores.max():.3f}")
print(f"p-valor: {p_value:.4f}")
O permutation_test_score roda a validação cruzada inteira 100 vezes com o y_train embaralhado, o que quebra qualquer ligação real entre medidas e diagnóstico. Com rótulos embaralhados, o vencedor ainda chega a um recall de 0,480 em média e 0,582 no máximo. Isso não é vazamento. Com pesos de classe balanceados e nada de real para aprender, o modelo acaba marcando cerca de metade das linhas; em rótulos aleatórios, o recall é simplesmente a fração de linhas marcadas. O "acaso" é uma propriedade do modelo, não um 50% ou 0% fixo; por isso a comparação é feita contra as rodadas embaralhadas. Os rótulos reais dão 0,959 e o p-valor de 0,0099 é o menor possível com 100 permutações, \(1/101\): nenhum embaralhamento chegou perto.
Isso também é um detector de vazamento? Bem menos do que parece. O permutation_test_score embaralha o y e roda de novo só o que você passou para ele. Um vazamento que aconteceu antes da chamada (um seletor ajustado em todos os dados, linhas duplicadas, pacientes espalhados pelos folds, uma coluna que codifica a resposta) continua lá, mas o embaralhamento corta a ligação dele com os novos rótulos: os escores embaralhados caem ao acaso e o p-valor aprova o vazamento. Só um passo que roda de novo com os rótulos embaralhados pode aparecer; por isso o teste do cheiro da seção de vazamento embaralha o y logo no início e roda tudo de novo, pré-processamento incluído. Mesmo isso só pega passos que aprendem com os rótulos fora dos folds.
Passo 11 — previsões fora do fold
Preveja. Por que uma matriz de confusão feita com cross_val_predict é honesta, enquanto uma feita com best.predict(X_train) não é?
from sklearn.metrics import confusion_matrix
from sklearn.model_selection import cross_val_predict

oof = cross_val_predict(best, X_train, y_train, cv=cv)      # cada linha prevista por um modelo que nunca a viu
print(confusion_matrix(y_train, oof, labels=[1, 0]))
O cross_val_predict devolve, para cada linha de treino, a previsão feita pelo modelo do fold que não treinou nela. Por isso esta matriz de confusão é honesta: 455 linhas, cada uma prevista como dado não visto. Dos 170 tumores malignos, 7 foram perdidos (falsos negativos, em cima à direita) e 4 benignos foram marcados (falsos positivos, embaixo à esquerda). Aqui o recall deixa de ser um 0,959 abstrato e vira 7 pacientes. Na aula de ROC e dados desbalanceados, o limiar de decisão foi escolhido num único split de validação; as probabilidades fora do fold são um material melhor para essa escolha, porque cada uma das 455 linhas de treino contribui com uma previsão honesta. As previsões de treino não servem.
Passo 12 — o único teste
Preveja. A CV disse recall 0,959 ± 0,030. O teste vai cair dentro dessa faixa? Com 42 malignos no teste, quanto vale um tumor em pontos de recall?
from sklearn.metrics import accuracy_score, recall_score, roc_auc_score

pred = best.predict(X_test)                 # o GridSearchCV já reajustou o vencedor em todo o X_train
proba = best.predict_proba(X_test)[:, 1]
print(f"teste: acurácia {accuracy_score(y_test, pred):.3f} · recall {recall_score(y_test, pred):.3f}"
      f" · ROC AUC {roc_auc_score(y_test, proba):.3f}")
print(confusion_matrix(y_test, pred, labels=[1, 0]))
Uma vez, no fim, o vencedor encontra o conjunto de teste trancado. O recall é 0,976 (41 de 42 malignos encontrados, 1 perdido), com um alarme falso; o ROC AUC é 0,997. Fica acima da estimativa da CV (0,959 ± 0,030) e bem dentro de um desvio-padrão. Com 42 positivos, um tumor vale 2,4 pontos de recall, então o próprio conjunto de teste é uma medição ruidosa: a CV disse "cerca de 0,96, mais ou menos 0,03" e o teste concorda.
Note o que não fizemos: avaliar também o segundo colocado no teste. Se ficássemos com o que se saísse melhor ali, o conjunto de teste teria virado um conjunto de validação para a escolha final e seu número carregaria a maldição do vencedor. Resista também à outra tentação: se um resultado de teste decepcionar e você voltar ao passo 7 para testar outras configurações, o conjunto de teste vira um conjunto de validação e seu número deixa de significar qualquer coisa.
Simulação: quanto o próprio ajuste infla o número? O best_score_ de 0,959 é o melhor de 26 configurações, medidas nos mesmos folds que o escolheram. Avalie a busca da logística (as 26 configurações) com validação cruzada aninhada — cross_val_score(search_lr, ...) num cv externo — e compare os três números: busca, CV aninhada e teste.
Solução
outer = StratifiedKFold(n_splits=5, shuffle=True, random_state=7)
nested = cross_val_score(search_lr, X_train, y_train, cv=outer, scoring='recall')
print(f"best_score_ da busca (escolhido nos mesmos folds): {search_lr.best_score_:.3f}")
print(f"CV aninhada da busca da logística:                  {nested.mean():.3f} ± {nested.std():.3f}")
print(f"recall no conjunto de teste:                       {recall_score(y_test, best.predict(X_test)):.3f}")
best_score_ da busca (escolhido nos mesmos folds): 0.959
CV aninhada da busca da logística:                  0.953 ± 0.035
recall no conjunto de teste:                       0.976
A estimativa aninhada, 0,953, fica abaixo do 0,959 reportado pela busca. Isso é coerente com a maldição do vencedor em média, mas 0,006 é um tumor em 170, dentro do ruído de uma única rodada aninhada, cujos folds externos também são um corte aleatório. Aqui a maldição é pequena porque são só 26 configurações e o sinal é forte. Com centenas de configurações num conjunto pequeno, a diferença é muito maior, como mostrou o experimento de puro ruído da seção 1. O teste deu 0,976, acima dos dois, o que lembra que ele também é uma medição ruidosa: com 42 positivos, um tumor vale 2,4 pontos. Os três números estão dentro de um desvio uns dos outros: nenhum sinal de um viés de seleção grande, embora a concordância sozinha não descarte um vazamento que o teste compartilhe. A CV aninhada avalia o procedimento; o modelo que vai para produção continua sendo o vencedor reajustado em todo o X_train.
Passo 13 — o que o modelo aprendeu?
Preveja. Os atributos estão padronizados, então os coeficientes são comparáveis. Você espera que os maiores sejam medidas de tamanho, de textura ou de forma? E eles seriam estáveis se o modelo fosse reajustado em outro fold?
coef = pd.Series(best[-1].coef_[0], index=X.columns)
print(coef.sort_values(key=abs, ascending=False).head(6).round(2))
worst texture          0.96
radius error           0.80
worst symmetry         0.72
worst radius           0.68
mean concave points    0.64
worst area             0.64
dtype: float64
Como o pipeline padroniza todos os atributos, os coeficientes estão numa escala comum: cada um é a variação no log-odds de malignidade quando aquela medida aumenta um desvio-padrão. Textura, tamanho e concavidade empurram para maligno, o que é coerente com o modo como patologistas descrevem esses tumores. Leia com cuidado: muitos dos 30 atributos são fortemente correlacionados (raio, perímetro e área medem quase a mesma coisa), então o peso pode se dividir entre eles e os números individuais são menos estáveis que as previsões. Ajustar o modelo em cada um dos cinco folds de treino da CV (cross_validate(..., return_estimator=True)) mostra isso: worst texture vem em primeiro todas as vezes e radius error fica sempre no top 4, enquanto worst symmetry, worst radius, mean concave points e worst concavity se revezam nos lugares restantes. Trate a lista como uma pista do que importa, não como um ranking.
Para fechar a aula. Em uma frase cada: (1) qual dos cinco vazamentos nenhum esquema de CV consegue pegar? (2) Por que comparar fold a fold enxerga diferenças que duas médias ± desvio escondem? (3) Por que o best_score_ de uma busca em grade é otimista?
Sua vez (avançado)
Para casa, com mais tempo:
- Limiar. Use
cross_val_predict(best, X_train, y_train, cv=cv, method='predict_proba')[:, 1]para obter probabilidades fora do fold. Encontre o maior limiar que dá recall ≥ 0,98 e reporte a precisão que você paga por ele. Depois aplique esse limiar, uma vez, ao conjunto de teste. - Penalidade L1. Troque por
LogisticRegression(l1_ratio=1, solver='liblinear')(no scikit-learn anterior à 1.8, escrevapenalty='l1') e repita o passo 6. Quantos dos 30 coeficientes são exatamente zero no melhorC? O recall muda mais de um desvio-padrão? - A escolha inteira, aninhada. A simulação do passo 12 aninhou só a busca da logística. Escreva o laço externo você mesmo, como na seção de CV aninhada, para que ele avalie os passos 7 a 9 juntos: as duas buscas e a escolha entre elas. O número cai mais?
- Mais candidatos. Acrescente à tabela do passo 8 um candidato SMOTE + k-NN (um pipeline do
imblearn, como na aula de ROC e dados desbalanceados) ajustado no mesmocve compare-o com o vencedor fold a fold. Depois da aula de SVM, volte e acrescente também umSVC. Algum deles vence a regressão logística ajustada por mais que a dispersão das diferenças pareadas?
Referências
- Stone, M. "Cross-Validatory Choice and Assessment of Statistical Predictions." JRSS B 36 (1974). DOI
- Ambroise, C.; McLachlan, G. J. "Selection Bias in Gene Extraction on the Basis of Microarray Gene-Expression Data." PNAS 99, n. 10 (2002): 6562–6566 — seleção de atributos antes da validação cruzada, encontrada em trabalhos publicados. DOI
- Cawley, G. C.; Talbot, N. L. C. "On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation." JMLR 11 (2010): 2079–2107 — a maldição do vencedor na seleção de modelos e a CV aninhada. PDF
- Kaufman, S.; Rosset, S.; Perlich, C.; Stitelman, O. "Leakage in Data Mining: Formulation, Detection, and Avoidance." ACM TKDD 6, n. 4 (2012) — uma taxonomia do vazamento com casos reais de competições. DOI
- Breiman, L.; Friedman, J. H.; Olshen, R. A.; Stone, C. J. Classification and Regression Trees. Wadsworth (1984) — a origem da regra de um erro-padrão. DOI
- Dietterich, T. G. "Approximate Statistical Tests for Comparing Supervised Classification Learning Algorithms." Neural Computation 10, n. 7 (1998): 1895–1923 — por que testes sobre os folds da validação cruzada são confiantes demais. DOI
- Nadeau, C.; Bengio, Y. "Inference for the Generalization Error." Machine Learning 52 (2003): 239–281 — o teste corrigido para comparar modelos nos folds da CV. DOI
- Moscovich, A.; Rosset, S. "On the Cross-Validation Bias due to Unsupervised Preprocessing." JRSS B 84, no. 4 (2022): 1474–1502 — ajustar em todos os dados um passo que ignora os rótulos enviesa a CV, em geral pouco e em qualquer direção. DOI
- Chawla, N. V.; Bowyer, K. W.; Hall, L. O.; Kegelmeyer, W. P. "SMOTE: Synthetic Minority Over-sampling Technique." JAIR 16 (2002): 321–357 — o SMOTE, apresentado em vários conjuntos de dados, entre eles os dados de mamografia usados nesta aula (OpenML 310). DOI
Quiz
O quiz cobre a abordagem fundamental.