O caminho desta parte
- Achar os vazamentoscinco padrões, cada um medido; o teste do cheiro
- Comparar com justiçamétrica primeiro, candidatos ajustados, mesmos folds, empates
- Avaliar o vencedorvalidação cruzada (CV) aninhada, reamostragem dentro dos folds
- De ponta a pontaos passos em ordem, depois o lab: comparar, verificar e testar
Vazamento = informação de fora do fold de treino
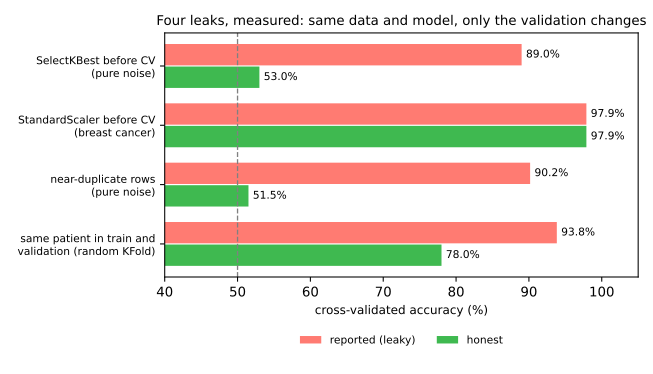
Quatro padrões clássicos, cada um medido duas vezes nos mesmos dados: com o vazamento e com uma validação honesta.
1. Pré-processamento antes da divisão
Preveja. 100 linhas, 5 000 colunas de puro ruído, rótulos no cara ou coroa. O seletor fica com 20 colunas olhando os 100 rótulos e depois a CV roda. Que acurácia sai? E com o seletor dentro do pipeline?
# ERRADO: o seletor olha os 100 rótulos, depois a CV roda nas colunas sobreviventes
X_sel = SelectKBest(f_classif, k=20).fit_transform(X, y)
cross_val_score(LogisticRegression(), X_sel, y, cv=cv).mean()   # 0.89

# CERTO: o seletor é reajustado dentro de cada fold
pipe = make_pipeline(SelectKBest(f_classif, k=20), LogisticRegression())
cross_val_score(pipe, X, y, cv=cv).mean()                       # 0.53
Um StandardScaler no mesmo erro quase não muda nada (97,9% nos dois casos). O tamanho do vazamento depende do que o passo aprende — e você não sabe sem medir. O pipeline faz a pergunta desaparecer.
Simulador: vazamento em puro ruído
Preveja. Aqui não há nada a aprender: um pipeline honesto tem de ficar em 50%. Leve os atributos de ruído de 20 a 300: o que acontece com o escore reportado e com o honesto?
2 e 3. O futuro e as duplicatas
Preveja. Cada linha ganha uma gêmea quase idêntica; os rótulos são cara ou coroa. Que acurácia o 1-NN (k vizinhos mais próximos, k-NN, com \(k = 1\)) reporta com KFold embaralhado? Dá para calcular à mão?
Atributos que conhecem o futuro
Prever readmissão com number_of_followup_visits; prever churn com account_closed_date is null.
Linhas duplicadas
| 1-NN, dados originais | 0,487 |
| com gêmeas, KFold | 0,902 |
| com gêmeas, GroupKFold | 0,515 |
A gêmea cai no treino com probabilidade 4/5; o 1-NN a encontra: \(0{,}8 \times 1 + 0{,}2 \times 0{,}5 = 0{,}9\).
4 e 5. Grupos e tempo
Preveja. O KFold aleatório vai marcar acima ou abaixo de 200 pacientes novos? E que R² (coeficiente de determinação) uma divisão honesta deve dar num passeio aleatório?
Vazamento de grupo
60 pacientes, 10 exames cada; cada paciente tem uma "impressão digital".
| KFold aleatório | 0,938 |
| GroupKFold por paciente | 0,780 |
| 200 pacientes novos | 0,7545 |
O modelo reconhece o paciente, não a doença. A estimativa agrupada era a honesta.
Vazamento temporal
Um passeio aleatório, atributo = o número do dia:
| KFold embaralhado | R² 0,99 |
| TimeSeriesSplit | R² −1,78 |
Todo dia de validação fica cercado de dias de treino: isso é interpolação, que a produção nunca oferece. O −1,78 é a resposta correta: a melhor previsão honesta, “amanhã = último valor visto”, tira −1,70.
O teste do cheiro
- Resultados bons demais — 99% num problema difícil, um atributo com importância implausível, uma diferença enorme entre offline e produção — suspeite de vazamento primeiro, não de genialidade.
- Rode o teste mais barato que existe: embaralhe
ylogo no início e rode o pipeline inteiro de novo, pré-processamento incluído. O escore tem de cair à linha de base embaralhada (o acaso daquele modelo e daquela métrica, não necessariamente 50%).
Passar prova menos: duplicatas, grupos, ordem temporal e colunas vazadas também perdem a ligação com os rótulos embaralhados, então os vazamentos 2 a 5 passam no teste de qualquer jeito.
Comparar modelos: seis regras
- escolha a métrica a partir do problema, antes de olhar qualquer modelo;
- ajuste todo candidato antes de compará-los;
- avalie todos nos mesmos folds e compare fold a fold;
- quando dois estão dentro do ruído, prefira o mais simples;
- o escore do vencedor é otimista: avalie a escolha inteira;
- a reamostragem acontece dentro dos folds.
Escolha a métrica primeiro
Mammography: 11 183 regiões de mamografias, 6 números cada; só 2,3% são calcificações. Cinco candidatos, os mesmos 5 folds, média sobre os folds.
Preveja. Que acurácia tira um dummy que nunca marca nada?
| acurácia | ROC AUC | AP | |
|---|---|---|---|
| dummy (nunca marca) | 0,977 | 0,500 | 0,023 |
| logística | 0,983 | 0,923 | 0,622 |
| logística balanceada | 0,901 | 0,921 | 0,585 |
| logística de grau 2 | 0,986 | 0,948 | 0,710 |
| k-NN | 0,986 | 0,904 | 0,623 |
ROC AUC: área sob a curva ROC (receiver operating characteristic). AP (precisão média, do inglês average precision): área sob a curva precisão–recall; um ranking aleatório tira a prevalência.
Compare fold a fold
Preveja. Logística 0,622 ± 0,050 contra balanceada 0,585 ± 0,048: é empate? O que muda se você subtrair fold a fold?
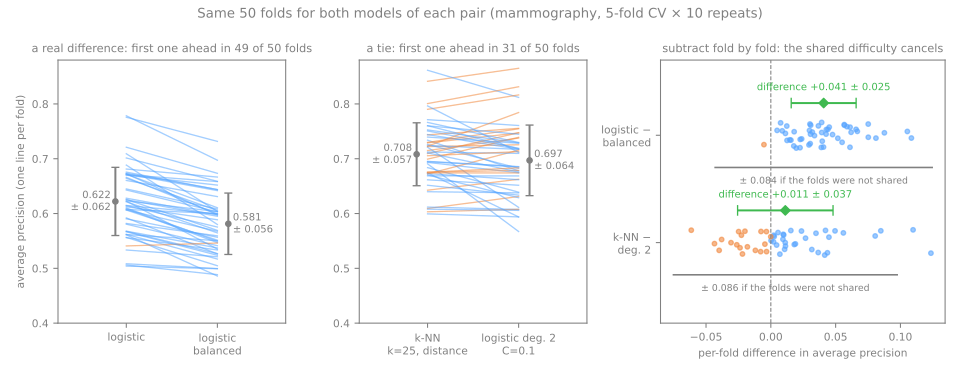
| diferença | à frente | |
|---|---|---|
| logística − balanceada | +0,041 ± 0,025 | 49/50 |
| k-NN − grau 2 | +0,011 ± 0,037 | 31/50 |
Empatou? Prefira o mais simples
Regra de um erro-padrão (Breiman et al., 1984) no k-NN (\(k\) = número de vizinhos):
| k | AP |
|---|---|
| 25 | 0,712 |
| 35 | 0,708 |
| 51 | 0,693 |
| 75 | 0,675 |
Desvio dos 5 escores por fold em \(k = 25\): 0,054; então um erro-padrão \(= 0{,}054/\sqrt{5} = 0{,}024\); faixa: AP \(\geq 0{,}712 - 0{,}024 = 0{,}688\). O maior \(k\) dentro dela é 51.
E entre famílias empatadas, o que desempata é o que a métrica não mede:
- a logística de grau 2 são 28 números e um produto escalar;
- o k-NN carrega as 8 946 linhas de treino e as percorre a cada previsão.
Validação cruzada aninhada: dois laços
O vencedor, 0,712, é o melhor de 35 configurações medidas nos folds que o escolheram. Para saber quanto vale o procedimento inteiro, avalie-o em linhas que não tomaram parte nele.
A maldição do vencedor, de novo
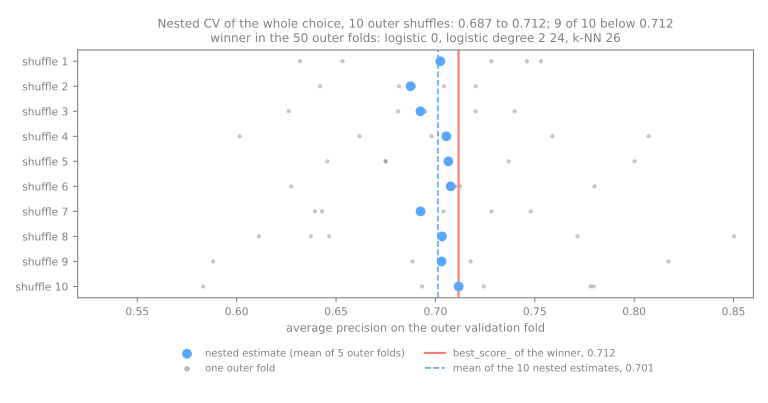
Preveja. A estimativa aninhada vai cair acima, em cima ou abaixo de 0,712? A mesma família vai vencer em todo fold externo?
- A CV aninhada roda a escolha inteira dentro de cada fold externo e avalia fora: 0,702 ± 0,050.
- O vencedor muda de fold externo para fold externo — o procedimento não distingue as famílias.
A reamostragem vai dentro dos folds
Preveja. O SMOTE (Synthetic Minority Over-sampling Technique) cria positivos novos entre positivos vizinhos. Aplicado à tabela inteira antes da CV, a AP sobe ou desce? E dentro do pipeline?
| AP | recall | precisão | |
|---|---|---|---|
| SMOTE antes da CV | 0,979 | 0,963 | 0,952 |
| SMOTE no pipeline | 0,601 | 0,875 | 0,270 |
| sem SMOTE | 0,712 | 0,448 | 0,846 |
- Um vazamento: a maioria dos positivos de validação agora é sintética, interpolada entre calcificações que estão no treino;
- O mundo errado: os folds de validação viraram 50% positivos em vez de 2,3% e precisão e AP dependem disso.
Escolhendo o melhor modelo, em ordem
- Tranque o conjunto de teste.
- Escolha a métrica a partir do problema.
- Monte cada candidato como pipeline, com todo passo ajustado dentro.
- Crie um objeto
cvcom semente fixa e use-o para tudo, inclusive para oDummyClassifier. - Ajuste cada candidato com
GridSearchCVnessecv. - Compare fold a fold; diferença menor que a dispersão = empate, fica o mais simples.
- Reajuste o vencedor e meça-o uma vez no teste ou avalie o procedimento com CV aninhada.
Um experimento sem vazamento, de ponta a ponta
Câncer de mama, uma floresta aleatória, uma grade de 9 configurações; 15% trancados como teste antes de tudo.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.15, random_state=42, stratify=y)
pipeline = Pipeline([('scaler', StandardScaler()),
                     ('clf', RandomForestClassifier(random_state=42))])
grid = GridSearchCV(pipeline, param_grid, cv=cv, scoring='roc_auc')
grid.fit(X_train, y_train)                      # CV só na parte de treino
proba = grid.best_estimator_.predict_proba(X_test)[:, 1]   # o teste, uma vez
Preveja. O escore da CV é o melhor de 9 configurações. O de teste vai cair bem abaixo dele?
ROC AUC da CV do vencedor (grid.best_score_) | 0,9923 |
| ROC AUC de teste, medido uma vez | 0,9931 |
Comparar, verificar e testar: passos 7 a 13
- Mesmo notebook do Colab, a partir do passo 7. Sessão nova? Ambiente de execução → Executar anteriores.
- Duas famílias ajustadas nos mesmos folds, comparadas fold a fold, com uma regra de desempate escrita antes de olhar.
- Simulações: mais folds mudam o veredito? (passo 9) e quanto o próprio ajuste infla o número? (passo 12).
- Passos 10 e 11: embaralhar os rótulos e previsões fora do fold.
Ritmo: passos 7 e 8 em 10 min; passo 9 e a simulação em 12 min; passos 10 e 11 em 8 min; passos 12 e 13 com a simulação em 10 min.