O caminho desta parte
- Três conjuntostreino, validação, teste; por que a validação se desgasta
- Um split → k foldsa loteria de um split; k-fold: k partes se revezam na validação; média ± desvio
- Folds honestoso divisor certo, pré-processamento reajustado em cada fold
- A receita honestacinco regras, depois o lab: ajustar C com busca em grade
Três conjuntos, três papéis
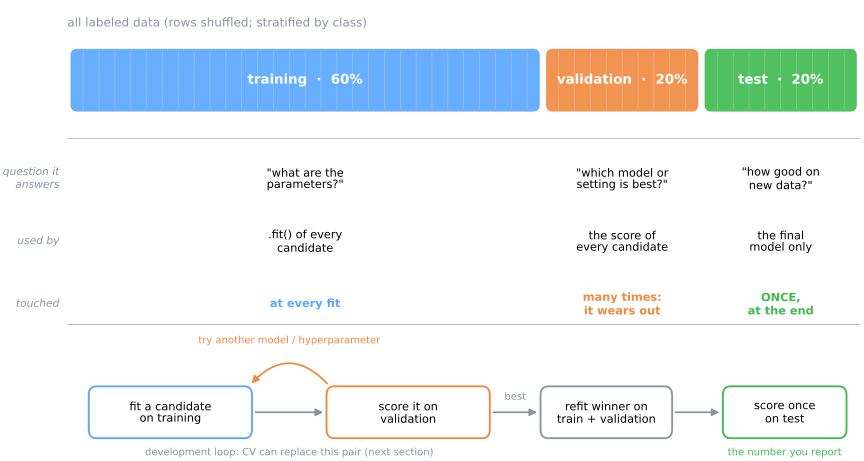
| treino | o modelo aprende seus parâmetros aqui | tocado sempre |
| validação | escolhe entre modelos e hiperparâmetros | tocado muitas vezes |
| teste | simula o futuro | tocado uma vez |
Por que um conjunto em que você escolhe deixa de ser honesto
Dados de puro ruído: 20 colunas aleatórias, alvo no cara ou coroa. Nenhum modelo pode passar de 50%. Treine 100 árvores com hiperparâmetros aleatórios e fique com a melhor na validação.
Preveja. O vencedor marca acima de 50% na validação. Quanto a mesma árvore marca em dados intocados? A diferença cresce ou diminui quando você compara mais configurações?
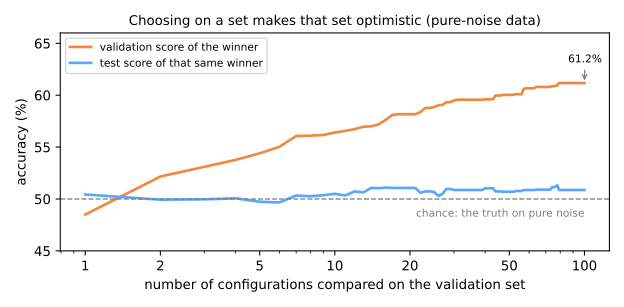
É a maldição do vencedor: o viés cresce com o número de coisas que você testou.
Um único split é uma loteria
Preveja. Só muda o random_state da divisão. Quão distantes podem ficar duas acurácias reportadas? E duas médias de uma CV 5-fold?
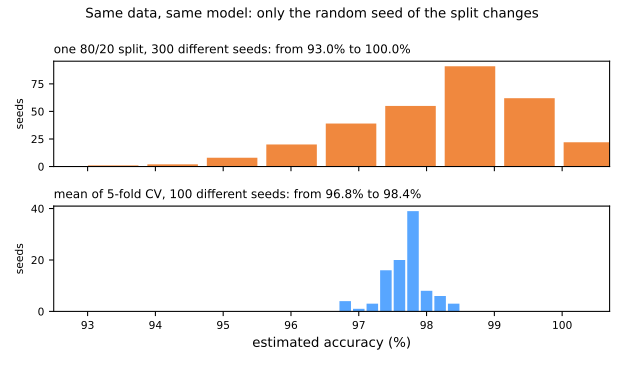
Mesmo modelo, mesmos dados, 300 sementes de uma divisão 80/20:
| um hold-out | 93,0% a 100,0% |
| média da CV 5-fold | 96,8% a 98,4% |
A CV reduz muito a sorte da divisão; ela não remove a sorte da amostra — todos os folds saem das mesmas linhas.
Simulador: a sorte da divisão
Preveja. Com \(n = 80\) linhas (\(n\) = número de linhas), aperte Sortear 100: qual faixa é mais larga, a do hold-out ou a da média da CV? Depois aperte Novo conjunto algumas vezes: a faixa da CV fica sobre a linha branca?
k-fold, passo a passo
Particione os dados de treino em \(k\) folds; cada rodada treina nos outros \(k-1\) e avalia no que ficou de fora; reporte a média e o desvio-padrão dos \(k\) escores.
k-fold no código
A CV roda só em X_train: o teste continua trancado fora, como no diagrama.
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(pipe, X_train, y_train, cv=cv, scoring='f1')
print(f"{scores.mean():.3f} ± {scores.std():.3f}")
A dispersão também é informação
- Se os folds dão 0,97 · 0,96 · 0,98 · 0,71 · 0,97, a média esconde um modelo que falha feio em algum subconjunto. Aquele fold merece uma olhada.
- Um recall de 0,95 ± 0,05 e outro de 0,95 ± 0,005 são afirmações muito diferentes.
Escolhendo um esquema de CV
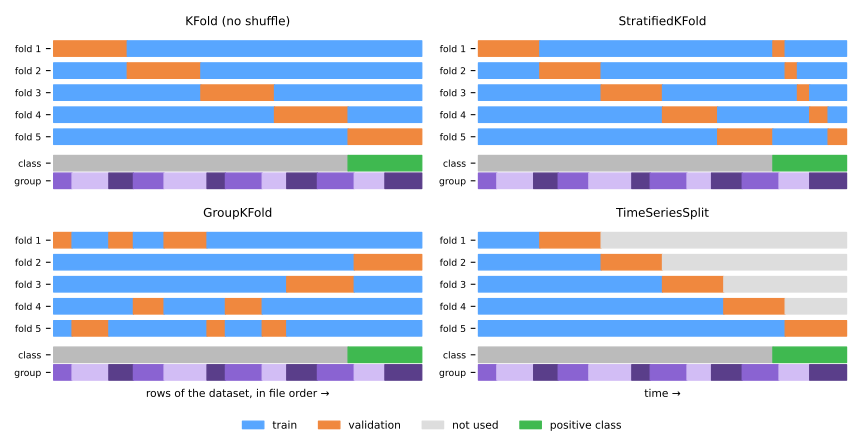
Os divisores diferem em quais linhas podem cair juntas num fold de validação.
Qual divisor usar
| método | quando usar | cuidado com |
|---|---|---|
| K-Fold | regressão, dados balanceados (com shuffle=True) | folds sem nenhuma linha de uma classe rara |
| Stratified K-Fold | classificação, principalmente desbalanceada | só estratifica pelo alvo |
| Leave-One-Out | conjuntos muito pequenos | \(n\) ajustes (\(n\) = número de linhas); uma linha por fold: sem desvio por fold |
| TimeSeriesSplit | dados temporais | os primeiros folds treinam com pouco; gap se o alvo olha à frente |
| Group K-Fold | dados agrupados (pacientes, usuários) | exige uma coluna de grupo |
Preveja. 100 linhas, 8 positivas, KFold embaralhado em 5 folds: com que frequência algum fold fica sem nenhuma positiva?
O pré-processamento reinicia em cada fold
Preveja. Se o scaler for ajustado em todo o X antes da CV, o escore sai mais alto, mais baixo ou quase igual? E se o passo fosse um seletor de atributos que olha o y?
# ERRADO: as estatísticas das linhas de validação vazam para o treino
X_scaled = StandardScaler().fit_transform(X)
cross_val_score(LogisticRegression(), X_scaled, y, cv=cv)

# CERTO: cada fold ganha o próprio scaler
pipe = make_pipeline(StandardScaler(), LogisticRegression())
cross_val_score(pipe, X, y, cv=cv)
- Escalonamento, codificação, imputação e seleção de atributos precisam ser reajustados dentro de cada fold.
- Num
Pipeline, todos os passos são ajustados só na porção de treino do fold e aplicados congelados à de validação.
A receita da validação honesta
- Tranque o conjunto de teste, com
stratifyse for classificação. - Troque o split pela CV:
StratifiedKFold(5, shuffle=True, random_state=...). - Monte cada candidato como um
Pipeline, com todo passo ajustado dentro. - Reporte média ± desvio e olhe os folds individuais.
- Reuse um único objeto
cvem todos os candidatos — a comparação fica pareada.
Câncer de mama: a CV em ação, passos 1 a 6
- 569 tumores, 30 medidas; a métrica é o recall da classe maligna.
- Notebook no Colab: nada para baixar. Salve uma cópia no seu Drive.
- Em cada passo, responda o Preveja antes de rodar.
- Simulações: a sorte da divisão, medida (passo 4) e a regra de um erro-padrão (passo 6).
Ritmo: passos 1 a 3 em 10 min; passo 4 e a simulação em 12 min; passos 5 e 6 com a simulação em 13 min.