Distributions
Distribuições e Visualização
Você plota uma coluna antes de modelá-la. Não por diligência — porque há três decisões que você não consegue tomar sem vê-la e nenhuma estatística resumo as toma por você.
O que você está procurando
- Qual transformação? — a forma de uma coluna decide se ela deve ser padronizada, logaritmizada, limitada ou partida em duas.
- Qual modelo, qual perda, qual métrica? — um alvo com 1% de positivos e um alvo balanceado são problemas diferentes, seja qual for a arquitetura.
- A tarefa é possível? — se as classes ocupam os mesmos valores, modelo nenhum as separa e o movimento honesto é procurar uma feature melhor, não uma rede mais profunda.
As três estão em ordem de quanto trabalho poupam. A terceira poupa mais e quase ninguém a faz primeiro.
1. Formas e o que cada uma pede
A distribuição normal é a que todo curso desenha e a que colunas reais menos seguem. Percorra as formas abaixo: as estatísticas sob o painel são calculadas a partir da amostra, inclusive quanto dela cai fora de três desvios padrão — número que é 0,27% numa normal e muito maior na maioria das alternativas.
| Forma | Sinal revelador | O que ela pede |
|---|---|---|
| Simétrica | média ≈ mediana, assimetria ≈ 0 | padronizar; média e desvio padrão de fato a descrevem |
| Assimétrica à direita | média ≫ mediana, assimetria > 1 | log1p primeiro, depois padronizar |
| Cauda pesada | curtose em excesso na casa das dezenas ou centenas | mediana e IQR; scaler robusto; espere linhas isoladas dominando gradientes |
| Bimodal | duas corcovas, média no vale | achar a variável escondida que a parte e torná-la feature |
| Limitada | paredes duras nas duas pontas | min-max; logit se a massa se acumula numa parede |
| Inflada em zero | um pico em zero mais uma distribuição | duas features: aconteceu? e quanto, dado que aconteceu |
A que vale internalizar é a bimodal. Uma segunda corcova raramente é uma curiosidade sobre a variável — em geral são duas populações que foram concatenadas: dois sensores, duas filiais, antes e depois de uma migração de esquema. A média então cai no vale entre elas, descrevendo um valor que não ocorre em linha alguma.
O diagnóstico mais barato que existe
Compare a média e a mediana. Iguais significa simétrica. Média bem maior significa cauda à direita. Média presa entre dois aglomerados significa duas populações. Uma subtração e isso pega a maior parte do que um histograma teria contado.
2. Ler a distribuição contra o alvo
O histograma de uma feature é metade do quadro. A pergunta que decide se o seu projeto é viável é se as classes ocupam valores diferentes.
Este painel reporta dois números que valem mais que qualquer "separabilidade: média" qualitativo. O primeiro é
a distância entre as médias das classes medida em desvios padrão. O segundo decorre dele: para duas gaussianas de dispersão igual, a melhor acurácia que qualquer classificador pode alcançar é
com \(\Phi\) a distribuição normal acumulada. Isso é um teto, não uma estimativa. Com \(d' = 1\) ele vale 69,1% e arquitetura nenhuma, otimizador nenhum e nenhuma quantidade de ajuste o movem — porque na região de sobreposição as duas classes de fato produzem as mesmas medidas e uma medida que as duas classes produzem não carrega informação sobre qual delas a produziu.
Aumente os dois controles de dispersão sem tocar nas médias: o teto cai enquanto os centros ficam exatamente onde estavam. Separação não é distância entre médias. É distância em relação à dispersão.
O que fazer quando o teto está baixo demais
Nada no modelo. Tudo nos dados: uma feature nova, um sensor melhor, um rótulo mais fino, uma interação entre duas colunas existentes. O painel é unidimensional e duas features que se sobrepõem muito cada uma podem ainda assim separar perfeitamente quando tomadas juntas — que é exatamente o que o exemplo do salmão abaixo mostra.
3. Salmão e robalo: uma feature de cada vez não é a mesma coisa que duas
Peixes numa esteira, a serem separados entre salmão e robalo a partir de dois sensores — comprimento em centímetros e brilho numa escala de 0 a 10. O exemplo é de Duda, Hart e Stork, assim como o enquadramento pelo erro de Bayes da seção anterior.2
Cada feature sozinha. Os dois histogramas se sobrepõem bastante: qualquer limiar escolhido só pelo comprimento deixa uma parcela considerável das duas espécies do lado errado e o mesmo vale para o brilho.
Os mesmos peixes, plotados contra as duas features ao mesmo tempo. Agora uma reta separa a maioria das amostras — e essa reta não está disponível em nenhum dos painéis acima.
Este é o ponto da seção anterior, feito em duas dimensões. Cada feature sozinha tem teto baixo. Juntas o teto sobe, porque a combinação de um comprimento com um brilho é informativa mesmo onde nenhum dos dois números é por si só.
A direção oposta também existe
"Mais features" não é estratégia. Cada coluna a mais também acrescenta parâmetros a estimar e, em dimensão alta, os pontos ficam esparsos e quase equidistantes, de modo que uma coluna genuinamente não informativa custa acurácia em vez de só desperdiçar espaço. Esse compromisso é a maldição da dimensionalidade, que mede exatamente quanto custa uma coluna não informativa, e o que fazer a respeito é redução de dimensionalidade.
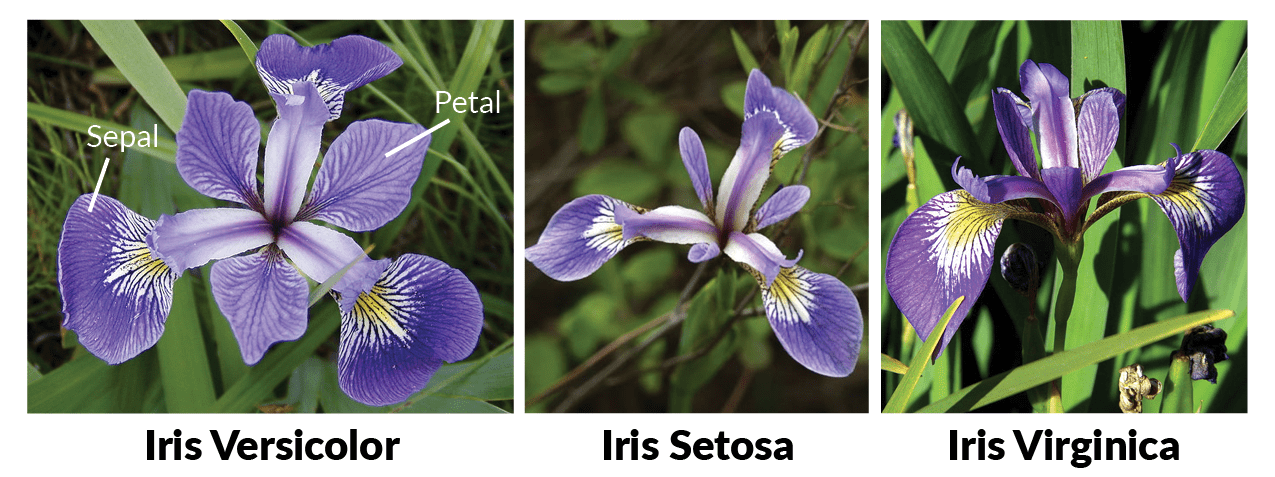
4. Iris: o conjunto de dados para saber de cor
UCI Machine Learning Repository — coletado por Edgar Anderson e publicado por Ronald Fisher em 1936.1 150 linhas, quatro medidas, três espécies. É pequeno o bastante para ser lido de ponta a ponta e estruturado o bastante para demonstrar quase tudo desta página.
| Feature | Unidade | Faixa |
|---|---|---|
| Comprimento da sépala | cm | 4,3–7,9 |
| Largura da sépala | cm | 2,0–4,4 |
| Comprimento da pétala | cm | 1,0–6,9 |
| Largura da pétala | cm | 0,1–2,5 |
     sepal_l  sepal_w  petal_l  petal_w      class
0        5.1      3.5      1.4      0.2     setosa
1        4.9      3.0      1.4      0.2     setosa
2        4.7      3.2      1.3      0.2     setosa
3        4.6      3.1      1.5      0.2     setosa
4        5.0      3.6      1.4      0.2     setosa
..       ...      ...      ...      ...        ...
145      6.7      3.0      5.2      2.3  virginica
146      6.3      2.5      5.0      1.9  virginica
147      6.5      3.0      5.2      2.0  virginica
148      6.2      3.4      5.4      2.3  virginica
149      5.9      3.0      5.1      1.8  virginica

[150 rows x 5 columns]
import pandas as pd
from sklearn.datasets import load_iris

# Carregar o conjunto de dados Iris
iris = load_iris()

# Transforma em DataFrame
df = pd.DataFrame(
    data=iris.data,
    columns=['sepal_l', 'sepal_w', 'petal_l', 'petal_w']
)
df['class'] = iris.target_names[iris.target]

# Imprime os dados
print(df)
Cada par de features. Leia os painéis uns contra os outros, não um de cada vez.
Três coisas são visíveis nessa grade e cada uma é uma decisão:
- Comprimento contra largura da pétala separa as três espécies, quase com retas. Esse par tem teto alto.
- Comprimento contra largura da sépala não separa. versicolor e virginica ficam uma em cima da outra. Se esses fossem seus únicos dois sensores, o projeto estaria limitado bem abaixo do que as medidas da pétala permitem — e modelo algum consertaria isso.
- Comprimento e largura da pétala são fortemente correlacionados entre si. Carregam informação sobreposta, então a quarta coluna compra muito menos do que a terceira comprou. É essa a observação que o PCA formaliza.
5. A distribuição do alvo
Tudo acima é sobre as entradas. Plote o alvo também — e plote-o primeiro:
- Classificação — o balanceamento das classes decide a métrica antes de decidir qualquer outra coisa. Com 1% de positivos, a acurácia não informa; veja desbalanceamento de classes.
- Regressão — um alvo assimétrico em geral pede um log e então a métrica reportada fica em unidades de log, que é uma afirmação diferente sobre o que um erro custa. Um alvo de cauda pesada significa que o erro quadrático é dominado por um punhado de linhas.
- Qualquer um dos dois — um pico, uma parede, um valor impossível, um número suspeitosamente redondo. O alvo também é dado e tem os mesmos defeitos que todo o resto. Veja qualidade dos dados.
6. As ferramentas
| Gráfico | Responde | Chamada |
|---|---|---|
| Histograma | que forma tem esta coluna? | plt.hist, sns.histplot |
| Box / violino por classe | as classes ocupam valores diferentes? | sns.violinplot |
| Dispersão | a relação entre duas colunas é linear, curva, inexistente? | plt.scatter |
| Pairplot | quais pares separam, quais são redundantes? | sns.pairplot |
| Mapa de calor de correlação | quais colunas estão dizendo a mesma coisa? | sns.heatmap(df.corr()) |
| ECDF | que fração está abaixo deste valor? | sns.ecdfplot |
| Matriz de ausências | a ausência tem padrão ou é aleatória? | msno.matrix |
| t-SNE / UMAP | há estrutura de agrupamento em muitas dimensões? | sklearn, umap-learn |
import seaborn as sns

sns.violinplot(data=df, x='especie', y='comprimento_petala')   # sobreposição, por classe
sns.heatmap(df.corr(numeric_only=True), annot=True, cmap='coolwarm', center=0)
sns.pairplot(df, hue='especie', corner=True)
Um gráfico t-SNE não é um mapa
t-SNE e UMAP produzem figuras lindas e são os gráficos mais mal lidos do aprendizado de máquina. O tamanho de um agrupamento não significa nada, a distância entre dois agrupamentos não significa nada e uma estrutura que não está nos dados pode ser fabricada só pelo ajuste da perplexidade. O que eles conseguem mostrar honestamente é a estrutura de vizinhança local. O tratamento completo, inclusive o que se pode e o que não se pode dizer sobre um gráfico desses, está em redução de dimensionalidade.
Laboratório: a forma e o teto
Passo 1 — o que uma transformação log de fato compra
A renda é lognormal e o alvo é linear no logaritmo dela. A rede recebe a coluna crua e depois logaritmizada, em quatro tamanhos de amostra — e então é perguntada sobre uma cauda que nunca viu.
regime | raw | log1p |
|---|---|---|
n = 100 | 0.838 | 0.955 |
n = 200 | 0.860 | 0.953 |
n = 500 | 0.919 | 0.955 |
n = 2000 | 0.952 | 0.963 |
unseen top decile | -80.3 | 0.726 |
column | skew | kurtosis |
|---|---|---|
income | 9.25 | 128.2 |
log1p(income) | 0.35 | 0.0 |
"""What a log transform actually buys, and when it buys nothing.

Income is lognormal — the textbook right-skewed column — and the target is
linear in its logarithm. A network is handed the column raw, and then handed it
logged, at four sample sizes and then asked to extrapolate into a tail it never
saw.

The lesson is not "always transform". It is that the transform buys sample
efficiency and extrapolation, and that with enough data inside the observed
range a network will learn the curvature on its own.

Printed as a markdown table, in identifiers only, so one artifact serves both
the English and the Portuguese page.
"""

import numpy as np
from scipy.stats import kurtosis, skew
from sklearn.metrics import r2_score
from sklearn.model_selection import KFold, cross_val_score
from sklearn.neural_network import MLPRegressor
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import FunctionTransformer, StandardScaler


def sample(n, seed=17):
    rng = np.random.default_rng(seed)
    income = np.exp(rng.normal(3.0, 1.3, n))
    return income.reshape(-1, 1), 2.0 * np.log(income) + 0.5 * rng.normal(size=n)


net = lambda: MLPRegressor(hidden_layer_sizes=(16,), max_iter=4000, random_state=0)
raw = lambda: make_pipeline(StandardScaler(), net())
logged = lambda: make_pipeline(FunctionTransformer(np.log1p), StandardScaler(), net())
cv = lambda: KFold(5, shuffle=True, random_state=0)

print("| `regime` | `raw` | `log1p` |")
print("|---|---:|---:|")
for n in (100, 200, 500, 2000):
    X, y = sample(n)
    score = lambda m: cross_val_score(m, X, y, cv=cv(), scoring="r2").mean()
    print(f"| `n = {n}` | **{score(raw()):.3f}** | **{score(logged()):.3f}** |")

X, y = sample(2000)                      # train below the 90th percentile, test above it
inside = X.ravel() <= np.quantile(X, 0.90)
tail = lambda make: r2_score(y[~inside], make().fit(X[inside], y[inside]).predict(X[~inside]))
print(f"| `unseen top decile` | **{tail(raw):.1f}** | **{tail(logged):.3f}** |")

print()
print("| `column` | `skew` | `kurtosis` |")
print("|---|---:|---:|")
column = X.ravel()
tidy = lambda v, places: f"{v:.{places}f}".removeprefix("-") if abs(v) < 0.05 else f"{v:.{places}f}"
for label, values in (("income", column), ("log1p(income)", np.log1p(column))):
    print(f"| `{label}` | {tidy(skew(values), 2)} | {tidy(kurtosis(values), 1)} |")
A segunda tabela é a transformação fazendo o trabalho dela enquanto transformação: assimetria de 9,25 para 0,35, curtose em excesso de 128 para 0. A coluna saiu de algo que a média não consegue descrever para algo que ela consegue.
A primeira tabela é quanto isso vale. Com \(n = 100\), o log vale 0,838 → 0,955 de \(R^2\), uma diferença grande. Em \(n = 2000\) vale 0,952 → 0,963, quase nada — porque, com dados suficientes dentro da faixa observada, a rede aprende a curvatura sozinha. A transformação compra eficiência amostral, não capacidade.
Exceto na última linha. Perguntada sobre o decil superior de rendas, que nunca viu no treino, a versão crua devolve \(R^2 = -80,3\) — muito pior que prever a média — enquanto a versão logaritmizada devolve 0,726. Uma rede extrapola como função quase linear das entradas dela, então aquilo em que ela extrapola é exatamente o que a transformação escolheu.
Experimente
Troque o alvo por 2.0 * income em vez de 2.0 * np.log(income) e rode de novo. Agora é a codificação crua que extrapola e o log que falha. Nenhuma transformação é certa; a certa é a que lineariza a sua relação.
Passo 2 — o teto é uma propriedade dos dados
Duas classes gaussianas, separadas ao longo de um único eixo. A coluna do meio é \(\Phi(d'/2)\), calculada em forma fechada. A coluna da direita é o que uma rede pequena alcança.
d_prime | bayes_accuracy | mlp_accuracy |
|---|---|---|
| 0.5 | 0.599 | 0.574 |
| 1.0 | 0.691 | 0.673 |
| 2.0 | 0.841 | 0.833 |
| 3.0 | 0.933 | 0.932 |
| 4.0 | 0.977 | 0.975 |
"""The data sets the ceiling. The model only decides how close it gets.

Two classes, both gaussian, differing only in the mean of the first feature.
For that setup the best accuracy *any* model can reach is known in closed form:
with the separation measured in standard deviations as d' = |mu_1 - mu_0| / sigma,
an optimal classifier is right a fraction Phi(d'/2) of the time — where Phi is
the normal cumulative distribution. Nothing beats it: not a bigger network, not
more epochs, not a better optimizer.

The last column is what a small network actually reaches. Compare it to the
column on its left before blaming the architecture for a disappointing score.

Printed as a markdown table, in identifiers only, so one artifact serves both
the English and the Portuguese page.
"""

import numpy as np
from scipy.stats import norm
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.neural_network import MLPClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

N, DIM = 4000, 4

model = lambda: make_pipeline(
    StandardScaler(), MLPClassifier(hidden_layer_sizes=(32, 16), max_iter=3000, random_state=0)
)
cv = StratifiedKFold(5, shuffle=True, random_state=0)

print("| `d_prime` | `bayes_accuracy` | `mlp_accuracy` |")
print("|---:|---:|---:|")
for separation in (0.5, 1.0, 2.0, 3.0, 4.0):
    rng = np.random.default_rng(3)
    y = rng.integers(0, 2, N)
    shift = np.zeros(DIM)
    shift[0] = separation                       # the classes differ along one axis only
    X = rng.normal(size=(N, DIM)) + y[:, None] * shift

    reachable = norm.cdf(separation / 2)         # nothing can do better than this
    reached = cross_val_score(model(), X, y, cv=cv).mean()
    print(f"| {separation:.1f} | {reachable:.3f} | **{reached:.3f}** |")
As duas colunas concordam dentro de 0,025 em toda separação e a diferença fecha conforme o problema fica mais fácil: com \(d' = 3\) a rede alcança 0,932 contra um teto de 0,933.
É esse o resultado a lembrar na próxima vez que um modelo decepcionar. A arquitetura nunca foi a restrição ativa. Com \(d' = 1\), o melhor classificador possível acerta 69,1% das vezes e uma rede de duas camadas com 48 unidades chega a 67,3%. Há no máximo dois pontos de acurácia disponíveis em qualquer coisa que você faça ao modelo; todo o resto tem de vir dos dados.
O que o laboratório ensina
Os dois passos são a mesma lição por pontas opostas. Passo 1: uma transformação não acrescenta informação, ela torna a informação mais fácil de alcançar — que é a razão de seu valor encolher conforme os dados crescem e de ela ser decisiva onde os dados acabam. Passo 2: o conteúdo de informação é fixado pelas distribuições e é isso que você deveria medir antes de começar a escolher arquiteturas.
-
Fisher, R. A. (1936). The use of multiple measurements in taxonomic problems. Annals of Eugenics 7(2), 179–188. Conjunto de dados no UCI ML Repository. As medidas foram coletadas por Edgar Anderson; Fisher as usou para demonstrar a análise discriminante. ↩
-
Duda, R. O., Hart, P. E., & Stork, D. G. (2000). Pattern Classification, 2ª edição. Wiley — a fonte do exemplo salmão/robalo e do enquadramento pelo erro de Bayes usado acima. ↩