4. Perceptron
Inspiração Biológica
Desde o início das redes neurais artificiais (ANNs), seu design foi fortemente influenciado pela estrutura e função das redes neurais biológicas. O cérebro humano, com sua complexa rede de neurônios, serve como modelo fundamental para entender como as ANNs podem processar informações. A base de uma ANN é um neurônio, que imita o comportamento dos neurônios biológicos. Cada neurônio recebe entradas, as processa e produz uma saída, similar à forma como os neurônios biológicos se comunicam através de sinapses.
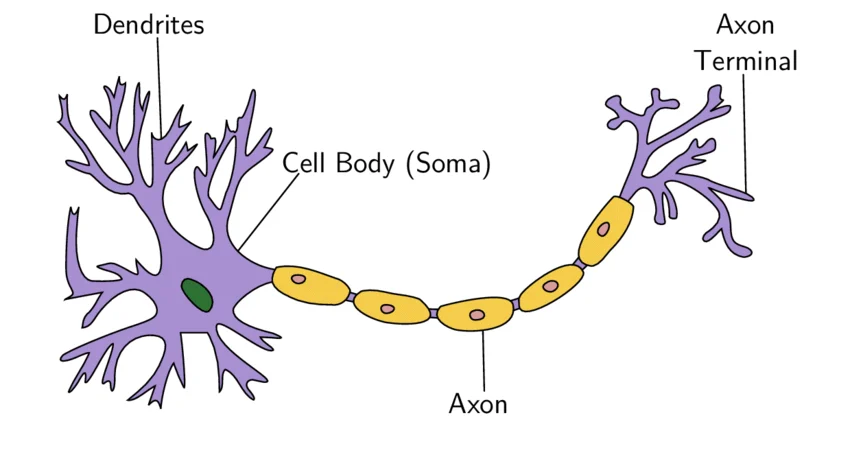
Diagrama de um Neurônio.
Fonte: Wikipedia - Neurônio
O neurônio biológico consiste em um corpo celular (soma), dendritos e um axônio. Os dendritos recebem sinais de outros neurônios, o soma processa esses sinais e o axônio transmite a saída para outros neurônios. Essa estrutura permite interações complexas e processamento de informações, essencial para aprendizado e tomada de decisão em sistemas biológicos. O sinal produzido por um neurônio é conhecido como potencial de ação, um impulso elétrico que percorre o axônio para se comunicar com outros neurônios. O potencial de ação é gerado quando o neurônio recebe entrada suficiente de seus dendritos, levando a uma mudança no potencial elétrico através de sua membrana. Esse processo é conhecido como ativação neural e é crucial para o funcionamento tanto de neurônios biológicos quanto artificiais.
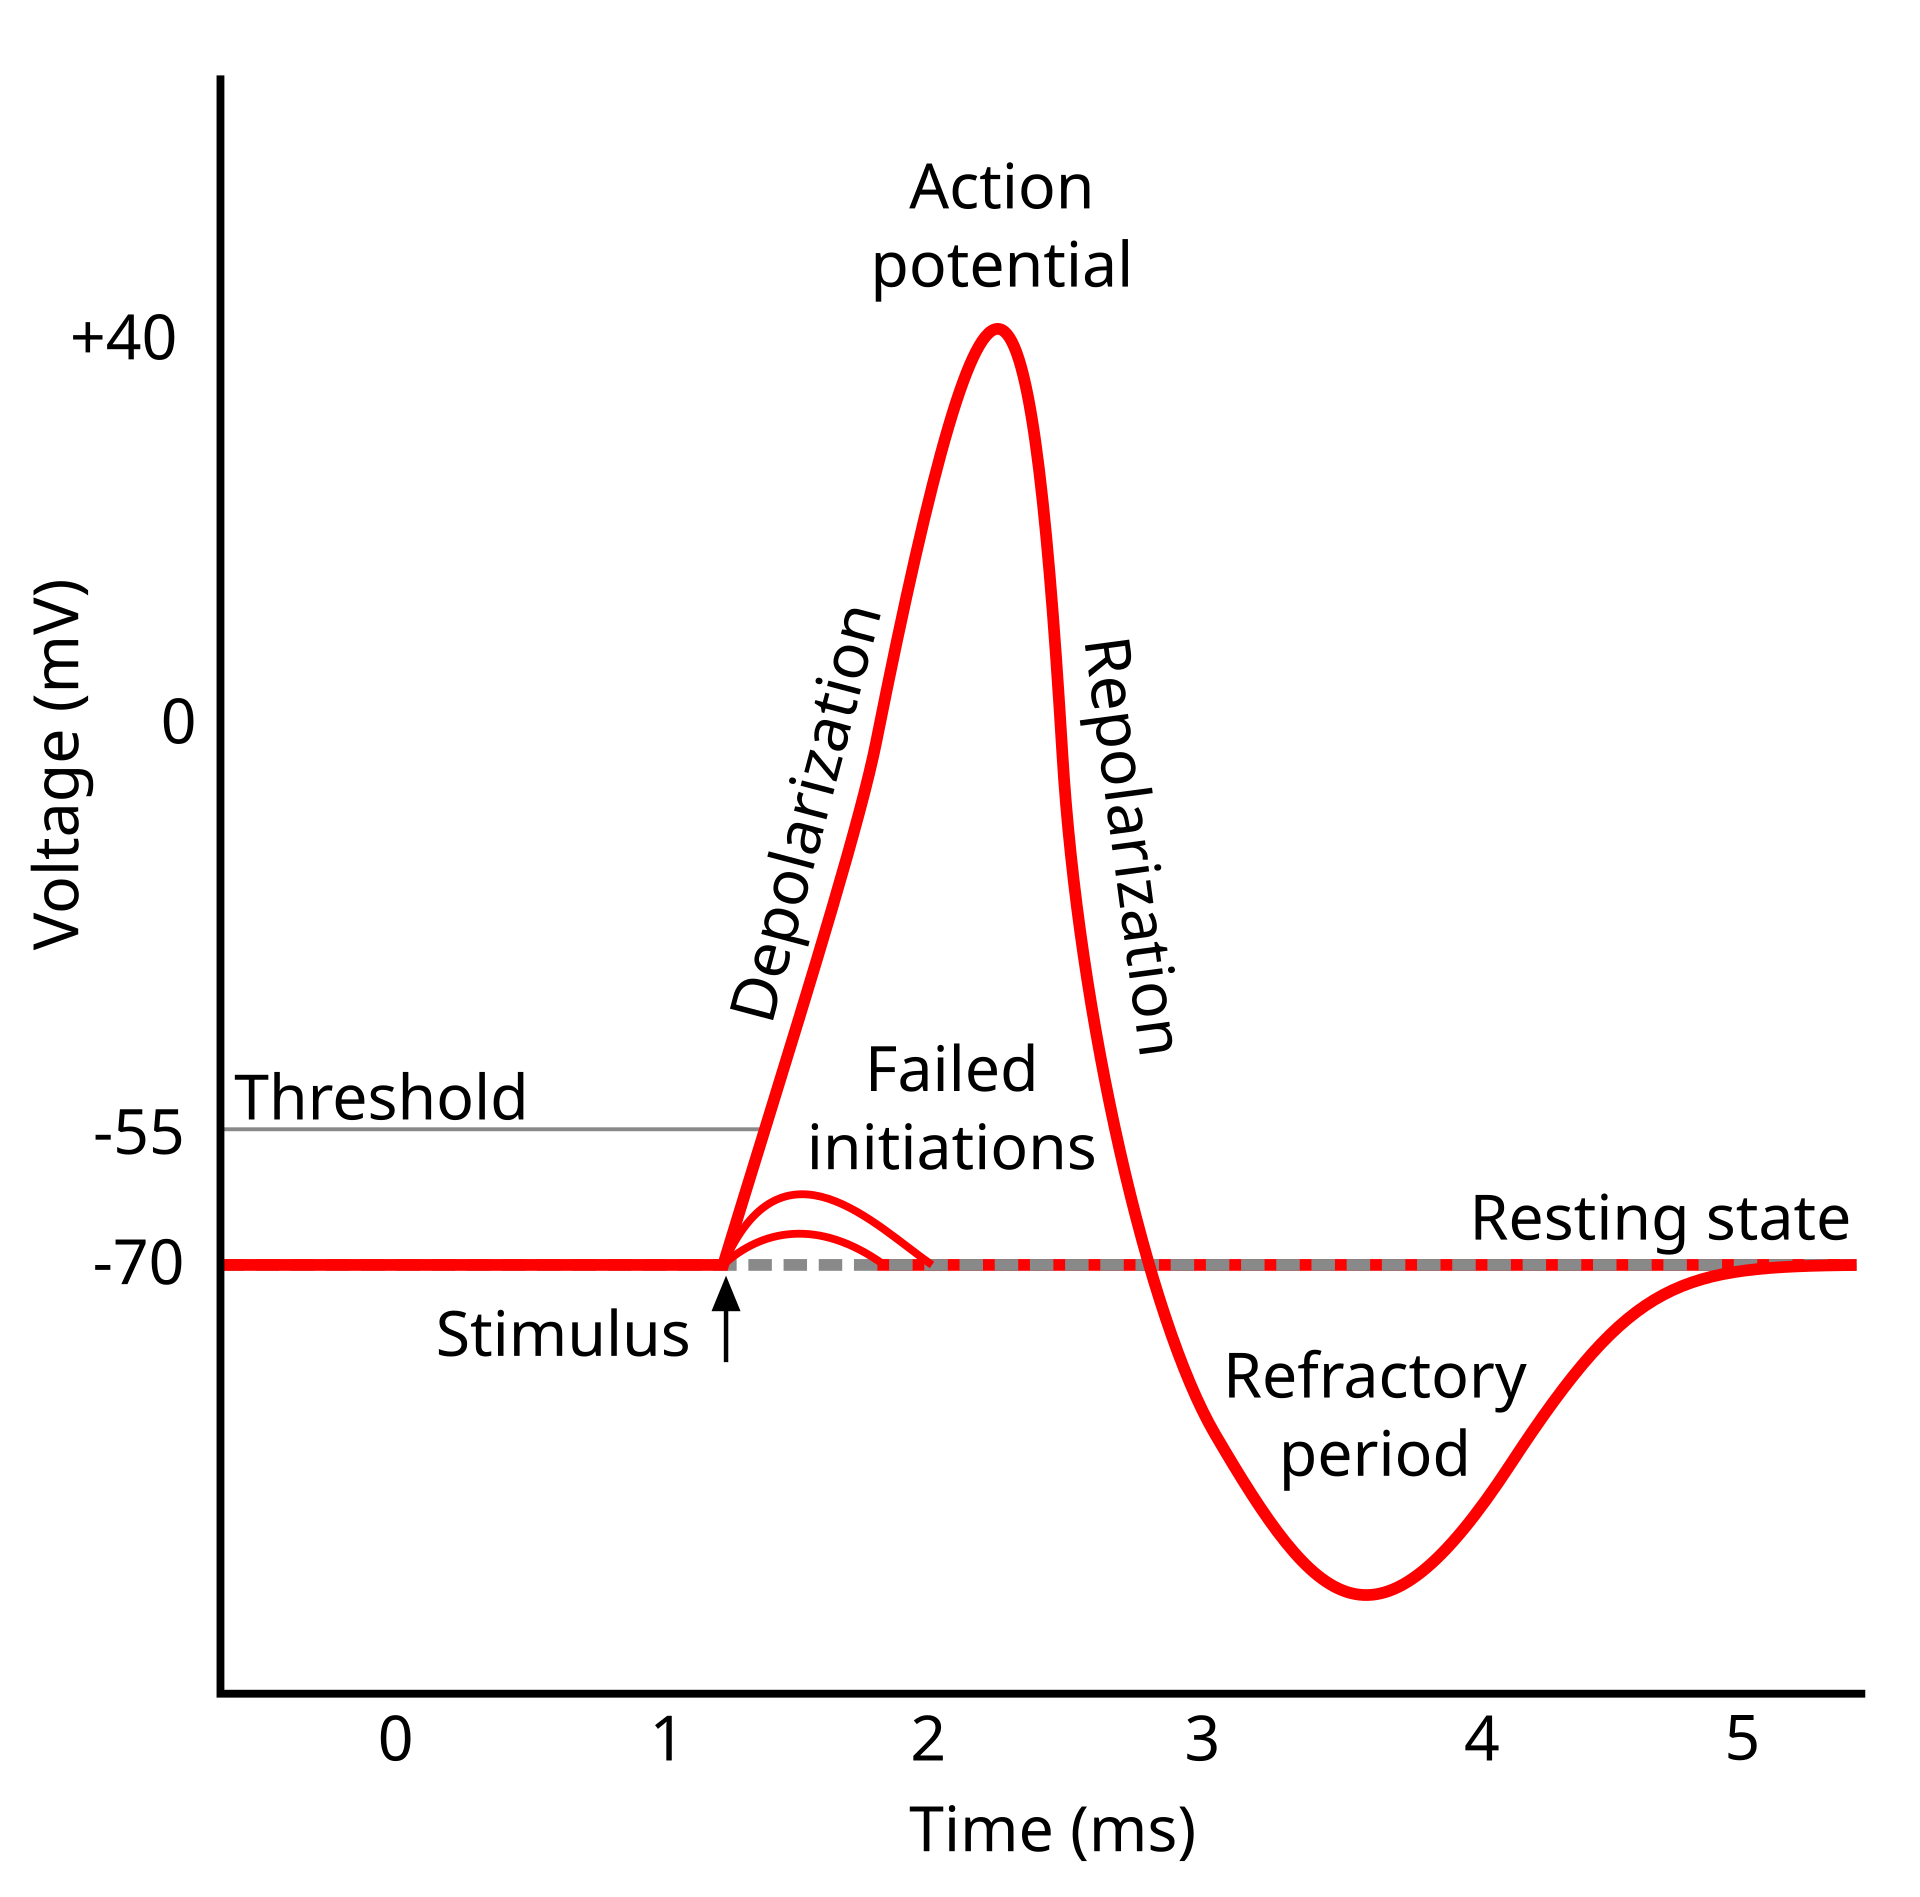
Potencial de ação.
Fonte: Wikipedia - Potencial de ação
Com base nessa inspiração biológica, McCulloch e Pitts1 propuseram o primeiro modelo matemático de um neurônio em 1943. Esse modelo lançou as bases para o desenvolvimento de neurônios artificiais, os blocos construtivos das ANNs. O neurônio McCulloch-Pitts é um modelo binário simples que produz um sinal conforme a soma ponderada de suas entradas exceda ou não um certo limiar.
Esta equação descreve como a saída do neurônio \(N_i\) no tempo \(t+1\) é determinada pela soma ponderada de suas entradas \(N_j\) no tempo \(t\), ajustada por um limiar \(\theta_i(t)\). A função \(H\) é uma função degrau que ativa o neurônio se a entrada exceder o limiar. Note que os resultados do modelo McCulloch-Pitts são binários: a saída é 0 ou 1, o que corresponde ao neurônio inativo ou ativo, respectivamente (veja a conexão com a lógica simbólica).
Esse modelo, embora simplista, captura a essência de como os neurônios processam informação e foi fundamental para o desenvolvimento de arquiteturas de redes neurais mais complexas.
Fundamentos Matemáticos
Os fundamentos matemáticos das redes neurais artificiais são construídos sobre álgebra linear, cálculo e teoria da probabilidade. Essas áreas fornecem as ferramentas necessárias para entender como as ANNs operam, como aprendem a partir de dados e como podem ser otimizadas para diversas tarefas.
O Perceptron, introduzido por Rosenblatt2 em 1958, é uma das formas mais antigas e simples de ANN. Consiste em uma única camada de neurônios que pode classificar dados linearmente separáveis. O algoritmo do Perceptron ajusta os pesos das entradas com base no erro na saída, permitindo que aprenda a partir de exemplos.
O Perceptron pode ser matematicamente descrito como:
O Perceptron calcula a saída \(y\) como:
Um perceptron é um neurônio artificial simples que recebe múltiplas entradas, aplica pesos a elas, as soma, adiciona um bias e passa o resultado por uma função de ativação (tipicamente uma função degrau) para produzir uma saída binária (por exemplo, 0 ou 1). É usado para resolver problemas de classificação linearmente separáveis3.
A saída do perceptron é calculada assim:
-
Entrada: um vetor de features \( \mathbf{x} = [x_1, x_2, \dots, x_n] \).
-
Pesos: um vetor \( \mathbf{w} = [w_1, w_2, \dots, w_n] \) que representa a importância de cada entrada.
-
Bias: um escalar \( b \) que desloca a fronteira de decisão.
-
Saída:
\[ y = \text{ativação}(\mathbf{w} \cdot \mathbf{x} + b) \]onde \( \mathbf{w} \cdot \mathbf{x} = w_1x_1 + w_2x_2 + \dots + w_nx_n \) e a função de ativação é tipicamente uma função degrau:
\[ \text{ativação}(z) = \begin{cases} 1 & \text{se } z \geq 0 \\ 0 & \text{se } z < 0 \end{cases} \]
O objetivo do treinamento é encontrar os pesos ótimos \( \mathbf{w} \) e o bias \( b \) para que o perceptron classifique corretamente os dados de treinamento.
Processo de Treinamento do Perceptron
O algoritmo de treinamento do perceptron ajusta os pesos e o bias iterativamente com base nos erros de classificação. Passo a passo:
1. Inicializar Pesos e Bias
Comece com valores aleatórios pequenos para os pesos \( \mathbf{w} \) e o bias \( b \), ou inicialize-os com zero. Esses valores iniciais não precisam ser perfeitos, pois o algoritmo vai ajustá-los durante o treinamento.
2. Fornecer Dados de Treinamento
O conjunto de treinamento consiste em pares entrada-saída \( \{(\mathbf{x}^{(i)}, y^{(i)})\} \), onde:
- \( \mathbf{x}^{(i)} \) é o vetor de features do \( i \)-ésimo exemplo.
- \( y^{(i)} \) é o rótulo verdadeiro (0 ou 1).
Os dados devem ser linearmente separáveis para que o perceptron convirja (isto é, uma reta ou um hiperplano consegue separar as duas classes).
3. Passagem Direta: Calcular a Predição
Para cada exemplo de treinamento \( \mathbf{x}^{(i)} \):
Calcule a soma ponderada:
\( z = \mathbf{w} \cdot \mathbf{x}^{(i)} + b \).
Aplique a função de ativação para obter a saída prevista \( \hat{y}^{(i)} \):
Compare a saída prevista \( \hat{y}^{(i)} \) com o rótulo verdadeiro \( y^{(i)} \).
4. Calcular o Erro
O erro é a diferença entre o rótulo verdadeiro e o rótulo previsto:
Como \( y^{(i)} \) e \( \hat{y}^{(i)} \) são binários (0 ou 1), o erro pode ser:
- \( 0 \) \( \implies \) predição correta (nenhuma atualização necessária),
- \( 1 \) \( \implies \) previu 0, mas o rótulo verdadeiro é 1 (1 - 0 = 1),
- \( -1 \) \( \implies \) previu 1, mas o rótulo verdadeiro é 0 (0 - 1 = -1).
5. Atualizar Pesos e Bias
Se a predição estiver correta (\( \text{erro} = 0 \)), nenhuma atualização é necessária.
Se a predição estiver incorreta, ajuste os pesos e o bias usando a regra de aprendizado do perceptron2, uma parente da regra de Hebb4 guiada pelo erro:
onde:
\( \eta \) (eta) é a taxa de aprendizado, um número positivo pequeno (por exemplo, 0.01) que controla o tamanho da atualização.
A atualização move a fronteira de decisão para reduzir o erro no exemplo atual.
6. Iterar
Repita os passos 3–5 para todos os exemplos do conjunto de treinamento (uma passagem pelo conjunto é chamada de época).
Critério de Parada
Continue iterando por um número fixo de épocas ou até que o perceptron classifique corretamente todos os exemplos de treinamento (isto é, sem erros).
7. Convergência
Se os dados são linearmente separáveis, há garantia de que o perceptron converge para uma solução que classifica corretamente todos os exemplos de treinamento.
Critério de Parada
Se os dados não são linearmente separáveis, o algoritmo não converge e pode oscilar. Nesses casos, pode ser preciso limitar o número de épocas ou usar um modelo diferente.
Intuição por Trás do Treinamento
- O perceptron aprende ajustando a fronteira de decisão (um hiperplano definido por \( \mathbf{w} \cdot \mathbf{x} + b = 0 \)) para separar as duas classes.
- Cada atualização de peso move o hiperplano ligeiramente para reduzir os erros de classificação.
- A taxa de aprendizado \( \eta \) controla o quão agressivamente o hiperplano é ajustado:
- Um \( \eta \) grande faz mudanças grandes, o que pode acelerar o aprendizado, mas pode passar do ponto.
- Um \( \eta \) pequeno faz mudanças pequenas, o que leva a um aprendizado mais lento, porém mais estável.
Exemplo: Treinando um Perceptron
Suponha um dataset com duas features \( \mathbf{x} = [x_1, x_2] \) e rótulos binários (0 ou 1). Vamos treinar um perceptron para classificar os pontos.
Dataset:
| \( x_1 \) | \( x_2 \) | Rótulo (\( y \)) |
|---|---|---|
| 1 | 1 | 1 |
| 2 | 2 | 1 |
| -1 | -1 | 0 |
| -2 | -1 | 0 |
Passo a Passo:
-
Inicializar: \( \mathbf{w} = [0, 0] \), \( b = 0 \) e \( \eta = 0.1 \).
-
Primeiro Exemplo: \( \mathbf{x}^{(1)} = [1, 1] \), \( y^{(1)} = 1 \).
- Calcula: \( z = \underbrace{0}_{w_1} \cdot \underbrace{1}_{x_1} + \underbrace{0}_{w_2} \cdot \underbrace{1}_{x_2} + \underbrace{0}_{b} = 0 \), então \( \hat{y}^{(1)} = 1 \) (pois \( z \geq 0 \)).
- Erro: \( y^{(1)} - \hat{y}^{(1)} = 1 - 1 = 0 \). Nenhuma atualização necessária.
-
Segundo Exemplo: \( \mathbf{x}^{(2)} = [2, 2] \), \( y^{(2)} = 1 \).
- Calcula: \( z = \underbrace{0}_{w_1} \cdot \underbrace{2}_{x_1} + \underbrace{0}_{w_2} \cdot \underbrace{2}_{x_2} + \underbrace{0}_{b} = 0 \), então \( \hat{y}^{(2)} = 1 \).
- Erro: \( \underbrace{1}_{y^{(2)}} - \underbrace{1}_{\hat{y}^{(2)}} = 0 \). Nenhuma atualização.
-
Terceiro Exemplo: \( \mathbf{x}^{(3)} = [-1, -1] \), \( y^{(3)} = 0 \).
- Calcula: \( z = \underbrace{0}_{w_1} \cdot \underbrace{-1}_{x_1} + \underbrace{0}_{w_2} \cdot \underbrace{-1}_{x_2} + \underbrace{0}_{b} = 0 \), então \( \hat{y}^{(3)} = 1 \).
- Erro: \( \underbrace{0}_{y^{(3)}} - \underbrace{1}_{\hat{y}^{(3)}} = -1 \).
- Atualiza:
\[ \mathbf{w} = \underbrace{[0, 0]}_{\mathbf{w}} + \underbrace{0.1}_{\eta} \cdot \underbrace{-1}_{\text{erro}} \cdot \underbrace{[-1, -1]}_{\mathbf{x}^{(3)}} = [0, 0] + [0.1, 0.1] = [0.1, 0.1] \]\[ b = \underbrace{0}_{b} + \underbrace{0.1}_{\eta} \cdot \underbrace{-1}_{\text{erro}} = -0.1 \] -
Quarto Exemplo: \( \mathbf{x}^{(4)} = [-2, -1] \), \( y^{(4)} = 0 \).
-
Calcula: \( z = \underbrace{0.1}_{w_1} \cdot \underbrace{-2}_{x_1} + \underbrace{0.1}_{w_2} \cdot \underbrace{-1}_{x_2} + \underbrace{-0.1}_{b} = -0.4 \), então \( \hat{y}^{(4)} = 0 \).
-
Erro: \( \underbrace{0}_{y^{(4)}} - \underbrace{0}_{\hat{y}^{(4)}} = 0 \). Nenhuma atualização.
-
-
Repetir: Continue iterando pelo dataset, atualizando pesos e bias quando ocorrerem erros, até que todos os exemplos sejam classificados corretamente ou que se atinja um número máximo de épocas.
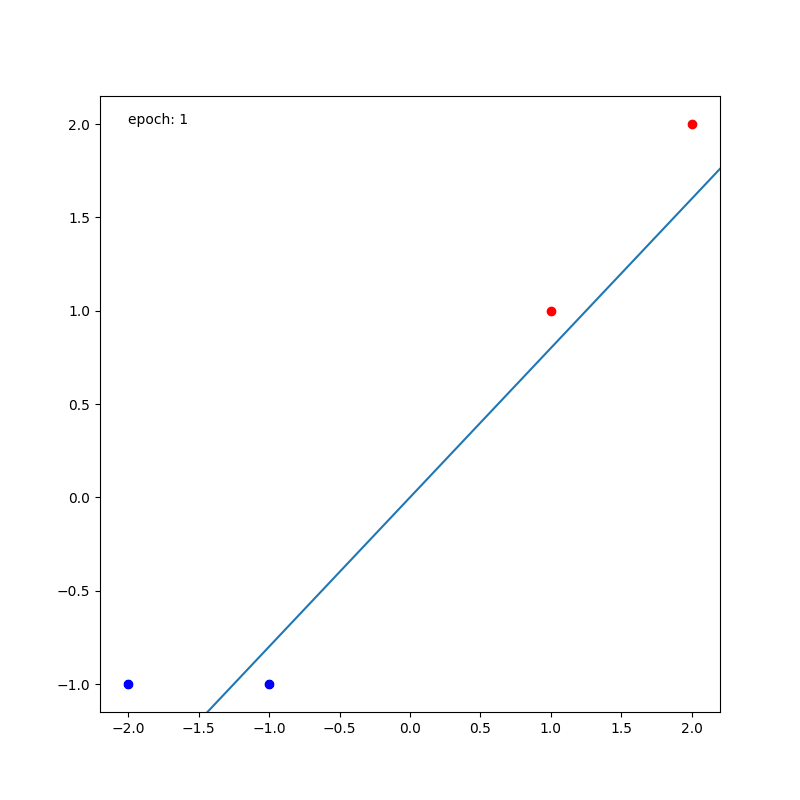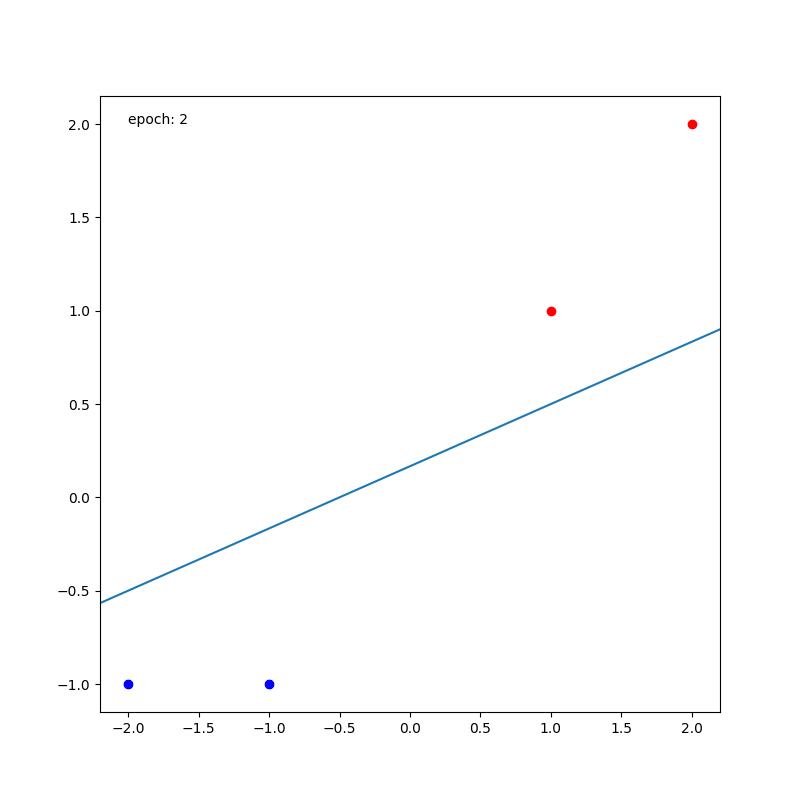
Pontos Principais
- Separabilidade Linear: O perceptron só funciona para datasets em que um único hiperplano consegue separar as classes. Para dados não linearmente separáveis (por exemplo, o problema XOR), um único perceptron falha e é preciso um perceptron multicamadas (MLP) ou outros modelos.
- Taxa de Aprendizado: Escolher um \( \eta \) adequado é crucial. Grande demais, o algoritmo pode oscilar; pequeno demais, pode convergir devagar demais.
- Convergência: O teorema de convergência do perceptron garante que o algoritmo encontra uma solução em um número finito de passos se os dados são linearmente separáveis.
- Limitações: O perceptron é um modelo simples e não lida com padrões complexos nem com problemas multiclasse sem extensões (por exemplo, combinar vários perceptrons).
Visualizando a Fronteira de Decisão
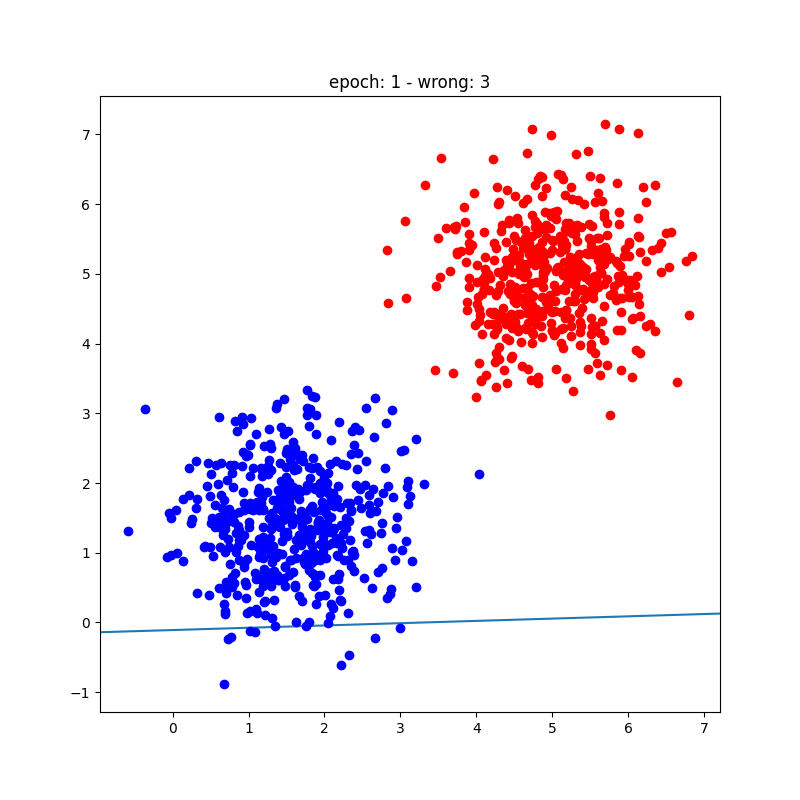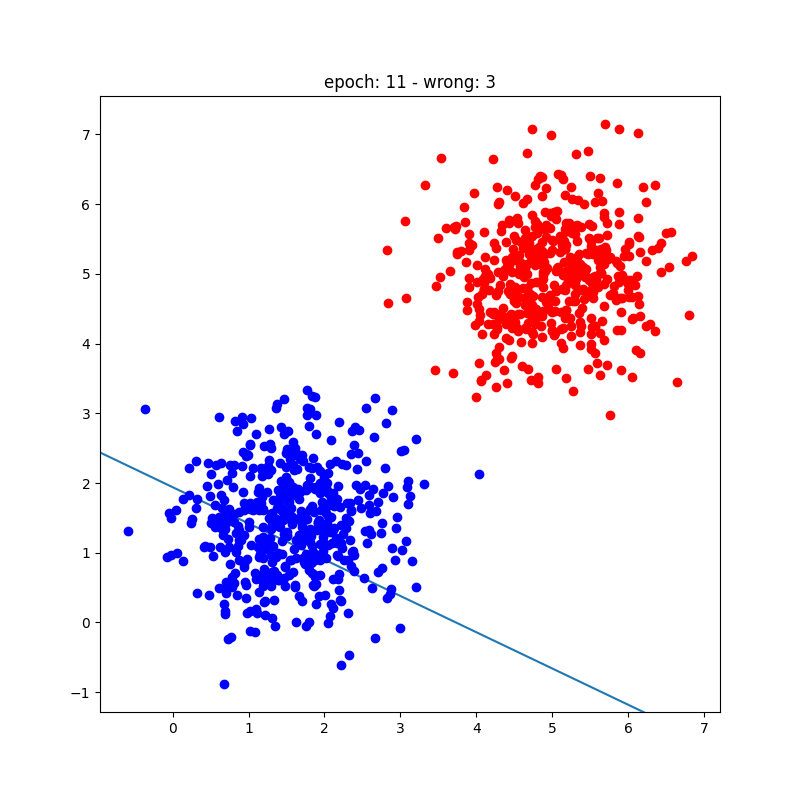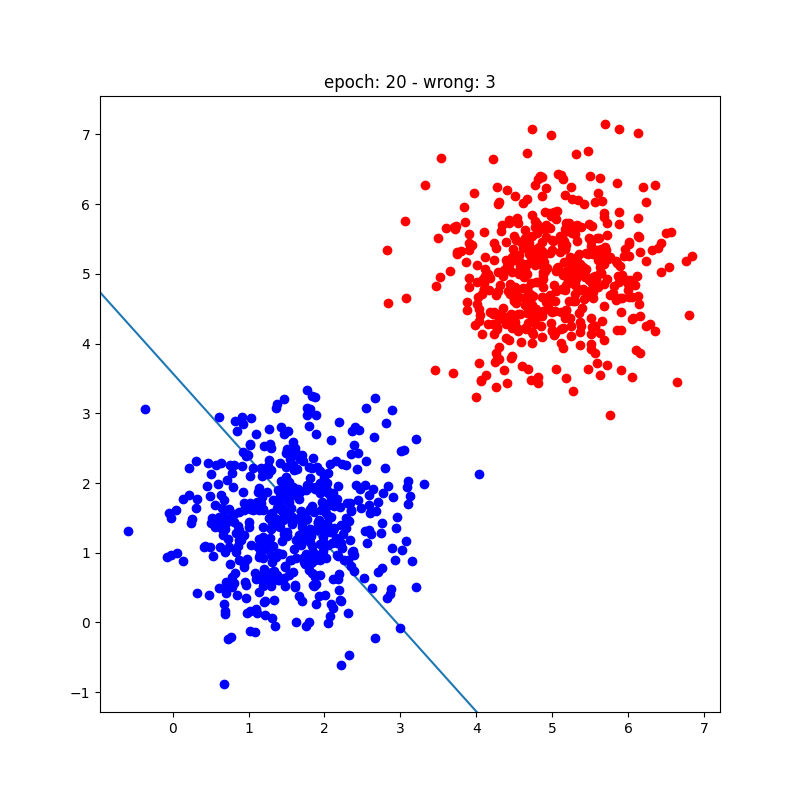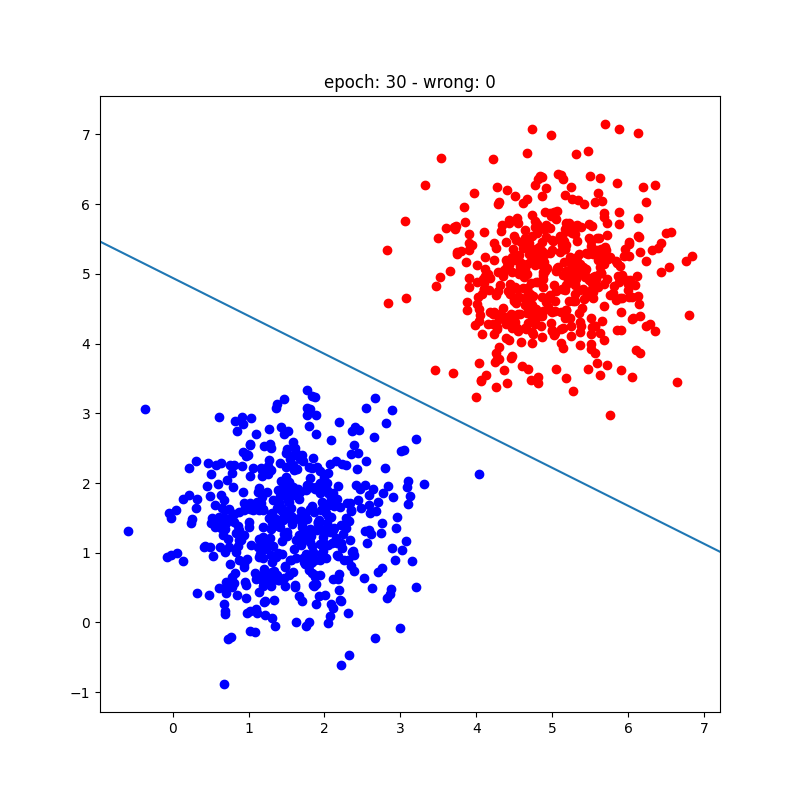
A fronteira de decisão é o hiperplano em que \( \mathbf{w} \cdot \mathbf{x} + b = 0 \). Para um dataset 2D (\( x_1, x_2 \)), isso é uma reta:
Durante o treinamento, os pesos e o bias são ajustados para mover essa reta de forma que ela separe as duas classes corretamente.
Considerações Práticas
- Pré-processamento: Normalize ou padronize as features de entrada para que fiquem em escalas parecidas, o que ajuda o perceptron a aprender melhor.
- Épocas: Defina um número máximo de épocas para evitar laços infinitos se os dados não são linearmente separáveis.
- Extensões: Para lidar com problemas multiclasse, use vários perceptrons (um-contra-todos) ou passe para modelos mais avançados, como MLPs ou máquinas de vetores de suporte (SVMs).
Limitações do Perceptron
Embora o perceptron seja um modelo fundamental em aprendizado de máquina, ele tem várias limitações:
-
Dados Linearmente Separáveis: O perceptron só resolve problemas em que as classes são linearmente separáveis. Se os dados não podem ser separados por uma reta (ou por um hiperplano em dimensões maiores), o perceptron não converge. Um exemplo clássico dessa limitação é o problema XOR5, que não pode ser resolvido por um perceptron de camada única.
-
Classificação Binária: O perceptron básico é projetado para tarefas de classificação binária. Embora possa ser estendido a problemas multiclasse com técnicas como um-contra-todos, ele não é naturalmente adequado à classificação multiclasse.
- Sem Estimativas de Probabilidade: O perceptron produz decisões binárias (0 ou 1) sem fornecer estimativas de probabilidade para suas predições. Isso pode ser uma limitação em aplicações em que é importante saber a confiança das predições.
- Sensibilidade à Taxa de Aprendizado: A escolha da taxa de aprendizado pode afetar significativamente o treinamento. Uma taxa alta demais pode fazer o algoritmo passar da solução ótima; uma taxa baixa demais pode levar a uma convergência lenta.
Playground Interativo: Treine um Perceptron
Clique na área abaixo para adicionar pontos (clique normal = Classe A, Shift+clique = Classe B). O perceptron atualiza os pesos a cada época com a regra de aprendizado de Rosenblatt.
Resumo
O algoritmo de treinamento do perceptron é um processo simples e iterativo que ajusta pesos e bias para minimizar erros de classificação em um dataset linearmente separável. Envolve inicializar parâmetros, calcular predições, calcular erros e atualizar pesos com base na regra de aprendizado do perceptron. Embora limitado a classificação binária e dados linearmente separáveis, é um conceito fundamental para entender redes neurais mais complexas.
-
McCulloch, W. S., & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. The Bulletin of Mathematical Biophysics, 5(4), 115-133. doi:10.1007/BF02478259 ↩
-
Rosenblatt, F. (1958). The Perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386-408. doi:10.1037/h0042519 ↩↩
-
Jurafsky, D., & Martin, J. H. (2025). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. ↩
-
Hebb, D. O. (1949). The organization of behavior: A neuropsychological theory. John Wiley & Sons. Reeditado pela Psychology Press (2002). doi.org/10.4324/9781410612403 ↩
-
Minsky, M., & Papert, S. (1969). Perceptrons: An introduction to computational geometry. MIT Press. ↩