Overview
Handout prático — Regularização na prática: fazendo uma rede parar de decorar
Um laboratório de duas horas que pega uma rede treinada de propósito para decorar o conjunto de treino e a transforma, uma técnica por vez, em uma rede que generaliza — medindo cada passo. Execuções reais, figuras vindas delas e checkpoints com solução.
Um modelo que acerta perfeitamente os dados de treino não é o objetivo — é um sinal de alerta. O que queremos de fato é um modelo que vá bem em dados que ele nunca viu e essas duas coisas puxam para lados opostos. Regularização é o nome de toda técnica que piora de propósito o ajuste no treino em troca de um ajuste melhor em todo o resto.
Formalmente, o treinamento minimiza a perda que conseguimos medir, sobre os \(N\) exemplos que por acaso temos:
mas o que nos interessa é a perda sobre toda a distribuição de onde os dados vieram, que não conseguimos medir:
A diferença \(R(\theta) - \hat{R}(\theta)\) é a lacuna de generalização e toda técnica deste capítulo é uma tentativa de mantê-la pequena.
Sobre o que é este capítulo
Cada seção abaixo responde a uma pergunta e elas foram escritas para serem lidas nesta ordem:
flowchart TD
    A["Erro de treino e de validação<br/>lidos juntos"] --> B{Qual falha?}
    B -->|"os dois altos"| C["Underfitting<br/>mais capacidade, treinar mais,<br/>regularizar menos"]
    B -->|"treino baixo,<br/>validação alto"| D["Overfitting"]
    D --> E["1. Mais dados<br/>ou aumento de dados"]
    D --> F["2. Restringir os pesos<br/>L2 / L1"]
    D --> G["3. Injetar ruído<br/>dropout, BatchNorm"]
    D --> H["4. Limitar a busca<br/>early stopping"]
    D --> I["5. Suavizar o alvo<br/>label smoothing, mixup"]
Nove simuladores rodam ao longo da página. Nenhum deles exige instalar nada — a ideia é justamente que você mova um controle e veja a falha aparecer e desaparecer antes de escrevermos uma única equação sobre ela.
Vendo acontecer
Nada explica overfitting melhor do que assistir a ele. Abaixo, 12 pontos com ruído são sorteados de uma função suave e um polinômio do grau que você escolher é ajustado a eles por mínimos quadrados. A linha tracejada é a verdade que queremos recuperar; os "×" são pontos separados que o ajuste nunca viu.
Três experimentos que valem a pena, nesta ordem:
- Grau 1, depois 3, depois 14, com \(\lambda = 0\). O grau 1 não consegue curvar. O grau 3 chega perto da verdade. O grau 14 passa por cima de cada ponto de treino — o erro de treino desaba para praticamente zero — e dá guinadas violentas entre eles. Isso é overfitting: não um modelo errado e sim um modelo que está certo sobre o ruído.
- Fique no grau 14 e aumente o \(\lambda\). Nada no modelo encolhe; ele continua com 15 coeficientes. Mas a curva selvagem se acalma e o erro fora da amostra cai. Capacidade nunca foi o problema — capacidade sem restrição era.
- Fique no grau 14, \(\lambda = 0\) e arraste o número de pontos para cima. O mesmo modelo que era inútil com 12 pontos fica razoável com 60. Mais dados também é regularização e é a mais eficaz de todas.
Verifique você mesmo — por que aumentar o λ conserta o grau 14, se o modelo continua com 15 coeficientes?
Porque capacidade não é a mesma coisa que capacidade usada. A penalidade não remove coeficientes, ela os torna caros: o ajuste ainda pode se contorcer o quanto quiser, mas só se a redução da perda pagar pelo crescimento dos pesos. Ajustar ruído compra quase nada em perda e custa caríssimo em norma, então deixa de valer a pena — enquanto o formato geral da curva, que compra muita perda por pouca norma, sobrevive. Capacidade nunca foi o problema; capacidade irrestrita era.
Acompanhe o ‖w‖² no rodapé
Percorra os graus com 12 pontos e siga os coeficientes: \(\lVert w \rVert^2\) vai de cerca de \(5\) no grau 3 para \(5\times10^{5}\) no grau 14. Coeficientes enormes de sinais alternados são exatamente como uma curva produz aquelas guinadas entre os pontos e é sobre essa observação que todo método de penalização deste capítulo é construído: com uma quantidade fixa de dados, pesos enormes são a assinatura de um modelo que está decorando.
A ressalva importa. Suba os dados para 60 pontos e o grau 14 generaliza bem ainda tendo uma norma enorme — ou seja, a norma sozinha não é um veredito e é por isso que limitantes baseados apenas no tamanho dos pesos explicam muito menos sobre redes profundas do que gostaríamos1.
Viés e variância
As duas falhas daquele simulador têm nome e vêm de decompor o erro esperado de um modelo em partes. Para a perda quadrática, em um ponto \(x\), tomando a média sobre todos os conjuntos de treino que poderíamos ter sorteado:
A porta de entrada clássica é um alvo de tiro. Fixe um ponto \(x\) e imagine treinar o mesmo modelo muitas vezes, cada vez com um sorteio diferente dos dados de treino, marcando onde cada um desses modelos cai. O centro do alvo é a verdade \(f(x)\); cada ponto é a previsão de um modelo.
As duas falhas são independentes — um modelo pode ter uma, as duas ou nenhuma — e é justamente por isso que vale a pena escrever a decomposição. Leia os três termos como três reclamações diferentes:
- Viés — o modelo erra sistematicamente, do mesmo jeito, não importa qual conjunto de treino ele receba. No alvo: a linha tracejada, do centro até onde os pontos caem em média. O ajuste de grau 1 é enviesado: ele não consegue curvar, então erra a curva sempre.
- Variância — o modelo muda radicalmente conforme o conjunto de treino que calhou de ver. No alvo: o espalhamento dos pontos em torno da própria média. O ajuste de grau 14 tem variância enorme: sorteie outros 12 pontos e você obtém uma curva completamente diferente.
- Ruído — a parte irredutível, \(\sigma^2 = 0{,}032\) no simulador. No alvo: uma rajada de vento a cada tiro — nenhuma mira elimina isso. Nenhum modelo vence esse termo e um modelo que fica abaixo dele nos dados de treino está ajustando ruído por definição.
A capacidade do modelo troca o primeiro pelo segundo e é esse o clássico tradeoff viés-variância:
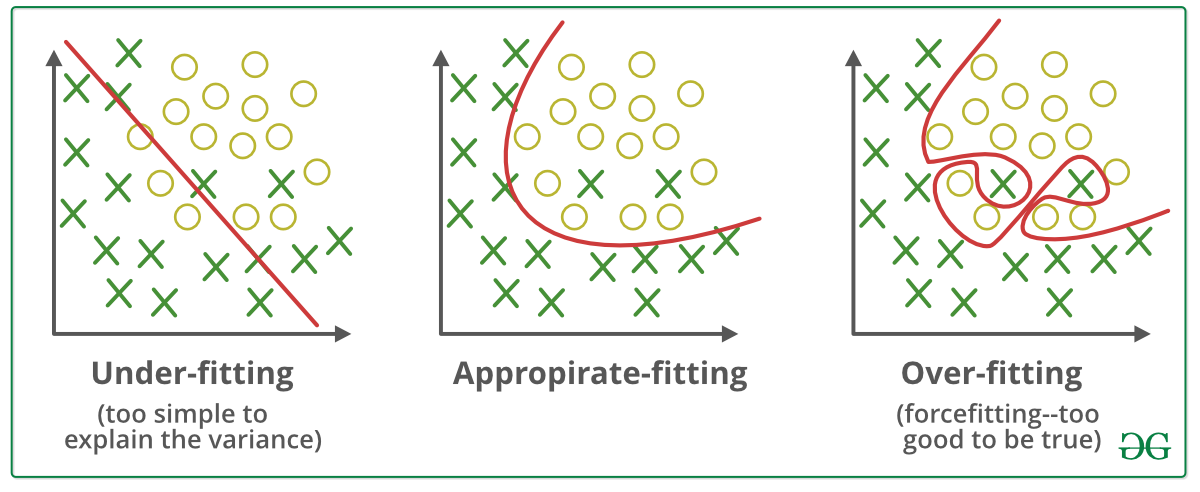
Underfitting e overfitting. Fonte: GeeksforGeeks2
Essa é a versão desenhada. A medida é esta. Para cada grau do polinômio, o mesmo ajuste é repetido em 140 conjuntos de treino diferentes, sorteados da mesma verdade e o erro em 41 pontos fora da amostra é separado nas duas parcelas da equação lá de cima — \(\big(\text{média} - \text{verdade}\big)^2\) e o espalhamento em torno dessa média:
O U é a curva branca e ele é um U por um motivo que agora dá para ver e não apenas afirmar: as duas curvas embaixo dele correm em direções opostas, então a soma precisa ter um fundo em algum lugar. Quatro coisas para fazer com ele:
- Leia as duas pontas. No grau 1 o erro é quase todo viés² — todo conjunto de treino produz mais ou menos a mesma curva errada. No grau 11 é quase todo variância — cada conjunto de treino produz uma curva diferente. Mesmo erro total, doenças opostas, remédios opostos.
- Aumente a penalidade L2. Aparece uma linha fantasma: o erro total sem ela. O braço direito do U se achata enquanto o esquerdo quase não se mexe — a penalidade compra uma redução grande de variância por um aumento pequeno de viés. Essa troca é o assunto inteiro deste capítulo.
- Arraste os pontos de treino de 12 para 60. O vale se alarga e o braço direito afunda: com mais dados, capacidade alta deixa de ser perigosa. Compare com o experimento 3 do primeiro simulador.
- Diminua o ruído σ. O ótimo anda para a direita — quanto menos ruído houver para ser confundido com sinal, mais capacidade você pode bancar.
Por que o grau 2 não é melhor que o grau 1
A curva de viés² tem um degrau plano ali e não é defeito: a verdade deste simulador, \(0{,}75\sin(2{,}6x) + 0{,}25x\), é uma função ímpar, então o coeficiente de \(x^2\) dela é zero. Acrescentar esse termo à base não compra redução de viés nenhuma — e ainda custa variância. É o exemplo pequeno mais limpo de um fato geral: capacidade só ajuda quando é capacidade na direção de que a verdade precisa.
-
Viés demais (underfitting)
Erro de treino e de validação altos e próximos um do outro.
- Aumente a capacidade: mais camadas, mais unidades.
- Treine por mais tempo — pode ser que você simplesmente não tenha convergido.
- Acrescente ou construa features; revise o pipeline de dados.
- Reduza a regularização que você já tem.
-
Variância demais (overfitting)
Erro de treino baixo, erro de validação bem mais alto. A lacuna é o sintoma.
- Mais dados, ou aumento de dados para simular mais dados.
- Penalize os pesos (L1/L2), acrescente dropout, pare cedo.
- Reduza a capacidade — último recurso, não o primeiro.
- Verifique se não há vazamento antes de acreditar em qualquer coisa disso.
A curva em U não é mais a história completa
O quadro clássico diz que o erro de teste cai, atinge um mínimo e sobe para sempre conforme a capacidade cresce. Redes modernas quebram isso: empurre a capacidade para além do ponto em que o modelo interpola perfeitamente o conjunto de treino e o erro de teste muitas vezes volta a cair, às vezes abaixo do primeiro mínimo. Isso é o duplo descenso34 e é por isso que "é só diminuir o modelo" é um conselho ruim para redes profundas. A curva que lhe ensinaram continua descrevendo o regime subparametrizado — a maioria das redes profundas simplesmente não vive nele.
Penalizando os pesos: L1 e L2
A lição do simulador foi que decorar exige coeficientes enormes. Então some o tamanho deles à perda e deixe o otimizador equilibrar os dois objetivos:
O gradiente da penalidade é \(\lambda w\), então um passo de gradiente vira
Cada passo multiplica os pesos por um fator um pouco menor que 1 antes de aplicar o gradiente — que é exatamente por que a mesma ideia se chama weight decay5. Um peso só sobrevive se o gradiente continuar empurrando-o de volta para cima, então a penalidade age como uma pressão constante rumo a zero, da qual os pesos úteis precisam se safar.
O gradiente da penalidade é \(\lambda\,\mathrm{sign}(w)\) — do mesmo tamanho por menor que \(w\) seja. Onde a L2 empurra proporcionalmente (e portanto empurra cada vez mais de leve conforme o peso encolhe), a L1 empurra com força constante até zero e segura ali.
O resultado são zeros exatos, não apenas valores pequenos: a L1 faz seleção de variáveis como efeito colateral da otimização6.
Por que a L1 dá zeros e a L2 não
Isso é mais fácil de ver do que de provar. Abaixo, as elipses são as curvas de nível da perda sem regularização e a região sombreada é o que a penalidade permite; a solução penalizada fica onde a menor elipse toca essa região. Arraste o ponto branco — o ótimo sem penalidade — e veja o que cada penalidade faz com ele.
As formas são o argumento inteiro. A região da L2 é um círculo, que é liso em todo ponto, então o lugar onde ele encosta pela primeira vez em uma elipse quase nunca cai sobre um eixo — as duas coordenadas terminam pequenas, mas vivas. A região da L1 é um losango e um losango é só quinas; as quinas ficam sobre os eixos e uma elipse que encolhe atinge uma quina vindo de uma faixa larga de direções. Isso é esparsidade: não um acidente numérico, mas consequência da forma.
Tente arrastar o \(\hat{w}\) para perto de um dos eixos e aumentar o \(\lambda\) — a solução da L1 gruda no eixo e fica lá, enquanto a da L2 desliza rumo à origem sem nunca chegar.
Verifique você mesmo — você quer descartar 90 de 100 variáveis de entrada. L1 ou L2?
L1. A L2 vai encolher os coeficientes inúteis em direção a zero sem nunca chegar lá, então você continua com 100 variáveis e sem um critério para dizer quais dez importam; teria de escolher um limiar na mão. A L1 coloca zeros exatos no vetor e faz a seleção por você — aquele canto do losango é toda a razão de preferi-la. Se você quiser a seleção e coeficientes estáveis entre variáveis correlacionadas, essa combinação é o elastic net: \(\lambda_1\lVert w\rVert_1 + \lambda_2\lVert w\rVert_2^2\).
Weight decay não é penalidade L2 quando você usa Adam
Somar \(\frac{\lambda}{2}\lVert w \rVert^2\) à perda e encolher os pesos por \((1-\eta\lambda)\) a cada passo são a mesma operação no SGD puro — como mostra a derivação acima. Elas deixam de ser a mesma coisa no instante em que o otimizador reescala o gradiente por parâmetro, porque a penalidade é reescalada junto. É exatamente esse o defeito que o AdamW corrige, tratado no capítulo de otimização. No PyTorch: torch.optim.AdamW(..., weight_decay=0.01) encolhe; Adam(..., weight_decay=0.01) penaliza e as duas coisas não significam o mesmo.
Não penalize tudo
Penalize matrizes de pesos. Deixe de fora os vieses (eles deslocam, não escalam e encolhê-los apenas enviesa a saída) e o ganho/deslocamento de toda camada de normalização (encolher o \(\gamma\) rumo a 0 briga justamente com aquilo que a camada existe para fazer). \(\lambda\) típico: \(10^{-5}\) a \(10^{-2}\) para CNNs treinadas com SGD, \(0{,}01\)–\(0{,}1\) para Transformers com AdamW.
Dropout: quebrar as co-adaptações
O dropout7 ataca uma falha diferente. Uma rede consegue decorar formando grupos co-adaptados de neurônios: detectores que só funcionam porque algum outro neurônio específico está ali para corrigi-los. Um comitê desses é frágil e é exatamente ele que falha em dados novos.
A solução é bruta. A cada passo de treino, cada unidade é apagada de forma independente com probabilidade \(p\):
Nenhuma unidade pode contar com a presença de outra, porque qualquer uma delas pode sumir no próximo passo. Cada neurônio é forçado a ser útil sozinho e a rede para de depositar toda a confiança em poucos caminhos frágeis.
Há uma segunda leitura da mesma equação. Cada máscara é uma sub-rede diferente e com \(n\) unidades existem \(2^n\) delas compartilhando pesos. Treinar com dropout treina esse conjunto inteiro um pouquinho de cada vez e testar sem dropout aproxima a média das previsões de todas — um ensemble pelo preço de um único modelo.
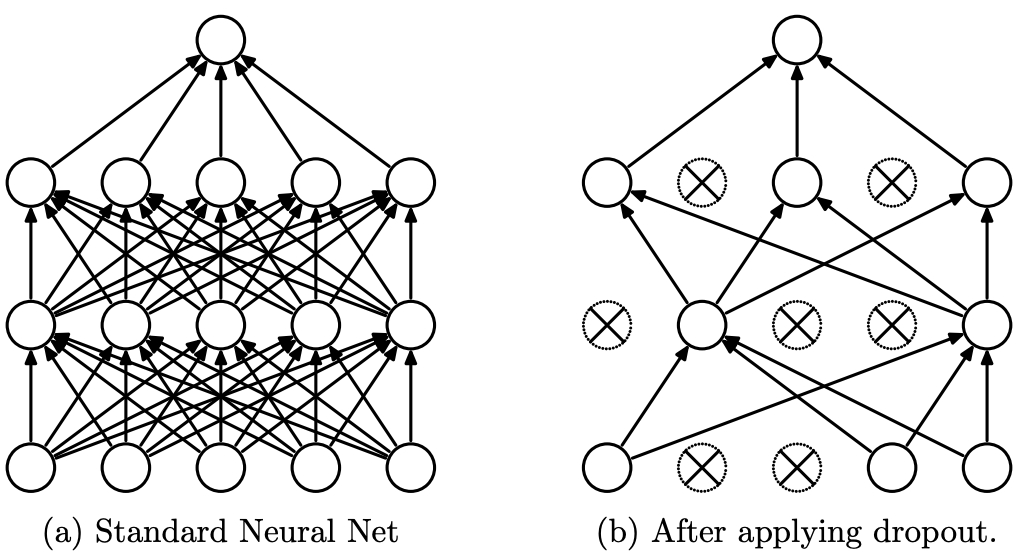
Esquerda: rede padrão com duas camadas ocultas. Direita: uma rede reduzida produzida pelo dropout; as unidades marcadas foram descartadas naquele passo. Fonte: Srivastava et al.7
O \(1/(1-p)\) que todo mundo erra
Apagar unidades no treino diminui o valor esperado do que a camada seguinte recebe. Isso precisa ser compensado e há duas formas de fazer:
| quando | o que acontece no teste | |
|---|---|---|
| Dropout original (o artigo de 20147) | multiplica os pesos por \(1-p\) no teste | a inferência precisa conhecer \(p\) e reescalar |
| Dropout invertido (o que todo mundo implementa) | divide por \(1-p\) durante o treino | nada — a inferência é uma passagem direta comum |
Todo framework em uso hoje faz a versão invertida e é por isso que o model.eval() simplesmente desliga o dropout em vez de reescalar coisa alguma. Veja a esperança sendo preservada:
Deixe rodando: a média da saída de treino converge para a saída de inferência, qualquer que seja o \(p\). É esse o sentido inteiro de dividir por \(1-p\) — a camada seguinte enxerga a mesma entrada esperada nos dois modos, então a rede que você treina é a rede que você põe em produção. Suba o \(p\) para 0,9 e veja a média demorar muito mais para assentar: dropout pesado preserva a média mas acrescenta uma variância enorme e é por isso que ele atrasa a convergência.
Esquecer o model.eval()
Dropout ativo na inferência torna as previsões aleatórias e a batch normalization continua atualizando as estatísticas correntes. É o bug mais comum em código de aluno — e ele não quebra nada, apenas piora os resultados em silêncio e os torna irreprodutíveis. Sempre model.eval() para validação e inferência, model.train() para voltar.
Onde o dropout é usado hoje
| Camadas totalmente conectadas | O território natural dele. \(p = 0{,}2\)–\(0{,}5\) |
| Camadas convolucionais | Raramente e com \(p\) pequeno; o compartilhamento de pesos já regulariza e a BatchNorm concorre |
| Transformers | Sim, mas com moderação (\(p = 0{,}1\) típico) nos blocos de atenção e MLP, além de stochastic depth |
| Camada de saída | Nunca |
| Camada de entrada | Ocasionalmente, com \(p\) pequeno (10–20%) — mais próximo de aumento de dados que de dropout |
Dropout e BatchNorm se desentendem
Juntos, eles brigam: o dropout muda a variância das ativações entre treino e inferência, enquanto a BatchNorm memorizou estatísticas do regime de treino. O descompasso está documentado8 e as regras práticas que saíram dali são pôr o dropout depois da camada de normalização, nunca entre a convolução e a BN e usar menos dos dois do que você usaria de cada um sozinho. Quando as arquiteturas modernas escolhem um, costumam escolher a normalização.
Camadas de normalização
A batch normalization9 padroniza a entrada de uma camada usando as estatísticas do mini-batch atual:
onde \(\mu_B\) e \(\sigma_B^2\) são a média e a variância sobre o batch, e \(\epsilon \approx 10^{-5}\) mantém a raiz longe de zero. O \(\gamma\) e o \(\beta\) aprendidos deixam a camada desfazer a normalização se for isso que ajuda — inclusive recuperando a identidade, de modo que a camada nunca custa poder de representação à rede.
O \(\epsilon\) vai dentro da raiz
\(\dfrac{x-\mu}{\sqrt{\sigma^2+\epsilon}}\) e não \(\dfrac{x-\mu}{\sigma+\epsilon}\). A segunda forma é um erro de digitação comum e não é equivalente: ela altera a escala de toda ativação por uma quantidade que depende de \(\sigma\), em vez de apenas proteger uma divisão.
Treino e inferência são contas diferentes
Esta é a parte que derruba as pessoas e vale ser exato aqui, porque é também de onde vem o efeito regularizador.
| estatísticas usadas | \(\gamma,\beta\) | estatísticas correntes | |
|---|---|---|---|
Treino (model.train()) | média/variância do batch atual | aprendidos | atualizadas |
Inferência (model.eval()) | médias correntes fixas, coletadas no treino | aprendidos | congeladas |
No treino, o valor normalizado de uma amostra depende de quais outras amostras caíram no batch dela — então a mesma imagem ganha uma representação um pouco diferente dependendo da companhia. Isso é ruído injetado na passagem direta e é por isso que a batch normalization regulariza. Na inferência o batch não existe e a rede precisa ser determinística, então as médias armazenadas assumem.
Repare no que isso não diz: a batch normalization não é "desligada" na inferência. Ela sempre roda — apenas troca quais estatísticas usa. Desligá-la mudaria a escala de toda ativação e destruiria o modelo.
Esse último parágrafo fica mais fácil de acreditar depois de ver. Abaixo, uma ativação fixa \(x^\star = 2,3\) é normalizada várias e várias vezes, cada vez dentro de um batch recém-sorteado. Nada na amostra muda — só a companhia dela.
O histograma laranja é o mesmo número calculado centenas de vezes e ele é largo. A linha verde é o que a inferência calcula — um valor, sempre. Duas coisas para testar:
- Arraste o B de 4 até 128. O histograma se aperta em torno do valor de inferência: batches maiores significam menos ruído e portanto menos regularização. É por isso que a batch normalization deixa de ajudar como regularizador em batches muito grandes e por que aí as pessoas recolocam o ruído por outro caminho.
- Volte para B = 4 e olhe a média do histograma, não só a largura. Com batches muito pequenos o valor de treino não é apenas ruidoso, ele é enviesado em relação ao que a inferência vai calcular — daí a BatchNorm degradar tanto com batches minúsculos e o GroupNorm ou o LayerNorm serem usados no lugar.
Verifique você mesmo — por que a BatchNorm regulariza e a LayerNorm não?
Porque o ruído vem da composição do batch, não da normalização. A LayerNorm normaliza cada amostra pelas próprias features: sorteie outro batch e nada no valor normalizado daquela amostra muda, então não há histograma para alargar — nada aleatório é injetado. Ela compra determinismo (treino e inferência fazem a mesma conta) e paga com o efeito regularizador.
Por que funciona — não pelo motivo dado originalmente
O artigo original explicava o benefício como redução do internal covariate shift: a deriva na distribuição de entrada de cada camada conforme as camadas abaixo aprendem. Essa história foi testada diretamente e não se sustentou — uma rede com ruído injetado de propósito depois da normalização, restaurando a deriva, treina igualmente bem10. A explicação atual é que a normalização deixa a superfície de perda mais suave e seus gradientes mais previsíveis, o que é o que permite taxas de aprendizado maiores. A técnica funciona; o mecanismo do resumo de 2015, não.
A passagem reversa: uma amostra mexe em todas
Na ida, \(\mu\) e \(\sigma^2\) saem do batch. Isso tem uma consequência que quase todo mundo erra ao implementar à mão: o gradiente de uma amostra não depende só dela. Mexer em \(x_i\) muda a média e a variância; com elas, muda o \(\hat{x}_j\) de todas as outras amostras do batch.
Escrevendo \(g_i = \gamma\,\partial L/\partial y_i\) e \(m\) para o tamanho do batch:
Os dois parâmetros da própria camada são mais simples: cada um soma, ao longo do batch, o gradiente que chega até ele.
As duas somas dentro de \(\partial L/\partial x_i\) são os dois caminhos extras: a primeira é o que passa pela média, a segunda é o que passa pela variância. Sem elas a conta vira \(g_i/\sigma\), que é o erro clássico de quem escreve a camada do zero — e ele não estoura, só treina pior.
Há uma conferência barata para essa fórmula: \(\sum_i \partial L/\partial x_i = 0\), sempre. Deslocar o batch inteiro não muda coisa alguma depois da normalização, então o gradiente não pode ter componente nessa direção. O script abaixo imprime essa soma e compara a fórmula com diferenças finitas.
"""A passagem reversa da batch normalization, conferida por diferenças finitas.

O ponto da conta: como μ e σ² dependem do batch inteiro, o gradiente de UMA amostra
carrega termos de TODAS as outras. É por isso que a forma compacta tem duas somas.
"""
import numpy as np

EPS = 1e-4

def forward(x, gamma, beta):
    mu, var = x.mean(), x.var()
    xhat = (x - mu) / np.sqrt(var + EPS)
    return gamma * xhat + beta, xhat, np.sqrt(var + EPS)

def backward(dy, xhat, sigma, gamma):
    m = dy.size
    g = dy * gamma                                    # ∂L/∂x̂
    dx = (m * g - g.sum() - xhat * (g * xhat).sum()) / (m * sigma)
    return dx, (dy * xhat).sum(), dy.sum()            # dx, dgamma, dbeta

x = np.array([1.0, 2.0, 3.0, 4.0])
dy = np.array([0.1, 0.2, -0.1, 0.3])
gamma, beta = 1.0, 0.0

y, xhat, sigma = forward(x, gamma, beta)
dx, dgamma, dbeta = backward(dy, xhat, sigma, gamma)

h, num = 1e-6, np.zeros_like(x)
for i in range(x.size):
    xp, xm = x.copy(), x.copy()
    xp[i] += h; xm[i] -= h
    num[i] = ((dy * forward(xp, gamma, beta)[0]).sum() - (dy * forward(xm, gamma, beta)[0]).sum()) / (2 * h)

np.set_printoptions(precision=4, suppress=True)
print("x       =", x)
print("x̂       =", xhat, " (média 0, desvio 1)")
print("dy      =", dy)
print("dx      =", dx)
print("dgamma  =", round(dgamma, 4), " dbeta =", round(dbeta, 4))
print("soma de dx =", round(dx.sum(), 12), " — sempre zero: deslocar o batch inteiro não muda x̂")
print("erro máximo contra diferenças finitas:", f"{np.abs(num - dx).max():.1e}")
x       = [1. 2. 3. 4.]
x̂       = [-1.3416 -0.4472  0.4472  1.3416]  (média 0, desvio 1)
dy      = [ 0.1  0.2 -0.1  0.3]
dx      = [ 0.0179  0.0805 -0.2147  0.1163]
dgamma  = 0.1342  dbeta = 0.5
soma de dx = 0.0  — sempre zero: deslocar o batch inteiro não muda x̂
erro máximo contra diferenças finitas: 1.7e-10
A LayerNorm é a mesma fórmula com as somas correndo sobre as features de uma amostra, em vez de sobre o batch. É literalmente a conta que o painel de profundidade do capítulo 9 executa em cada camada.
LayerNorm e por que os Transformers a usam no lugar
A batch normalization tem uma fraqueza estrutural: ela precisa de um batch. Isso quebra com batch de tamanho 1, com sequências de comprimento variável e faz treino e inferência se comportarem de forma diferente por construção.
A LayerNorm11 normaliza sobre as features de uma única amostra, em vez de sobre o batch:
Cada amostra passa a ser normalizada pelas próprias estatísticas. Não há nada a promediar no batch, então não há estatísticas correntes, treino e inferência são a mesma conta e o tamanho do batch é irrelevante. É por isso que todo Transformer a usa — e também por que a LayerNorm não regulariza: sem batch, não há ruído vindo da composição do batch.
A diferença entre as duas fica mais fácil de ver numa matriz concreta. Abaixo, as linhas são as amostras de um batch e as colunas são features. Clique numa célula e o contorno roxo marca os valores de onde vêm o \(\mu\) e o \(\sigma\) dela; a caixa embaixo escreve a conta, com \(\gamma = 1\) e \(\beta = 0\). Cada botão muda uma coisa só e conta o que ela fez com a saída da amostra 1, a linha laranja.
Quatro coisas para experimentar, cada uma isolando uma propriedade:
- Clique numa célula e alterne entre as duas. O grupo da BatchNorm é a coluna — uma feature ao longo do batch. O da LayerNorm é a linha — uma amostra ao longo das suas features. Mesma fórmula, outro eixo.
- Sorteie de novo as outras amostras. Na BatchNorm a saída da amostra 1 muda, embora a amostra 1 não tenha mudado: é o ruído que o histograma acima mostrou, feito da companhia dela. Na LayerNorm ela não muda nada.
- Arraste B até 1. A BatchNorm fica com um valor por coluna, que é a própria média: toda saída vira 0 e a entrada é apagada. O PyTorch se recusa a treinar assim e levanta um erro. A LayerNorm nem percebe.
- Multiplique a amostra 1 por 10 e depois ponha a feature 3 em milhares. Cada normalização é cega a exatamente uma dessas mudanças. A LayerNorm apaga a escala de uma amostra, então o ×10 deixa a saída dela idêntica. A BatchNorm apaga a escala de uma feature, então os milhares deixam todas as saídas idênticas. A outra paga a conta: na BatchNorm a amostra ×10 arrasta a média e o desvio de todas as colunas e o resto do batch se move junto; na LayerNorm a feature 3 toma conta do \(\sigma\) de cada amostra e as outras quatro features saem quase iguais, perto de \(-0{,}5\).
Esse último par é a regra prática. Quando as features vivem em escalas diferentes — dados tabulares, os canais de uma CNN — o que você quer são estatísticas por feature: a BatchNorm. Quando toda coordenada de um vetor é o mesmo tipo de grandeza e as amostras diferem no tamanho total — o embedding de um token — o que você quer são estatísticas por amostra: a LayerNorm, que ainda não traz dependência nenhuma do batch.
Parar cedo
Treine tempo suficiente um modelo com capacidade sobrando e ele vai começar a ajustar o ruído. A perda de validação registra o momento: ela cai junto com a de treino por um tempo, atinge o fundo e depois sobe enquanto a de treino continua descendo. Early stopping é a decisão de guardar o modelo do fundo dessa curva.
A receita tem três partes e a terceira é a que as pessoas esquecem:
- Avalie em uma partição de validação a cada época (ou a cada \(k\) passos).
- Paciência12 — quantas avaliações sem melhora você tolera antes de parar. Pequena demais e você desiste por causa de ruído; grande demais e você gasta computação depois do ponto sem volta.
- Restaure o melhor checkpoint. Parar não basta — os pesos que estão na memória quando você para são os piores, de
paciênciaépocas depois do mínimo. Guarde uma cópia do melhor.
Abaixo, um polinômio de grau 15 é ajustado a 10 pontos ruidosos por gradiente descendente puro. Nada é penalizado e nada é descartado; a única coisa que varia é quando você para.
O painel da direita é o ponto: um treino, dois modelos muito diferentes. A curva verde — a que você guarda — acompanha a verdade. A vermelha custou 160 vezes mais computação (20 000 épocas contra 125), passa por cima de cada ponto de treino e é pior em todo o resto. E a perda de treino dela é genuinamente menor. A armadilha é essa.
Verifique você mesmo — sua perda de validação ainda está caindo na última época. O early stopping foi inútil?
Não — ele te contou uma coisa: você treinou de menos. A curva nunca fez a volta, então o melhor checkpoint é o último e parar não mudou nada, que é exatamente a informação de que você precisava para justificar treinar mais. Early stopping custa uma partição de validação e nunca é um erro deixá-lo ligado; ele só não dispara sempre.
Early stopping é regularização, num sentido preciso
Não é um truque pregado por fora. Para um modelo linear treinado por gradiente descendente a partir de zero, parar depois de \(t\) passos entrega quase exatamente a solução ridge com \(\lambda \approx 1/(\eta t)\): o gradiente descendente pega primeiro as direções bem determinadas dos dados e por último as ruidosas e mal determinadas, então parar cedo deixa estas últimas perto de zero — a mesma coisa que a penalidade L2 faz explicitamente13. Treinar mais e regularizar menos são dois nomes para um só botão.
Mais dados e como fabricá-los
Volte ao primeiro simulador e arraste o número de pontos de 12 para 60 com grau 14 e sem penalidade. O modelo que era inútil fica bom. Nada no modelo mudou — a restrição veio dos dados. Vale dizer isso sem rodeios, porque reordena todas as prioridades deste capítulo: quando o problema é overfitting, mais dados é a melhor resposta disponível e todo o resto é o que se faz quando não dá para conseguir mais.
Muitas vezes dá para fabricar alguns, porém, explorando invariâncias que você já conhece:
Um gato rotacionado continua sendo um gato, então uma imagem de treino rotacionada é um exemplo extra de graça. Cada transformação que você aplica afirma uma invariância que o modelo deveria ter — e é por isso que aumento de dados é conhecimento de domínio disfarçado e por que a transformação errada atrapalha: espelhar dígitos horizontalmente ensina ao modelo que 2 e 5 são a mesma coisa.
train_tf = transforms.Compose([
    transforms.RandomResizedCrop(224, scale=(0.6, 1.0)),
    transforms.RandomHorizontalFlip(),          # um gato espelhado é um gato
    transforms.ColorJitter(0.3, 0.3, 0.3),      # um gato sob luz mais quente também
    transforms.ToTensor(),
])
val_tf = transforms.Compose([                   # nunca aumente a validação
    transforms.Resize(256), transforms.CenterCrop(224), transforms.ToTensor(),
])
Políticas automáticas (RandAugment14 e parentes) buscam o conjunto de transformações para você e hoje são padrão em visão.
Em vez de exigir probabilidade 1 na classe correta, exija \(1-\alpha\):
Com alvos one-hot, a entropia cruzada só é minimizada quando o logit correto vai para o infinito, o que é um convite direto ao excesso de confiança. O suavizamento (\(\alpha = 0{,}1\) tipicamente) dá ao ótimo uma posição finita15. Ele melhora acurácia e calibração de forma confiável — mas também colapsa a geometria da penúltima camada, o que atrapalha se você pretende usar aqueles embeddings para busca ou destilação16.
Treine com combinações convexas de pares de exemplos e de seus rótulos17:
com \(\lambda \sim \text{Beta}(\alpha, \alpha)\). Parece absurdo — imagens meio gato, meio cachorro, com rótulos meio a meio — e funciona, porque força o modelo a se comportar linearmente entre os exemplos de treino em vez de fazer qualquer coisa ali. Esse "qualquer coisa entre os pontos" era exatamente o que o polinômio com overfitting estava fazendo.
Label smoothing e mixup são mais fáceis de ver do que de descrever: um muda onde o alvo está, o outro muda quais exemplos existem.
À esquerda, arraste o \(\alpha\). Com \(\alpha = 0{,}05\) quase todo \(\lambda\) cai perto de 0 ou de 1 e os pontos misturados ficam colados em exemplos reais — uma edição leve. Com \(\alpha = 2\) o meio é sorteado com a mesma frequência e o conjunto de treino se enche de pontos que são genuinamente metade de cada classe. É por isso que \(\alpha\) entre 0,1 e 0,4 é a escolha usual em imagens: o bastante para suavizar o espaço entre exemplos, não o bastante para gastar o modelo em quimeras.
À direita, arraste o \(\varepsilon\). Com \(\varepsilon = 0\) o alvo é um 1 duro e o ótimo é uma diferença de logits infinita — a perda empurra para sempre, que é exatamente o que o excesso de confiança é. Qualquer \(\varepsilon > 0\) coloca o ótimo num lugar finito e alcançável.
Verifique você mesmo — mixup em dados médicos?
Pergunte o que significa meio exemplo. Meio gato e meio cachorro é uma imagem que ninguém jamais verá e tudo bem: o objetivo é só forçar o modelo a interpolar suavemente entre eles. Mas meio "benigno" e meio "maligno" afirma que um rótulo 50/50 é uma coisa que existe e ainda pode fundir exames de dois pacientes numa imagem anatomicamente impossível. Mixup é uma afirmação sobre a geometria do seu espaço de rótulos — confira se a afirmação é verdadeira antes de usá-lo.
Juntando tudo
Nenhuma técnica isolada é o regularizador; treinos reais empilham várias e elas não são intercambiáveis. Ordenadas pelo que de fato fazem:
| Mecanismo | Técnica | Onde ela se justifica |
|---|---|---|
| Restringir os pesos | L2 / weight decay | Quase sempre ligada. 1e-4 com SGD, 0,01–0,1 com AdamW |
| L1 | Quando você quer esparsidade ou seleção de variáveis; raro em redes profundas | |
| Injetar ruído | Dropout | Camadas densas, blocos de Transformer. \(p = 0{,}1\)–\(0{,}5\) |
| Batch normalization | CNNs — como efeito colateral; o trabalho principal dela é otimização | |
| Aumento de dados, mixup | Visão e áudio, onde as invariâncias são conhecidas. A alavanca mais forte depois de dados crus | |
| Limitar a busca | Early stopping | De graça, sempre. Custa uma partição de validação |
| Suavizar o alvo | Label smoothing | Classificação com muitas classes, \(\alpha = 0{,}1\) |
| Acrescentar dados | Mais dados rotulados | Vence todas as linhas acima. Tente isso primeiro |
E agora você pode empilhá-las por conta própria. O simulador abaixo treina uma rede de verdade — 2 → h → h → 1, tanh, gradiente descendente full-batch — em 40 pontos de duas luas entrelaçadas, dos quais 8% têm o rótulo errado. Cada controle é uma das técnicas acima; o painel da esquerda mostra a fronteira de decisão que o modelo de fato aprendeu e o da direita mostra as duas perdas.
Cinco experimentos, nesta ordem. Cada um leva uns quinze segundos:
- Tudo desligado. Treine com \(\lambda = 0\), \(p = 0\), \(\sigma = 0\) e 24 neurônios. Desmarque mostrar o modelo com early stopping para ver os pesos finais: a perda de treino continua caindo enquanto a de validação faz a volta e sobe e a fronteira cria uma ilhota em torno de cada ponto de rótulo trocado. Algo como 95% no treino contra 78% na validação.
- Marque a caixa de novo. Mesma execução, mesmo custo — mas ler os pesos da melhor época de validação, em vez da última, recupera acurácia de validação, de 78% para 81% neste sorteio dos dados. Isso é early stopping e não custou nada.
- Aumente o weight decay. Perto de \(\lambda \approx 10^{-2}\) as ilhotas se dissolvem e a fronteira vira uma curva suave só; a validação alcança o treino. Continue até o topo do controle e veja tudo desabar em underfitting: em algum momento a penalidade afoga também o sinal.
- Desligue o weight decay e aumente o dropout. \(p = 0{,}2\) ajuda. \(p = 0{,}4\) numa rede tão pequena a destrói — não sobra redundância para metade dos neurônios sumir. Dropout é técnica para redes com capacidade de sobra.
- Desligue tudo e arraste os pontos de treino de 40 para 200. A diferença se fecha sozinha, sem regularizador nenhum. É a ordem de prioridades deste capítulo em um experimento só.
Verifique você mesmo — a fronteira está suave, mas a validação está 15 pontos pior que o treino. E agora?
Nada desta página, ainda. Uma diferença grande e estável, com uma fronteira de aparência razoável, quase sempre quer dizer que os dois conjuntos não estão medindo a mesma coisa: uma validação pequena demais para ser confiável, uma mudança de distribuição entre as partições, ou vazamento. Confira a partição antes de buscar um regularizador — toda técnica daqui pressupõe que treino e validação vêm da mesma distribuição e nenhuma delas conserta uma partição quebrada.
Uma ordem sensata para tentar as coisas
- Faça o modelo dar overfitting primeiro. Um modelo que não consegue decorar um subconjunto pequeno tem um bug, não um problema de regularização — e nenhuma dose de dropout conserta um pipeline quebrado.
- Ligue as de graça: weight decay e early stopping.
- Acrescente aumento de dados se o domínio tiver invariâncias que você saiba nomear.
- Só então recorra a dropout, label smoothing, mixup — um de cada vez, medindo cada um.
- Diminua o modelo por último. Capacidade raramente é o problema real.
Lendo as duas curvas
| O que você vê | O que significa | O que fazer |
|---|---|---|
| Treino ↓, validação ↓, próximas | Saudável, ainda aprendendo | Continue treinando |
| Treino ↓, validação estaciona e ↑ | Overfitting daqui em diante | Pare cedo; regularize; consiga dados |
| Treino e validação altos e próximos | Underfitting | Mais capacidade, treino mais longo, menos regularização |
| Erro de treino ≫ validação (validação melhor) | Dropout/BN ainda ligados na avaliação, ou vazamento entre as partições | Cheque o model.eval() e a partição |
| Validação pulando muito | Conjunto de validação pequeno demais, ou taxa de aprendizado alta | Partição maior, η menor |
| Validação perfeita | Vazamento. Sempre vazamento | Audite como a partição foi construída |
Pontos-chave
- O alvo é a lacuna de generalização, não a perda de treino. Perda de treino zero é um sintoma a investigar, não uma conquista.
- Underfitting e overfitting se diagnosticam com dois números, nunca com um: erro de treino e erro de validação, lidos juntos.
- O overfitting aparece nos pesos — coeficientes enormes de sinais alternados — e é isso que faz penalizá-los funcionar.
- A L2 encolhe os pesos proporcionalmente e nunca chega a zero; a L1 empurra com força constante e produz zeros exatos. A diferença é a forma da região que cada uma permite.
- O dropout quebra co-adaptações e aproxima um ensemble de \(2^n\) sub-redes. As implementações modernas escalam por \(1/(1-p)\) durante o treino, então a inferência é uma passagem direta comum.
- A normalização ajuda primeiro a otimização e regulariza em segundo lugar; o ruído regularizador da batch norm vem da composição do batch, que é exatamente o que a LayerNorm abre mão.
- Early stopping não é um truque — para modelos lineares está provado que ele fica perto do ridge, com \(\lambda \approx 1/(\eta t)\).
- Mais dados vence tudo isso. Aumento de dados é a segunda melhor coisa, porque é mais dados construídos a partir do que você já sabia.
Recursos Adicionais
Três lugares para ir em seguida, na ordem que faz sentido:
-
Machine Learning Fundamentals: Bias and Variance — Starmer, J., StatQuest. Dez minutos sobre a decomposição com que este capítulo abre, em ritmo mais calmo e com outro conjunto de figuras. Assista primeiro se a seção de viés-variância pareceu abstrata:
-
A Recipe for Training Neural Networks — Karpathy, A. A contraparte prática desta página: a ordem em que realmente se fazem as coisas, por que você deve provocar overfitting em um único batch antes de qualquer outra coisa e um catálogo dos erros que parecem overfitting mas são bugs.
-
Deep Learning, capítulo 7 — Regularization for Deep Learning — Goodfellow, I., Bengio, Y., & Courville, A. O tratamento de referência, com as derivações que esta página só menciona — inclusive a prova de que early stopping e L2 coincidem em modelos lineares.
Referências bibliográficas
As obras citadas ao longo do texto, na ordem em que aparecem:
-
Zhang, C., Bengio, S., Hardt, M., Recht, B., & Vinyals, O. (2017). Understanding deep learning requires rethinking generalization — ICLR. Redes ajustam perfeitamente rótulos aleatórios, algo que nenhum limitante baseado no tamanho dos pesos prevê. ↩
-
Underfitting and Overfitting in Machine Learning — GeeksforGeeks. Fonte da figura acima. ↩
-
Belkin, M., Hsu, D., Ma, S., & Mandal, S. (2019). Reconciling modern machine-learning practice and the classical bias–variance trade-off — PNAS 116(32), 15849–15854. Onde a curva de duplo descenso foi batizada. ↩
-
Nakkiran, P., Kaplun, G., Bansal, Y., et al. (2021). Deep Double Descent: Where Bigger Models and More Data Hurt — ICLR. Mostra o efeito em redes reais, ao longo do tamanho do modelo, do conjunto de dados e do tempo de treino. ↩
-
Hoerl, A. E., & Kennard, R. W. (1970). Ridge Regression: Biased Estimation for Nonorthogonal Problems — Technometrics 12(1), 55–67. A penalidade L2, vinda da estatística, décadas antes do deep learning. ↩
-
Tibshirani, R. (1996). Regression Shrinkage and Selection via the Lasso — Journal of the Royal Statistical Society B 58(1), 267–288. A penalidade L1 e o argumento de esparsidade desenhado acima. ↩
-
Srivastava, N., Hinton, G., Krizhevsky, A., Sutskever, I., & Salakhutdinov, R. (2014). Dropout: A Simple Way to Prevent Neural Networks from Overfitting — Journal of Machine Learning Research 15(56), 1929–1958. Cuidado com a notação: no artigo, \(p\) é a probabilidade de manter uma unidade e por isso ele diz que os pesos são multiplicados por \(p\) no teste. Esta página usa \(p\) como a probabilidade de descartar, que é o que o
Dropout(p)de qualquer framework significa — daí o \(1-p\) aqui. ↩↩↩ -
Li, X., Chen, S., Hu, X., & Yang, J. (2019). Understanding the Disharmony between Dropout and Batch Normalization by Variance Shift — CVPR. Mede o descompasso e deriva as regras de posicionamento. ↩
-
Ioffe, S., & Szegedy, C. (2015). Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift — ICML. ↩
-
Santurkar, S., Tsipras, D., Ilyas, A., & Madry, A. (2018). How Does Batch Normalization Help Optimization? — NeurIPS. O experimento que desmonta a explicação do internal covariate shift. ↩
-
Ba, J. L., Kiros, J. R., & Hinton, G. E. (2016). Layer Normalization. ↩
-
Prechelt, L. (1998). Early Stopping — But When? — em Neural Networks: Tricks of the Trade, Springer LNCS 1524. Compara critérios de parada em treinos reais; as heurísticas de paciência ainda em uso vêm daí. ↩
-
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning, capítulo 7 — MIT Press. A seção 7.8 prova a equivalência entre early stopping e L2 para modelos lineares. ↩
-
Cubuk, E. D., Zoph, B., Shlens, J., & Le, Q. V. (2020). RandAugment: Practical Automated Data Augmentation with a Reduced Search Space — NeurIPS. ↩
-
Szegedy, C., Vanhoucke, V., Ioffe, S., Shlens, J., & Wojna, Z. (2016). Rethinking the Inception Architecture for Computer Vision — CVPR. A seção 7 introduz o label smoothing. ↩
-
Müller, R., Kornblith, S., & Hinton, G. (2019). When Does Label Smoothing Help? — NeurIPS. Confirma os ganhos e mostra o que ele faz com a penúltima camada. ↩
-
Zhang, H., Cissé, M., Dauphin, Y. N., & Lopez-Paz, D. (2018). mixup: Beyond Empirical Risk Minimization — ICLR. ↩