20. Stable Diffusion
Os capítulos 16 a 19 montaram as peças. Este capítulo é onde elas viram um sistema que se roda.
O Stable Diffusion4 não é uma ideia; são quatro, empilhadas e a pilha é o que fez a geração de imagens sair de uma demonstração de pesquisa que exigia um cluster para algo que roda num laptop:
- Um processo de difusão que transforma geração numa longa sequência de problemas fáceis de remoção de ruído.
- Um espaço latente, vindo de um VAE, para que essa sequência rode num espaço 48× menor que os pixels.
- Um encoder de texto, vindo do CLIP, para que se possa dizer ao processo o que fazer.
- Classifier-free guidance, para que ele de fato obedeça.
Os três primeiros aparecem na maioria das explicações. O quarto costuma ser pulado e é ele que transforma um modelo que tecnicamente se condiciona em texto num que obedece a um prompt.
Modelos de Difusão
Modelos de difusão são treinados para prever um jeito de tirar um pouco de ruído de uma amostra a cada passo; depois de iterações suficientes, um resultado aparece. A mesma maquinaria já foi aplicada a imagens, fala, formas 3D, moléculas e grafos.
-
Difusão direta
Leva dados a ruído perturbando-os aos poucos — um processo estocástico fixo, sem nada aprendido, que transforma uma amostra de dados em versões progressivamente mais ruidosas com um núcleo gaussiano.
Este processo é usado apenas no treino, nunca na inferência.
-
Difusão reversa
Desfaz aquilo, um pequeno passo por vez. Esta é a parte que se aprende e é o que transforma ruído aleatório em dados na inferência.
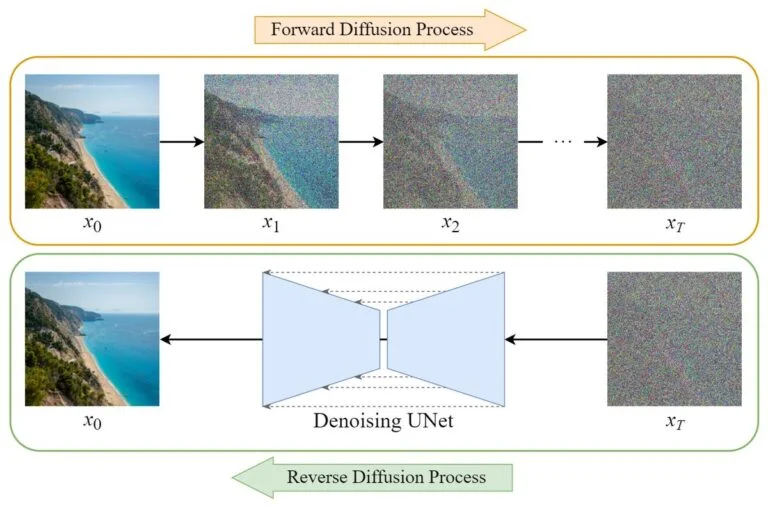
Visão geral do DDPM. Fonte: 12.
Difusão direta
Uma amostra \(x_0\) é corrompida com ruído gaussiano ao longo dos passos \(t = 1 \ldots T\):
onde \(\beta_t\) é o cronograma de ruído. Escrito assim parece um laço e seria inútil se fosse um. O passo que torna a difusão treinável é que a composição de todas aquelas gaussianas é ela própria gaussiana, de modo que qualquer nível de ruído é alcançado em forma fechada:
Sorteie um \(t\) aleatório, salte direto para lá e treine. Sem simular a cadeia, sem dependência sequencial entre exemplos de treino.
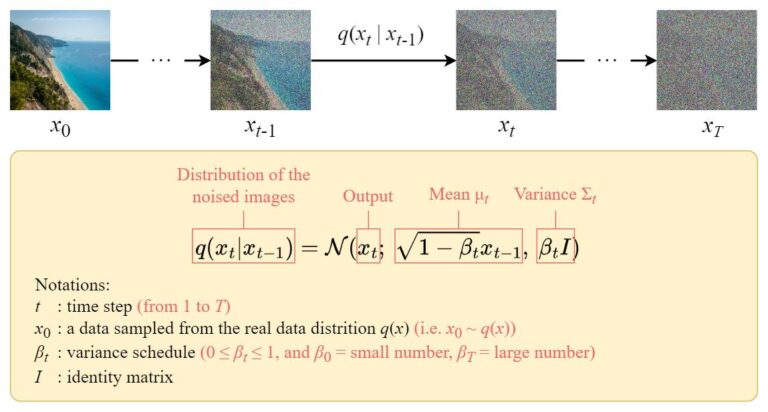
Difusão direta. Fonte: 12.
O objetivo de treino cabe numa linha
Dado isso, o que a rede deve prever? A resposta elegante e a que o DDPM2 adotou: preveja o ruído que foi acrescentado.
É só isso. Um erro quadrático médio entre dois vetores, em que o alvo é uma amostra de ruído gaussiano que você mesmo sorteou. É regressão supervisionada comum, que é precisamente o que uma GAN (capítulo 18) não tem e a maior razão isolada pela qual a difusão a deslocou: a perda desce e quando ela desce o modelo está melhor.
Prever ruído, prever a imagem e prever velocidade
Previsão de \(\epsilon\), de \(x_0\) e de \(\mathbf{v}\) são algebricamente intercambiáveis — dado \(x_t\) e o cronograma, qualquer uma dá as outras. Elas diferem apenas em como a perda é ponderada entre níveis de ruído e essa ponderação importa: a previsão de \(\epsilon\) degrada perto de \(t = T\), onde quase não sobra sinal para dividir e é por isso que a previsão de \(\mathbf{v}\) é padrão em alta resolução. Veja também o capítulo 21, onde o mesmo objeto reaparece como campo de velocidade.
Difusão reversa
Amostrar roda o processo de trás para frente:
Não podemos usar o verdadeiro \(q(x_{t-1} \mid x_t)\) — ele depende da distribuição dos dados e é intratável. A rede o aproxima e a U-Net13 é a arquitetura usual porque remover ruído exige tanto detalhe fino quanto estrutura global, que é exatamente o que um encoder–decoder com conexões de salto oferece.
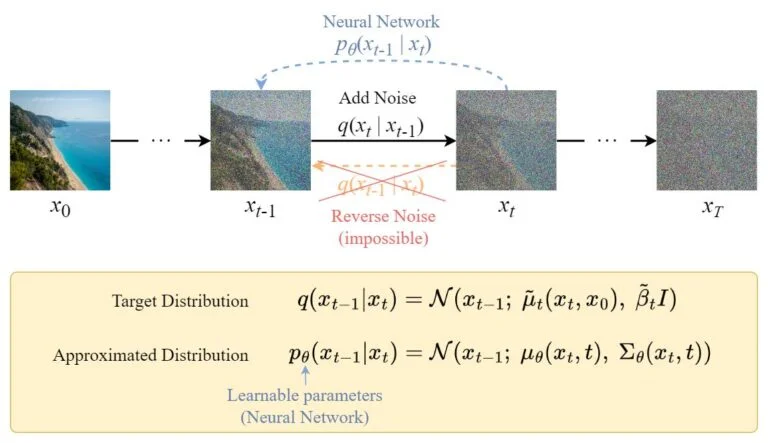
Difusão reversa. Fonte: 12.
Treinando a U-Net
Por passo: escolha um \(t\) aleatório para cada imagem, salte para aquele nível de ruído com a forma fechada acima, gere o embedding de \(t\) e regrida o ruído.
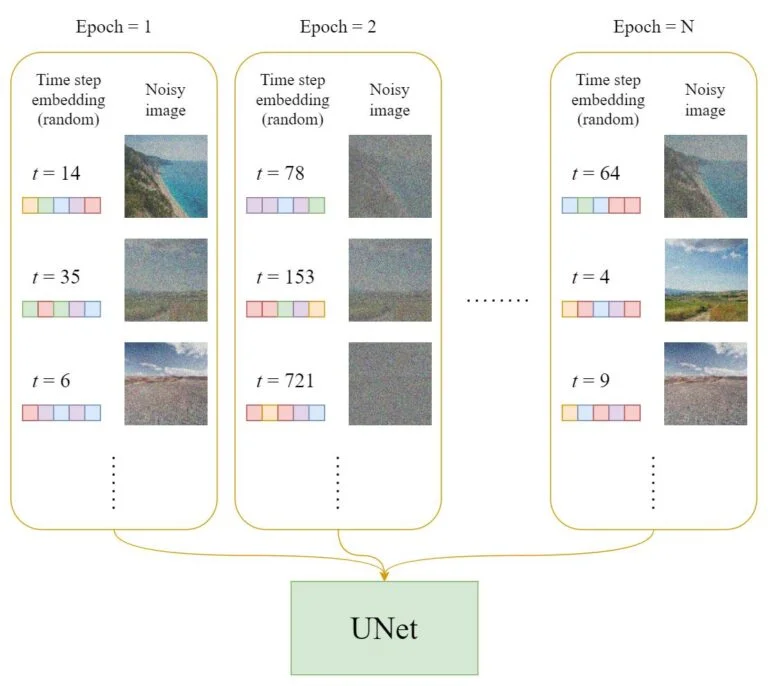
Preparando um lote de treino. Fonte: 8.
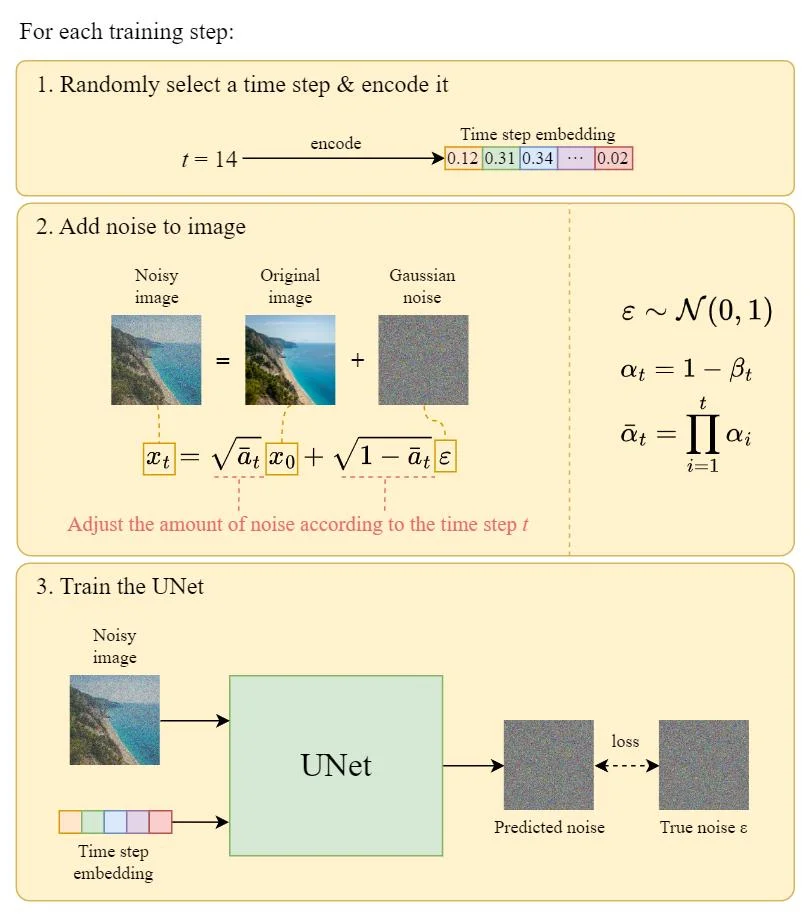
Um passo de treino. Fonte: 8.
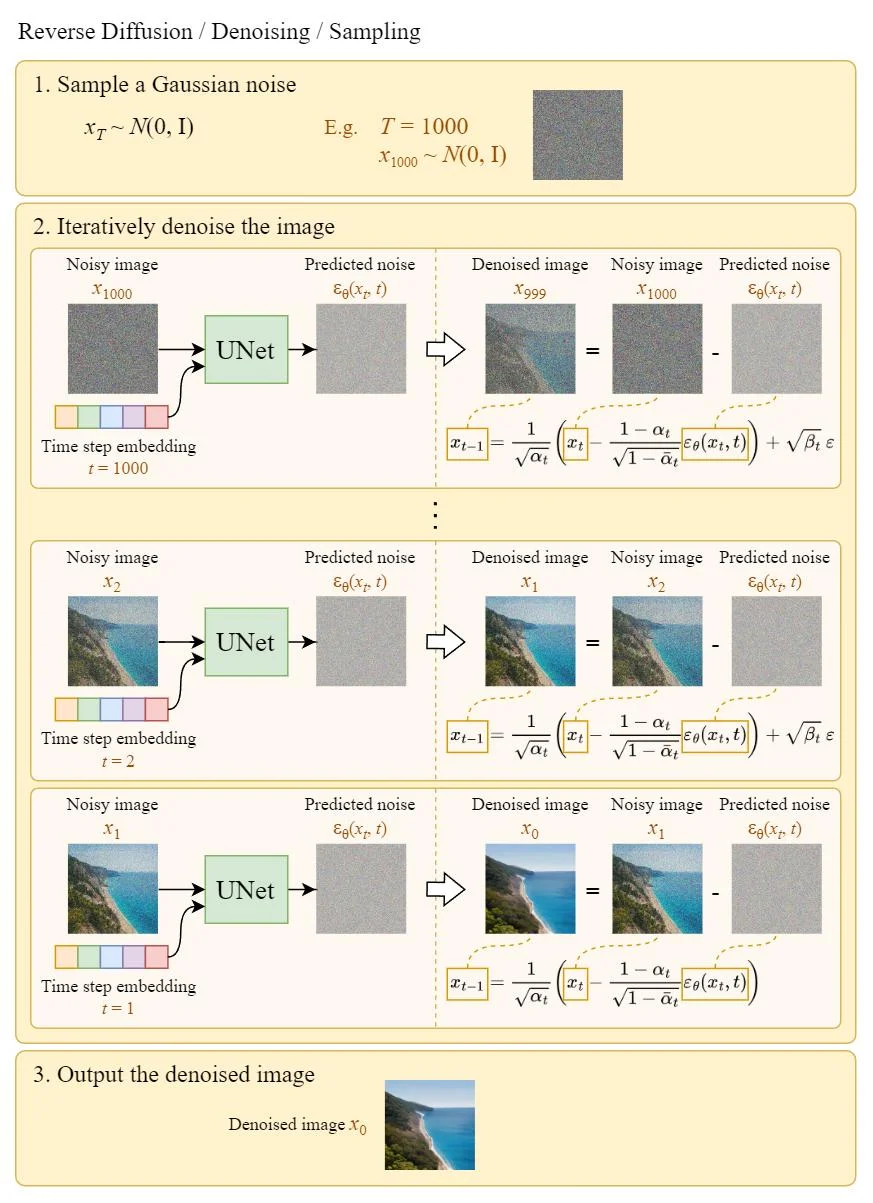
Amostragem, depois que a rede está treinada. Fonte: 8.
O cronograma de ruído não é um detalhe
O \(\beta_t\) decide quanto sinal sobrevive em cada \(t\) e portanto no que o modelo gasta seu orçamento de treino. Dois bugs bem conhecidos moram nessa única função.
SNR terminal. O Stable Diffusion 1.x entrega um cronograma linear escalado cujo \(\bar\alpha_T \approx 0{,}0047\) — não zero. O treino, portanto, sempre deixa um traço tênue da imagem real no último passo, enquanto a amostragem começa de ruído de verdade. O descompasso tem consequência famosa: o SD 1.x não consegue produzir uma imagem realmente preta ou realmente branca, porque o brilho médio do conjunto de treino vaza para o primeiro passo23. Reescalar o cronograma para SNR terminal zero resolve.
Resolução. Um nível de ruído não significa a mesma coisa em 512 px e em 1024 px: mais pixels significa mais redundância, então o mesmo \(\bar\alpha\) destrói proporcionalmente menos informação. Reaproveitar um cronograma de 512 px em resolução maior ruidifica de menos, nunca se pede ao modelo que resolva a parte formadora de estrutura e a saída parece uma repetição ladrilhada de uma imagem menor. O SD3 torna a correção explícita como um deslocamento de timestep dependente da resolução24.
Difusão latente: a ideia que a tornou acessível
Rodar difusão sobre \(512 \times 512 \times 3 = 786{.}432\) números, cinquenta vezes por imagem, não é algo que se faça numa GPU. A difusão latente4 move o processo inteiro para o espaço latente do VAE do capítulo 17:
| Pixels | Latente do SD 1.5 | |
|---|---|---|
| Formato | \(512\times512\times3\) | \(64\times64\times4\) |
| Números | 786.432 | 16.384 |
| — | 48× menos, por passo, nos 50 passos |
A divisão é o ponto: o autoencoder cuida do detalhe perceptual — textura, nitidez, altas frequências — e o modelo de difusão cuida de semântica e composição. Cada um faz a parte em que é bom e a parte cara roda no espaço pequeno.
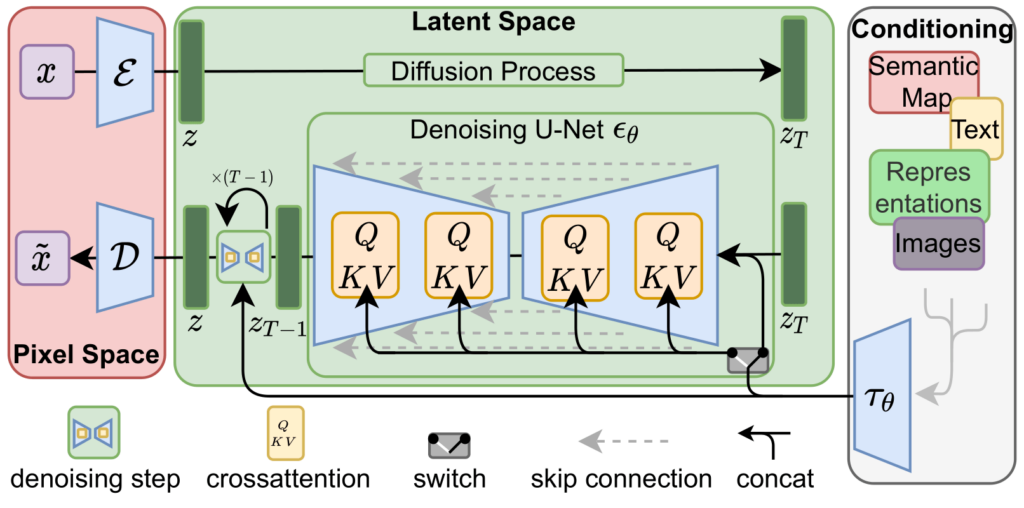
Difusão latente. Fonte: 6. Para percorrer o mesmo pipeline passo a passo com todos os intermediários à vista, o Diffusion Explainer do Polo Club15 é o melhor companheiro desta seção.
Os três componentes:
- Encoder de texto — o CLIP (capítulo 19) transforma o prompt numa sequência de embeddings. Congelado.
- U-Net — remove ruído do latente, com camadas de atenção cruzada em que a query vem do latente e chave/valor dos embeddings de texto (capítulo 11). É o único lugar por onde o prompt entra e é exatamente a atenção cruzada de um decoder Transformer.
- VAE — codifica para latentes no treino, decodifica para pixels no fim da amostragem. Congelado.
Marcos
graph TD
    A[2015: Conceito de Difusão] --> B[2020: Denoising Diffusion Probabilistic Models - DDPM]
    B --> C[2021: Denoising Diffusion Implicit Models - DDIM]
    C --> D[2021: Difusão Latente - LDM]
    D --> E[2022: Stable Diffusion v1<br>LDM + CLIP]
    E --> F[2022: SD 2.0]
    F --> G[2023: SDXL]
    G --> H[2024: SD3 / SD3.5]
    E --> I[<a href="https://github.com/lllyasviel/ControlNet" target="_blank">ControlNet</a>, <a href="https://arxiv.org/abs/2308.06721" target="_blank">IP-Adapter</a>, <a href="https://arxiv.org/abs/2106.09685" target="_blank">LoRA</a>]
    E --> J[Texto-para-3D: DreamFusion → Magic3D → ...]
    H --> K[2024: FLUX.1 — fluxo retificado + MMDiT]
    K --> L[2024-26: destilação de poucos passos<br>LCM · Turbo · Lightning]
    H --> M[2024-26: vídeo<br>SVD → difusão latente de vídeo classe Sora]
    click A "https://arxiv.org/abs/1503.03585" "Deep Unsupervised Learning using Nonequilibrium Thermodynamics"
    click B "https://arxiv.org/abs/2006.11239" "Denoising Diffusion Probabilistic Models"
    click C "https://arxiv.org/abs/2010.02502" "Denoising Diffusion Implicit Models"
    click D "https://github.com/CompVis/latent-diffusion" "Latent Diffusion Models"
    click E "https://huggingface.co/blog/stable_diffusion" "Stable Diffusion v1 Release"
    click F "https://stability.ai/news/stable-diffusion-v2-release" "Stable Diffusion 2.0 Release"
    click G "https://arxiv.org/abs/2307.01952" "SDXL: High-Resolution Image Synthesis with Latent Diffusion Models"
    click K "https://github.com/black-forest-labs/flux" "FLUX.1 by Black Forest Labs"
O pipeline, de ponta a ponta
Inferência
graph TD
    A[Prompt de Texto] --> B(Codificador de Texto CLIP)
    B --> C[Embedding de Texto]

    D[Ruído Aleatório<br><small>Latente</small>] --> E[Modelo de Difusão<br><small>UNet + Agendador</small>]
    C --> E

    E --> F[Imagem Latente<br><small>após desruidização</small>]

    F --> G(Decoder VAE)
    G --> H[Imagem Final<br><small>em pixels</small>]

    subgraph "Espaço Latente"
        D
        E
        F
    end

    style A fill:#a8e6cf,stroke:#333
    style B fill:#ffccbc,stroke:#333
    style C fill:#ffccbc,stroke:#333
    style D fill:#ffd3b6,stroke:#333
    style E fill:#dcedc1,stroke:#333
    style F fill:#dcedc1,stroke:#333
    style G fill:#c7ceea,stroke:#333
    style H fill:#c7ceea,stroke:#333
O processo de inferência envolve:
Classifier-free guidance: a parte que o faz obedecer
Um modelo treinado com pares (imagem, legenda) se condiciona em texto e se você amostrar dele honestamente a aderência ao prompt é decepcionante. Todo sistema texto-para-imagem que você já usou, portanto, faz algo que não é amostrar da própria distribuição.
Treine o modelo com a legenda descartada 10% das vezes, de modo que uma única rede aprenda tanto o score condicional \(\epsilon_\theta(x_t, c)\) quanto o incondicional \(\epsilon_\theta(x_t, \varnothing)\). Depois, a cada passo de amostragem, avalie os dois e extrapole além do condicional25:
Com \(w = 0\) você tem o modelo incondicional. Com \(w = 1\), amostragem condicional pura. Além disso você está amplificando a direção para a qual o prompt aponta — o que não é amostrar de nenhuma distribuição que o modelo aprendeu e funciona mesmo assim.
O painel varre o \(w\) e mede as três coisas que se contrapõem. A aderência ao prompt sobe rápido; a diversidade cai monotonicamente já a partir do primeiro passo além de 1; e, acima de mais ou menos 10, as amostras são empurradas para fora da variedade dos dados — o que, numa imagem real, é aquele visual saturado, queimado e de alto contraste que todo mundo reconhece numa escala de guidance de 20.
O guidance dobra seu custo de inferência
Duas passagens diretas por passo, uma das quais você calcula para depois subtrair. Metade da computação de toda imagem que você já gerou foi para o ramo incondicional. Destilar o guidance para dentro do modelo — de modo que uma única passagem produza a previsão guiada — é um dos truques padrão para tornar modelos de poucos passos rápidos.
Samplers: o mesmo modelo, de cinco a cinquenta passos
O treino te dá \(\epsilon_\theta\). Transformá-lo numa imagem é um problema numérico separado: integrar uma ODE ou SDE reversa e o solver é escolha sua. É por isso que o mesmo checkpoint roda com 50 passos ou com 20 quase sem diferença visível.
| Sampler | O que é | Passos típicos |
|---|---|---|
| DDPM2 | O amostrador ancestral estocástico original | 1000 |
| DDIM3 | Determinístico; reinterpreta o processo como ODE, então passos podem ser pulados. Também torna o mapa ruído→imagem invertível, que é o que a edição de imagens exige | 50 |
| Euler / Heun | Solvers de ODE comuns sobre o mesmo campo | 20–30 |
| DPM-Solver++26 | Um solver de integrador exponencial exato que explora a estrutura semilinear. O padrão prático | 15–25 |
| UniPC, DEIS | Variantes multipasso de ordem mais alta | 10–20 |
O número de passos é um botão e não é o único
Menos passos é mais barato e, em algum ponto, mais borrado ou estruturalmente errado. Samplers estocásticos corrigem erro acumulado e precisam de mais passos; determinísticos são reprodutíveis a partir da semente e mais baratos. Abaixo de ~10 passos nenhum solver salva — esse regime exige destilação, não um integrador melhor.
Destilação: de cinquenta passos para um
Uma linha de trabalho separada comprime a trajetória de amostragem para dentro dos pesos.
| Método | Ideia | Passos |
|---|---|---|
| Destilação progressiva27 | Treine um aluno a dar dois passos do professor de uma vez. Repita. | 50 → 4 |
| LCM / LCM-LoRA28 | Consistência: aprender um mapa de qualquer ponto da trajetória direto para o ponto final. Entregue como um LoRA que converte um modelo existente | 2–8 |
| SDXL-Turbo / ADD29 | Acrescente um discriminador — a perda de GAN do capítulo 18 — para que saídas de um passo pareçam reais em vez de médias | 1–4 |
| Lightning, Hyper-SD | Combinações dos anteriores | 1–8 |
Repare no que a última linha implica: a GAN, deslocada como geradora, voltou como aquilo que torna a difusão de tempo real possível. E repare no custo honesto — modelos de poucos passos trocam diversidade por velocidade, o que você percebe na hora se amostrar o mesmo prompt vinte vezes.
Controle: tudo que você de fato faz com isso
Texto é uma interface ruim para "coloque o sujeito aqui, nesta pose". Quatro mecanismos cobrem quase todo fluxo real:
| Mecanismo | O que faz | Como |
|---|---|---|
| img2img | Começar de uma imagem existente em vez de ruído puro | Codifique-a, some ruído até um \(t\) intermediário e remova o ruído a partir dali. A força é apenas em qual \(t\) você começa |
| Inpainting | Regerar uma região mascarada | A cada passo, substitua o latente não mascarado pelo original (com o ruído correto) |
| ControlNet21 | Condicionar em estrutura — um esqueleto de pose, um mapa de profundidade, um mapa de bordas | Uma cópia treinável da metade encoder, somada à U-Net congelada por convoluções inicializadas em zero, de modo que o treino começa como identidade |
| IP-Adapter22 | Condicionar numa imagem de referência — estilo ou identidade | Camadas extras de atenção cruzada que leem embeddings de imagem do CLIP |
| LoRA | Um estilo, um personagem, um conceito | Capítulo 14, aplicado às camadas de atenção da U-Net. É todo o ecossistema comunitário de fine-tuning |
O padrão comum a ControlNet, IP-Adapter e LoRA
Os três congelam o modelo base e acrescentam um pequeno caminho treinável inicializado para não fazer nada. É por isso que eles compõem — dá para empilhar um LoRA, um ControlNet e um IP-Adapter num mesmo checkpoint — e por que a comunidade consegue produzir milhares de adaptadores para um modelo que ninguém retreina. É a mesma ideia do capítulo 14, transplantada para um modelo generativo.
O que mudou depois do SD 1.5
O gráfico de marcos acima deixa de ser informativo por volta de 2023. Eis o que cada geração de fato mudou, o que é mais útil que os números de versão:
| SD 1.5 (2022) | SDXL (2023) | SD 3 / FLUX (2024) | |
|---|---|---|---|
| Backbone | U-Net, 860M | U-Net, 2,6B + refinador | MMDiT — um Transformer (capítulo 22) |
| Encoder de texto | CLIP ViT-L | Dois encoders CLIP | Dois CLIP + T5-XXL |
| Latente | 4 canais | 4 canais | 16 canais |
| Objetivo | previsão de \(\epsilon\), DDPM | previsão de \(\epsilon\) | Fluxo retificado (capítulo 21) |
| Tamanho nativo | 512² | 1024², múltiplas proporções | 1024²+, cronograma deslocado por resolução |
Quatro temas e nenhum deles é "mais parâmetros":
- A U-Net virou Transformer. Escala melhor e é uma arquitetura compartilhada com todo o resto do curso.
- Codificação de texto melhor. T5 ao lado do CLIP, porque a torre de texto do CLIP é pequena e se comporta como saco de palavras (capítulo 19) — exatamente por isso o SD 1.5 não escrevia nem lidava com prompts longos e composicionais.
- Um latente mais rico. 4 → 16 canais: menos perdido na compressão e é daí que veio texto legível em imagens geradas.
- A difusão virou flow matching. Caminhos mais retos, menos passos, objetivo mais simples. É o próximo capítulo.
De onde vieram os dados de treino
O SD 1.x foi treinado no LAION-5B: pares imagem-URL raspados do Common Crawl e filtrados por similaridade do CLIP (capítulo 19). Ninguém cujo trabalho está ali foi consultado. As consequências não são hipotéticas — litígio ativo sobre dados de treino, modelos que reproduzem sob demanda o estilo de um artista vivo com nome e sobrenome, memorização documentada de imagens individuais de treino e, em uma auditoria, material ilegal que forçou a retirada do conjunto do ar. Se você constrói sobre esses modelos, você herda tudo isso. Proveniência é uma propriedade de engenharia do seu sistema, não uma nota de rodapé.
Pontos principais
- A difusão transforma geração em muitos problemas fáceis de remoção de ruído e a forma fechada \(x_t = \sqrt{\bar\alpha_t}x_0 + \sqrt{1-\bar\alpha_t}\epsilon\) é o que torna o treino paralelo.
- A perda é um erro quadrático comum contra um ruído que você mesmo sorteou. Estável, monótona e a principal razão pela qual a difusão bateu as GANs.
- O cronograma de ruído decide o que o modelo aprende. SNR terminal não nulo é por que o SD 1.x não renderiza preto; a resolução muda o significado de um nível de ruído, daí o deslocamento de timestep.
- A difusão latente roda o processo num espaço 48× menor. O VAE cuida do detalhe, o modelo de difusão cuida da semântica.
- O classifier-free guidance é uma linha, dobra o custo de inferência e é o que faz o modelo obedecer ao prompt. Ele troca diversidade por aderência e em excesso empurra as amostras para fora da variedade.
- O sampler é uma escolha separada do modelo. DPM-Solver++ com 15–25 passos é o padrão prático; abaixo de ~10 passos você precisa de destilação, não de um solver melhor.
- A destilação chega a 1–4 passos e o método vencedor usa uma perda adversarial — a GAN voltando como componente.
- ControlNet, IP-Adapter e LoRA congelam a base e acrescentam um caminho inicializado em zero. É por isso que eles compõem.
- Desde o SD 1.5: backbone Transformer, encoders de texto melhores, latentes de 16 canais, fluxo retificado. Não "maior".
Adicional
DDPM vs DDIM
| Aspecto | DDPM | DDIM |
|---|---|---|
| Natureza | Probabilística | Determinística |
| Velocidade | Mais passos (mais lento) | Menos passos (mais rápido) |
| Qualidade | Alta variabilidade | Mais consistente |
Arquitetura U-Net
U-Net é uma arquitetura de rede neural convolucional originalmente projetada para segmentação de imagens biomédicas13. Foi amplamente adotada em várias tarefas de geração de imagens, incluindo modelos de difusão como o Stable Diffusion. A arquitetura U-Net é caracterizada por sua estrutura em formato de U, que consiste em um encoder (caminho de contração) e um decoder (caminho de expansão) com conexões de salto entre camadas correspondentes.
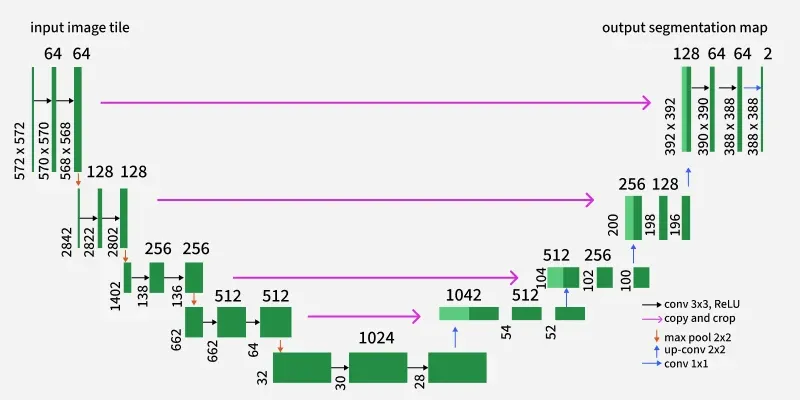
Arquitetura U-Net. Fonte: 14.
Vídeos
Deepia: Diffusion Models: DDPM | Generative AI Animated
Deepia: Score-based Diffusion Models | Generative AI Animated
-
Deep Unsupervised Learning using Nonequilibrium Thermodynamics, 2015. ↩
-
Latent Diffusion Models, 2021. ↩↩
-
Dagshub - Stable Diffusion: Best Open Source Version of DALL-E 2 ↩
-
Score-Based Generative Modeling through Stochastic Differential Equations ↩
-
U-Net: Convolutional Networks for Biomedical Image Segmentation ↩↩
-
GeeksForGeeks - U-Net Architecture Explained ↩
-
Stable Diffusion Models, by Ankit Kumar. ↩
-
Flow-Matching: A New Paradigm for Generative Modeling, 2022. ↩
-
Zhang, L., Rao, A., & Agrawala, M. (2023). Adding Conditional Control to Text-to-Image Diffusion Models — ICCV. ControlNet e a convolução inicializada em zero que torna seguro acrescentá-lo. ↩
-
Ye, H., et al. (2023). IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models. ↩
-
Lin, S., Liu, B., Li, J., & Yang, X. (2024). Common Diffusion Noise Schedules and Sample Steps are Flawed — WACV. Onde o bug do SNR terminal não nulo é diagnosticado e corrigido. ↩
-
Esser, P., et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis — ICML. SD3: MMDiT, fluxo retificado e o deslocamento de timestep dependente da resolução. ↩
-
Ho, J., & Salimans, T. (2022). Classifier-Free Diffusion Guidance — workshop NeurIPS. Duas linhas de método e um dos artigos de maior impacto da área. ↩
-
Lu, C., et al. (2022). DPM-Solver++: Fast Solver for Guided Sampling of Diffusion Probabilistic Models. ↩
-
Salimans, T., & Ho, J. (2022). Progressive Distillation for Fast Sampling of Diffusion Models — ICLR. ↩
-
Luo, S., et al. (2023). Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference. ↩
-
Sauer, A., Lorenz, D., Blattmann, A., & Rombach, R. (2023). Adversarial Diffusion Distillation. SDXL-Turbo. ↩
-
StreamDiffusion, sugerido por Pedro Fracassi. ↩