17. Variational Autoencoders
O VAE é o capítulo que as pessoas mais leem errado. Julgado como gerador de imagens, ele perdeu de forma decisiva: suas amostras borradas viraram piada. Julgado pelo uso em produção, é um dos modelos generativos mais empregados que existem: toda imagem de difusão latente que você já viu foi decodificada por um deles.
As duas afirmações são verdadeiras e a razão de as duas serem verdadeiras é o ponto deste capítulo. Um VAE não é bem um gerador. É um compressor com um espaço latente moldado e assim que você o enxerga desse jeito o borrão deixa de ser defeito e vira uma escolha de projeto que outra coisa corrige adiante.
Slides
Clique nos slides e use as setas ← → para navegar; F abre em tela cheia e P abre a visão do apresentador, com as notas. Os quatro simuladores desta página rodam dentro dos slides. Abrir os slides numa aba nova
Comece por um autoencoder e veja o que falta
Um autoencoder são duas redes prensadas contra um gargalo: um encoder \(E\) que leva a entrada a um código de baixa dimensão e um decoder \(D\) que traz de volta.
O gargalo é o mecanismo inteiro: a rede só reconstrói se o código preservar o que importa.
Nada obriga os códigos a se organizarem de forma sensata. A reconstrução só se importa que cada entrada vá para algum código que o decodificador consiga inverter, então os códigos se espalham para onde o treino os empurrou, deixando buracos entre eles. Escolha um ponto aleatório nesse espaço e o decodificador produz lixo, porque ele nunca foi treinado por perto.
Um autoencoder não gera e isso não é um detalhe técnico pequeno
Para amostrar é preciso ter uma distribuição de onde amostrar. Um autoencoder te dá um conjunto de pontos, não uma distribuição — sem densidade, sem prior, sem forma de saber quais regiões têm significado. O espaço latente é cheio de buracos e você não os enxerga. Tudo que o VAE acrescenta mira esse único problema.
Duas variantes que vale nomear
Autoencoders convolucionais usam CNNs nas duas metades. Para imagens isso não é detalhe — é o prior certo (capítulo 10) e é o que todo autoencoder latente de produção ainda usa.
Cada convolução de passo 2 divide a resolução por 2 e soma canais, então o latente ainda é uma imagem pequena com canais — a forma em que a difusão latente roda. Um guia com essas e outras variantes: 2.
Autoencoders com remoção de ruído e mascarados corrompem a entrada e pedem a versão limpa de volta. Essa mudança de objetivo é o que transformou autoencoders em ferramenta séria de aprendizado de representações — o MAE é essa ideia em escala de ViT e modelos de difusão, vistos de longe, são a mesma ideia com um contínuo de níveis de ruído.
O VAE: codifique uma distribuição, não um ponto
A correção é fazer o encoder produzir uma distribuição sobre códigos em vez de um único código e então empurrar essas distribuições na direção de um prior do qual você sabe amostrar.
O encoder tem duas cabeças, uma média \(\mu(x)\) e uma log-variância \(\log\sigma^2(x)\); um código é sorteado como \(z = \mu + \sigma \odot \epsilon\) e o decoder reconstrói. A perda tem os dois termos marcados no desenho: a reconstrução e uma KL que só depende das duas cabeças. A próxima seção deduz os dois.
À esquerda, um autoencoder: um ponto por entrada. À direita, um VAE: uma gaussiana por entrada. A sobreposição entre essas gaussianas é o que preenche o espaço entre os exemplos de treino — e é por isso que interpolar no latente de um VAE produz algo plausível e no de um autoencoder muitas vezes não. O desenho é esquemático; o painel do β mais abaixo mede o mesmo efeito numa rede treinada. Dois tutoriais percorrem essas ideias em PyTorch: um autoencoder1 e um VAE no Fashion-MNIST3.
O ELBO, um passo de cada vez
A perda do VAE não é uma receita que alguém ajustou até funcionar. Ela sai de uma pergunta e de uma identidade. Cada termo dela tem uma função que dá para nomear. São cinco passos.
1. O que gostaríamos de maximizar
Um modelo generativo é uma história de como os dados são feitos: sorteie um código \(z \sim p(z)\) e depois sorteie uma imagem do decoder, \(x \sim p_\theta(x \mid z)\). A melhor história é a que torna mais prováveis os dados que de fato temos — máxima verossimilhança, o mesmo princípio por trás de toda perda deste curso. Para uma imagem, a quantidade é
Esse número se chama evidência (evidence): o quanto o modelo acredita em \(x\). É o E de ELBO.
O problema é a integral sobre todos os códigos possíveis. Dá para tentar estimá-la sorteando códigos do prior e tirando a média de \(p_\theta(x \mid z)\), só que quase todo \(z\) sorteado do prior não tem nada a ver com este \(x\) — um código aleatório decodifica em outro dígito — e a média acaba decidida por um punhado de amostras raras e sortudas. Os códigos que importam para \(x\) são os que a posterior aponta:
Só que calcular a posterior exige o denominador \(p_\theta(x)\), justamente o número que procurávamos. O problema é circular.
2. Chute a posterior e depois meça o chute
Quebre o círculo com uma aproximação. O encoder produz um chute gaussiano para a posterior,
("variacional" quer dizer apenas escolher o melhor membro de uma família de distribuições). Agora escreva a evidência usando \(q\). Cada linha é uma igualdade, não uma aproximação:
- \(\log p_\theta(x)\) não depende de \(z\), então a média dele sob \(q\) é ele mesmo.
-
Bayes, isolando a evidência. Vale para qualquer \(z\):
\[ p(z \mid x) = \frac{p_\theta(x, z)}{p_\theta(x)} \quad\Longrightarrow\quad p_\theta(x) = \frac{p_\theta(x, z)}{p(z \mid x)} \] -
Multiplique e divida por \(q_\phi(z \mid x)\) dentro do log e separe o log em dois.
- O segundo termo é a definição de \(\text{KL}(q \,\|\, p) = \mathbb{E}_q[\log q - \log p]\).
Três consequências de uma linha
- Uma KL nunca é negativa, então ELBO \(\leq \log p_\theta(x)\): ele é um limite inferior da evidência — o Evidence Lower BOund.
- A folga é exatamente o quanto o chute do encoder está errado. Quando \(q\) é igual à posterior verdadeira, o limite é justo.
- Subir o ELBO faz dois trabalhos ao mesmo tempo. Em relação ao encoder \(\phi\) ele só pode diminuir a folga, porque \(\log p_\theta(x)\) não depende de \(\phi\). Em relação ao decoder \(\theta\) ele empurra o próprio \(\log p_\theta(x)\) para cima. Um objetivo treina as duas redes.
3. Separe nos dois termos que você vai programar
Escreva \(p_\theta(x, z) = p_\theta(x \mid z)\,p(z)\) dentro do ELBO e ele se separa em duas esperanças que conseguimos calcular:
| Termo | O que mede | Se fosse o único termo |
|---|---|---|
| Reconstrução | quão bem um código sorteado de \(q\) explica \(x\) | \(\sigma \to 0\) e os códigos vão para qualquer lugar: um autoencoder |
| KL até o prior | quão longe a nuvem do encoder para \(x\) está de \(\mathcal{N}(0, I)\) | \(q = p(z)\) para todo \(x\) e o código não diz nada: colapso do posterior |
Duas KLs diferentes
A KL desta fórmula é até o prior \(p(z)\), que nós escolhemos e conhecemos. A KL do passo 2 é até a posterior \(p(z \mid x)\), que não conseguimos calcular — ela é a folga e o ELBO nunca precisa dela. Confundir as duas é a confusão mais comum sobre VAEs.
O mapa abaixo junta tudo o que apareceu até aqui: de onde vem cada termo, o que é do modelo \(p\) e o que é do chute \(q\), o que dá para calcular e o que não dá. Avance pelos passos ou passe o mouse numa caixa.
4. Um ELBO que dá para calcular na mão
Pegue um modelo pequeno o bastante para ser resolvido exatamente: um código 1-D, o prior \(p(z) = \mathcal{N}(0, 1)\), um decoder que multiplica por 2 e soma ruído unitário (\(p(x \mid z) = \mathcal{N}(2z, 1)\)) e uma observação, \(x = 3\). Como tudo é gaussiano, os dois números que são intratáveis num VAE de verdade estão disponíveis aqui:
- Evidência. \(x = 2z + \text{ruído}\) é gaussiano com variância \(2^2 + 1 = 5\), então \(\log p(3) = -\tfrac12 \log(2\pi \cdot 5) - \tfrac{9}{10} = -2.6237\).
- Posterior. \(p(z \mid x = 3) = \mathcal{N}\big(\tfrac{2 \cdot 3}{5},\ \tfrac15\big) = \mathcal{N}(1.2,\ 0.2)\).
Para um chute \(q = \mathcal{N}(m, v)\) os dois termos do ELBO têm forma fechada:
Repare no \(4v\): quanto mais largo o chute, mais o código sorteado erra e mais a reconstrução paga. É o cabo de guerra num símbolo só — a reconstrução quer \(v \to 0\) e a KL quer \(v \to 1\).
Uma linha por extenso, para o chute \(q_C = \mathcal{N}(1,\ 0.5^2)\):
e quatro chutes lado a lado:
q | E_q[log p(x∣z)] | KL(q ‖ p(z)) | ELBO | log p(x) - ELBO |
|---|---|---|---|---|
q_A = prior N(0, 1) | -7.4189 | 0.0000 | -7.4189 | 4.7953 |
q_B = point N(1.5, 0.1^2) | -0.9389 | 2.9326 | -3.8715 | 1.2479 |
q_C = guess N(1, 0.5^2) | -1.9189 | 0.8181 | -2.7371 | 0.1134 |
q* = p(z∣x) N(1.2, 0.2) | -1.4989 | 1.1247 | -2.6237 | 0.0000 |
log p(x) | -2.6237 |
À esquerda, a posterior verdadeira e três chutes. À direita, o \(-\)ELBO de cada chute é \(-\log p(x)\) mais uma folga (gap) e a folga é \(\text{KL}(q \,\|\, p(z \mid x))\) — a distância até a curva preta da esquerda. Gerada por elbo-gap.py.
Leia as linhas como os três personagens deste capítulo:
- O prior paga KL zero e a reconstrução dele é péssima: o chute não diz nada sobre \(x\). É o colapso do posterior em miniatura.
- O ponto \(q_B\) tem a melhor reconstrução de todas — ele fica em \(z = x/2 = 1.5\), que decodifica exatamente em \(x\) — e paga 2.93 nats de KL por ser tão estreito. É o autoencoder e o ELBO dele é pior que o de um chute modesto como \(q_C\).
- A posterior não tem nem a melhor reconstrução nem a menor KL. Ela tem o melhor ELBO e esse ELBO é exatamente \(\log p(x)\): a folga fechou.
O ELBO não premia a melhor reconstrução. Ele premia a melhor troca.
5. Do ELBO à perda que você programa
Troque o sinal — otimizadores minimizam — e faça três substituições:
- A esperança vira uma amostra. \(\mathbb{E}_q[\cdot]\) é estimada com um único \(z = \mu + \sigma\epsilon\) por imagem — o truque da reparametrização, logo abaixo. O passo 2 do lab mostra por que uma amostra basta.
- \(-\log p_\theta(x \mid z)\) vira uma perda conhecida, conforme o que se assume sobre os pixels. Um decoder gaussiano \(\mathcal{N}(\hat{x}, \sigma_x^2 I)\) dá \(\frac{1}{2\sigma_x^2}\|x - \hat{x}\|^2 + \text{const}\) — o erro quadrático. Um decoder de Bernoulli (pixels em \([0,1]\), saída sigmoide) dá a entropia cruzada binária. A fórmula abaixo descarta o \(\frac{1}{2\sigma_x^2}\); escolher outro \(\sigma_x\) é o mesmo que reescalar o \(\beta\).
-
A KL é escrita em forma fechada. Para uma dimensão:
\[ \begin{aligned} \text{KL}\big(\mathcal{N}(\mu, \sigma^2)\,\|\,\mathcal{N}(0,1)\big) &= \mathbb{E}_q\big[\log q(z) - \log p(z)\big] \\ &= \mathbb{E}_q\Big[-\tfrac12\log\sigma^2 - \tfrac{(z-\mu)^2}{2\sigma^2} + \tfrac{z^2}{2}\Big] \\ &= \tfrac12\big(\mu^2 + \sigma^2 - 1 - \log\sigma^2\big) \end{aligned} \]usando \(\mathbb{E}_q[(z-\mu)^2] = \sigma^2\) e \(\mathbb{E}_q[z^2] = \mu^2 + \sigma^2\). As duas distribuições são diagonais, então as dimensões simplesmente se somam.
O resultado é a perda que toda implementação de VAE calcula7:
Com \(\beta = 1\) ela é o ELBO negativo a menos de uma constante, para um decoder com \(\sigma_x^2 = \tfrac12\). A KL só tem forma fechada porque as duas distribuições são gaussianas e essa é a única razão pela qual tudo isso é prático. E o \(\beta\) — o peso entre os dois termos5 — é onde mora todo o comportamento.
Em código, para um lote de \(B\) imagens achatadas em 784 pixels e um latente de \(d\) dimensões:
| Tensor | Formato | |
|---|---|---|
x, x_hat | \((B, 784)\) | a entrada e a reconstrução dela |
mu, logvar, eps, z | \((B, d)\) | uma gaussiana por imagem; um \(\epsilon\) novo por imagem e dimensão |
| reconstrução, KL | \((B,)\) | somadas sobre os pixels e sobre as dimensões latentes |
| perda | escalar | média sobre o lote |
Some sobre os pixels e tire a média sobre o lote. Tirar a média também sobre os pixels (reduction="mean" no PyTorch) divide a reconstrução por 784 e multiplica o \(\beta\) por 784 sem avisar.
A mesma conta no exemplo resolvido, como o laboratório a escreve, linha a linha: \(K\) códigos pelo truque, os log-pesos, a média deles (o ELBO), a KL em forma fechada, a perda e o limite ponderado por importância da seção 7 do laboratório. O caso inicial é \(q_C\), então a coluna exata bate com a tabela acima; troque para os outros três chutes da tabela e veja qual linha muda:
O β é a história inteira
O painel abaixo treina um VAE de verdade no seu navegador: duas camadas ocultas, o truque da reparametrização, Adam. Mova o \(\beta\), aperte retreinar e observe três coisas ao mesmo tempo — quão bem ele reconstrói, que forma o latente assume e a única pergunta que importa para geração: uma amostra de \(\mathcal{N}(0, I)\) decodifica em algo real?
Três regimes e todo VAE que você treinar estará em algum ponto entre eles:
- \(\beta \to 0\) — um autoencoder comum. A reconstrução é quase perfeita e cerca de 90% das amostras do prior decodificam em nada. É a falha que o termo KL existe para evitar, tornada visível.
- \(\beta\) numa faixa boa e estreita — o latente casa com o prior o bastante para amostrar e ainda carrega informação suficiente para reconstruir.
- \(\beta\) grande demais — colapso do posterior. A forma mais barata de satisfazer uma penalidade KL grande é o encoder ignorar a entrada e devolver \(\mathcal{N}(0,I)\) para tudo. A KL vai a zero, o decodificador não tem em que se condicionar e ele emite a média do conjunto. A perda parece estar caindo.
Você já encontrou os três no exemplo resolvido. O ponto \(q_B\) é aonde \(\beta \to 0\) leva: só reconstrução, nenhuma consideração pelo prior. O próprio prior é aonde \(\beta \to \infty\) leva: KL zero e um código que não diz nada. A posterior verdadeira é a resposta para \(\beta = 1\). O passo 4 do lab resolve o melhor \(q\) para cada \(\beta\) em forma fechada e o vê deslizar de um extremo ao outro.
Como reconhecer o colapso do posterior
KL perto de zero e erro de reconstrução perto da variância dos seus dados. Registre os dois termos separadamente, sempre — uma perda total que cai não diz nada sobre qual dos dois está vencendo. As mitigações padrão são annealing da KL6 (comece com \(\beta\) em 0 e suba) e free bits (não penalize a KL de uma dimensão abaixo de um piso pequeno, como meio nat).
O truque da reparametrização
Amostrar não é diferenciável, então um VAE ingênuo não treina por retropropagação, ponto. A correção é tirar a aleatoriedade do caminho por onde o gradiente passa:
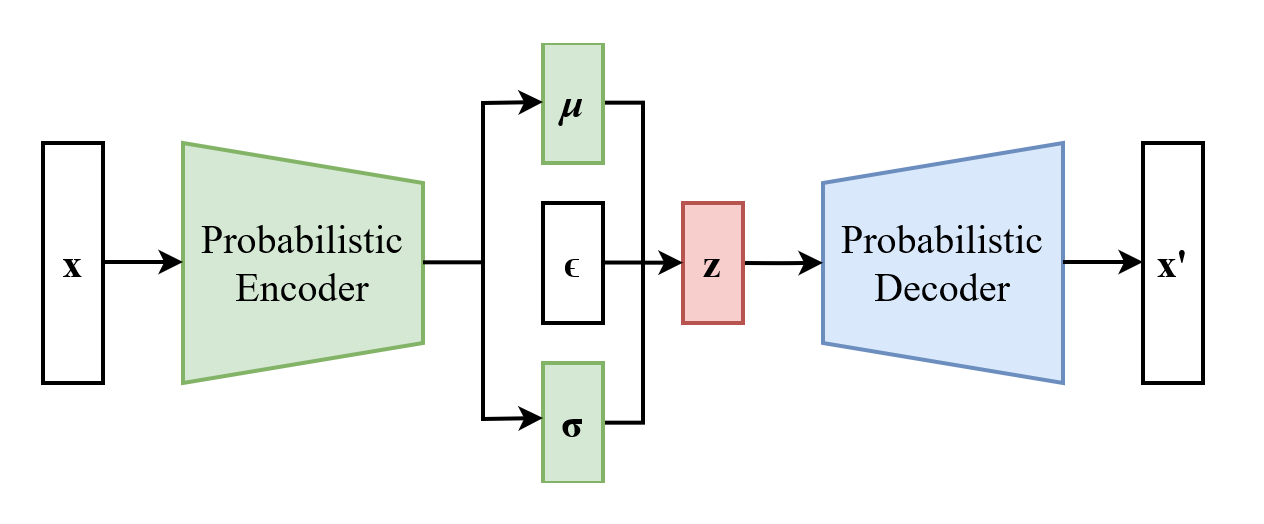
Agora \(z\) é função determinística de \(\mu\), \(\sigma\) e de uma entrada \(\epsilon\) que não carrega parâmetro nenhum. Gradientes fluem para \(\mu\) e \(\sigma\); o ruído entra como dado. O resto do VAE não era novo: a máquina de Helmholtz13, de 1995, já juntava uma rede de reconhecimento (um encoder) a uma rede generativa e a um limite variacional. Faltava um gradiente desse limite com pouco ruído. Essa única linha trouxe esse gradiente, no artigo do VAE8 e, de forma independente e ao mesmo tempo, no de Rezende, Mohamed e Wierstra12. O mesmo truque aparece por todo o aprendizado de máquina onde um nó estocástico fica dentro de um modelo diferenciável.
Concretamente, o gradiente do termo de reconstrução agora chega às duas saídas do encoder pela regra da cadeia:
A segunda carrega o cabo de guerra: qualquer que seja o sinal de \(\epsilon\), um ruído que piorou a reconstrução empurra \(\sigma\) para baixo, enquanto o termo KL o puxa de volta para 1. O passo 3 do lab roda essa atualização (uma amostra por vez) e chega à posterior verdadeira.
Uma passagem de VAE, número por número
Tudo até aqui — as duas cabeças, o truque, os dois termos da perda — numa rede pequena o bastante para acompanhar com lápis: duas entradas, um encoder de dois neurônios, um latente de uma dimensão, um decoder de dois neurônios e duas saídas. Percorra a passagem para a frente e depois a de volta. As cores são as do capítulo de MLP: verde para a passagem direta, laranja para gradientes e roxo para pesos. A segunda aba, Maior · 4-4-2-4-4, faz os mesmos onze passos numa rede com a forma de uma de verdade: quatro entradas, quatro neurônios de cada lado e um latente de duas dimensões, em que cada dimensão tem o seu \(\mu_k\), o seu \(\sigma_k\) e o seu \(\epsilon_k\) e cada gradiente é uma matriz.
Três coisas para reparar no caminho:
- Os passos 2, 3, 5 e 6 são um MLP comum. Um VAE são dois MLPs com um número aleatório no meio; toda regra de retropropagação que você já conhece vale sem mudança.
- O passo 4 é a única operação nova e o passo 10 é a derivada dele: \(\partial z/\partial \mu = 1\) e \(\partial z/\partial s = \tfrac12\sigma\epsilon\). Sem o truque, o passo 10 não teria pelo que multiplicar e o encoder não receberia gradiente nenhum da reconstrução.
- O passo 10 é onde mora o cabo de guerra. Arraste o \(\epsilon\) e observe a parte da reconstrução em \(\partial L/\partial s\): ela troca de sinal de um sorteio para outro, mas a média sobre \(\epsilon\), mostrada na legenda, é positiva — o ruído custa reconstrução, então empurra \(\sigma\) para baixo. A parte da KL é a mesma para todo \(\epsilon\) e sempre empurra \(\sigma\) para 1.
Por que as amostras são borradas — e por que isso não importa
Volte ao capítulo 16. O ELBO é um limite da verossimilhança, então um VAE maximiza verossimilhança, então ele otimiza a KL para frente, que é cobridora de modos. Quando o modelo não consegue representar os dados exatamente, ele fica em cima do muro — coloca probabilidade entre os modos em vez de escolher um.
Some a versão mecânica: uma perda de reconstrução \(\ell_2\) é uma verossimilhança gaussiana e a predição ótima sob erro quadrático é a média condicional. Se várias imagens nítidas são compatíveis com um código, a saída que minimiza a perda é a média delas. Médias de imagens são borradas. Não há bug aqui; o objetivo recebeu exatamente o que pediu.
Então o borrão se corrige mudando o objetivo, que é precisamente o que um autoencoder latente de produção faz:
O termo perceptual compara features profundas em vez de pixels, então uma textura deslocada em um pixel não é punida. O termo adversarial — um discriminador de GAN sobre a saída do decodificador (capítulo 18) — pune exatamente a suavidade que o \(\ell_2\) premia. Todo autoencoder latente de todo modelo de difusão é treinado assim11.
Para que serve um VAE, de fato
Aqui está a história de produção e não é a que o capítulo de livro-texto sugere.
Uma imagem RGB 512×512 são 786.432 números. Rodar difusão ali é inviável. A difusão latente9 roda num espaço comprimido — e um VAE convolucional é o que comprime:
| Pixels | Latente SD 1.5 / SDXL | Latente SD 3 / FLUX | |
|---|---|---|---|
| Formato em 512×512 | \(512\times512\times3\) | \(64\times64\times4\) | \(64\times64\times16\) |
| Números | 786.432 | 16.384 | 65.536 |
| Compressão | 1× | 48× | 12× |
O modelo generativo nunca vê um pixel. Ele trabalha inteiramente no espaço latente do VAE e o decodificador transforma o resultado em imagem só no final. Três consequências que vale carregar:
- O VAE limita sua qualidade. O que o encoder não representa, o modelo de difusão não gera. Texto pequeno e textura fina são perdas conhecidas — e a mudança de 4 para 16 canais latentes no SD3 e no FLUX mirou exatamente nisso.
- O β dele é minúsculo. Estes são compressores: não se amostra deles diretamente, então o termo KL só precisa manter a escala do latente limitada e razoavelmente regular. Valores práticos ficam na casa de \(10^{-6}\).
- Ele fica congelado. Treine o autoencoder uma vez e o mantenha fixo enquanto treina o modelo de difusão. É por isso que um ecossistema inteiro de LoRAs e fine-tunes compartilha um mesmo espaço latente.
O outro ramo: latentes discretos
Em vez de um latente gaussiano, o VQ-VAE10 encaixa cada vetor latente na entrada mais próxima de um codebook aprendido. O latente vira uma grade de inteiros.
É um projeto diferente com propósito diferente e a razão de conhecê-lo é que ele é o que torna o capítulo 23 possível: uma vez que uma imagem é uma grade de inteiros, ela é uma sequência de tokens e dá para rodar um Transformer sobre ela exatamente como sobre texto.
| KL-regularizado (contínuo) | VQ (discreto) | |
|---|---|---|
| Latente | Vetores de valores reais | Índices de codebook |
| Usado por | Difusão latente — SD, SDXL, SD3, FLUX | Geração autorregressiva e mascarada — VQGAN, MaskGIT, Chameleon |
| Modo de falha | Borrão; capacidade limitada por canal | Colapso de codebook — a maioria das entradas nunca é usada |
| Por quê | A difusão precisa de espaço contínuo para somar ruído | Transformers precisam de tokens discretos para prever |
Lab no Colab: o ELBO num VAE de verdade
O lab no fim desta página confere o ELBO no exemplo resolvido, em que tudo é exato. Um notebook no Colab leva as mesmas perguntas a VAEs de verdade no Fashion-MNIST (70 000 imagens de roupas em tons de cinza, 28 × 28). Ele roda no navegador, em CPU; não é preciso instalar nada. São oito seções, cada uma terminando num checkpoint com valor de verificação:
- a evidência estimada por amostragem — e por que o ELBO é o log aplicado cedo demais;
- o gradiente reparametrizado contra o autograd e contra a função escore que ele substituiu;
- a KL em forma fechada, pelo
torch.distributionse por Monte Carlo; - um VAE no Fashion-MNIST, os dois termos em nats e o gradiente nas duas cabeças;
- o β de 0 a 256: reconstrução, KL, dimensões ativas e o quanto as amostras do prior são reconhecíveis;
- o colapso do posterior com β = 1 (causado por um decoder que não precisa do código) e os free bits;
- a folga num VAE de verdade: limites ponderados por importância e a folga de amortização;
- configurações suas: a melhor verossimilhança dá as melhores amostras?
Abrir o laboratório no Colab — salve uma cópia no seu Drive (Arquivo → Salvar uma cópia no Drive) para rodar e editar.
Pontos principais
- Um autoencoder comprime; ele não gera. O espaço latente dele tem buracos e você não os enxerga.
- Um VAE codifica uma distribuição por entrada e puxa essas distribuições na direção de um prior. É isso que torna o espaço amostrável.
- \(\log p(x) = \text{ELBO} + \text{KL}(q \,\|\, p(z \mid x))\). O ELBO é um limite inferior da evidência, a folga é o quanto o encoder erra e subi-lo treina encoder e decoder de uma vez. Por extenso, ele é reconstrução menos KL-até-o-prior: os dois termos são necessários e puxam em direções opostas. Ele premia a melhor troca, não a melhor reconstrução.
- O β controla tudo. Pequeno demais e é um autoencoder; grande demais e o posterior colapsa. Registre os dois termos separadamente.
- O truque da reparametrização — \(z = \mu + \sigma\epsilon\) — é o que torna a coisa toda diferenciável.
- O borrão é o objetivo, não um bug: a KL para frente cobre modos e o \(\ell_2\) devolve a média condicional. Autoencoders de produção corrigem isso com perdas perceptual e adversarial.
- Em 2026, um VAE é quase sempre o compressor congelado embaixo de um modelo de difusão, de 12 a 48× de compressão e com β minúsculo. Ele limita a qualidade de tudo que é construído em cima.
- O VQ-VAE é o ramo discreto e é o que torna a geração autorregressiva de imagens possível.
Lab: o ELBO, medido
Quatro experimentos curtos sobre o modelo do exemplo resolvido: \(p(z) = \mathcal{N}(0, 1)\), \(p(x \mid z) = \mathcal{N}(2z, 1)\), uma observação \(x = 3\). Ele é pequeno o bastante para que a evidência \(\log p(x) = -2.6237\) e a posterior \(p(z \mid x) = \mathcal{N}(1.2,\ 0.2)\) sejam conhecidas exatamente, o que nunca acontece num VAE de verdade — e esse é o ponto. Cada afirmação deste capítulo vira um número que dá para conferir. Tudo roda só com numpy: clone os scripts e mude as constantes.
Passo 1 — a folga é o erro da posterior
Sorteie 10 000 chutes aleatórios \(q = \mathcal{N}(m, v)\) e calcule, para cada um, a folga \(\log p(x) - \text{ELBO}\) e, separadamente, \(\text{KL}(q \,\|\, p(z \mid x))\) a partir da posterior exata.
q = N(m, v) | ELBO | log p(x) - ELBO | KL(q ‖ p(z∣x)) |
|---|---|---|---|
N(+1.87, 0.509) | -4.0504 | 1.4267 | 1.4267 |
N(+0.19, 0.481) | -5.4150 | 2.7914 | 2.7914 |
N(+2.29, 0.023) | -6.2543 | 3.6306 | 3.6306 |
N(+1.49, 0.008) | -3.9357 | 1.3120 | 1.3120 |
N(-1.53, 0.042) | -21.6319 | 19.0083 | 19.0083 |
N(1.20, 0.200) = p(z∣x) | -2.6237 | 0.0000 | 0.0000 |
10 000 random q | |
|---|---|
log p(x) | -2.6237 |
max ELBO found | -2.6240 |
q with ELBO > log p(x) | 0 |
max ∣gap - KL(q ‖ p(z∣x))∣ | 1.1e-14 |
"""Lab 1 — the gap between log p(x) and the ELBO is exactly KL(q || p(z|x)).

Toy model: p(z) = N(0, 1), p(x | z) = N(w z, s^2), w = 2, s = 1, x = 3.
Everything is Gaussian, so the evidence, the posterior and both KLs are exact.
The script draws 10 000 random q = N(m, v), computes the gap two ways, and
checks that no q ever beats log p(x).

Printed as a markdown table, in identifiers only, so one artifact serves both
the English and the Portuguese page.
"""

import numpy as np

W, S, X = 2.0, 1.0, 3.0
VAR_X = W**2 + S**2
LOG_PX = -0.5 * np.log(2 * np.pi * VAR_X) - X**2 / (2 * VAR_X)
M_POST, V_POST = W * X / VAR_X, S**2 / VAR_X      # p(z | x) = N(1.2, 0.2)


def elbo(m, v):
    rec = -0.5 * np.log(2 * np.pi * S**2) - ((X - W * m) ** 2 + W**2 * v) / (2 * S**2)
    kl = 0.5 * (m**2 + v - 1 - np.log(v))
    return rec - kl


def kl_gauss(m1, v1, m2, v2):
    """KL(N(m1, v1) || N(m2, v2))."""
    return 0.5 * (np.log(v2 / v1) + (v1 + (m1 - m2) ** 2) / v2 - 1)


rng = np.random.default_rng(42)
m = rng.uniform(-2, 3, 10_000)
v = np.exp(rng.uniform(-5, 1, 10_000))
gap = LOG_PX - elbo(m, v)
kl_post = kl_gauss(m, v, M_POST, V_POST)

print("| `q = N(m, v)` | `ELBO` | `log p(x) - ELBO` | `KL(q ‖ p(z∣x))` |")
print("|---|---:|---:|---:|")
for i in range(5):
    print(f"| `N({m[i]:+.2f}, {v[i]:.3f})` | {elbo(m[i], v[i]):.4f} | {gap[i]:.4f} | {kl_post[i]:.4f} |")
print(f"| `N({M_POST:.2f}, {V_POST:.3f})` = `p(z∣x)` | **{elbo(M_POST, V_POST):.4f}** | 0.0000 | 0.0000 |")
print()
print("| `10 000 random q` | |")
print("|---|---:|")
print(f"| `log p(x)` | {LOG_PX:.4f} |")
print(f"| `max ELBO found` | {elbo(m, v).max():.4f} |")
print(f"| `q with ELBO > log p(x)` | **{int((gap < 0).sum())}** |")
print(f"| `max ∣gap - KL(q ‖ p(z∣x))∣` | {np.abs(gap - kl_post).max():.1e} |")
As duas últimas colunas da primeira tabela são o mesmo número e a maior discordância em 10 000 chutes é \(10^{-14}\) — ruído de ponto flutuante. É o passo 2 da derivação conferido numericamente: a folga é a KL até a posterior. Nenhum chute passa de \(\log p(x)\) e o melhor dos 10 000 aleatórios para 0.0003 abaixo dele.
Experimente
Faça W = 0 em lab-1-gap.py: agora o decoder ignora \(z\). Qual é a posterior e qual é a folga de \(q = p(z)\)? É por isso que o colapso do posterior é um estado estável: quando o decoder para de ler o código, devolver o prior para todo \(x\) não é uma falha do encoder — é a resposta correta.
Passo 2 — uma amostra basta
Um VAE nunca calcula \(\mathbb{E}_q[\log p(x \mid z)]\) exatamente. Ele sorteia \(z = \mu + \sigma\epsilon\) e tira a média de \(K\) amostras. Quão ruidoso é isso e de quantas amostras ele precisa? O script repete cada estimativa 2 000 vezes para o chute \(q_C = \mathcal{N}(1,\ 0.5^2)\), para o ELBO e para o gradiente dele em relação a \(m\).
K (samples of z) | ELBO estimate: mean | std | dELBO/dm estimate: mean | std |
|---|---|---|---|---|
| 1 | -2.7955 | 1.2931 | 1.1103 | 2.0036 |
| 10 | -2.7312 | 0.3810 | 0.9792 | 0.6394 |
| 100 | -2.7396 | 0.1205 | 1.0021 | 0.2002 |
| 1000 | -2.7361 | 0.0375 | 0.9983 | 0.0607 |
exact | -2.7371 | 0 | 1.0000 | 0 |
"""Lab 2 — estimating the ELBO and its gradient with K samples of z.

Same toy model (p(z) = N(0,1), p(x|z) = N(2z, 1), x = 3), q = N(1, 0.5^2).
A VAE never computes E_q[log p(x|z)] exactly: it samples z = m + sigma * eps
and averages. Each estimate is repeated 2 000 times to measure its mean and
its spread. The KL term is kept in closed form, as in a real VAE.

Printed as a markdown table, in identifiers only, so one artifact serves both
the English and the Portuguese page.
"""

import numpy as np

W, S, X = 2.0, 1.0, 3.0
M, V = 1.0, 0.25
SIGMA = np.sqrt(V)
KL = 0.5 * (M**2 + V - 1 - np.log(V))
EXACT_REC = -0.5 * np.log(2 * np.pi * S**2) - ((X - W * M) ** 2 + W**2 * V) / (2 * S**2)
EXACT_ELBO = EXACT_REC - KL
EXACT_GRAD = W * (X - W * M) / S**2 - M          # d ELBO / d m


def log_lik(z):
    return -0.5 * np.log(2 * np.pi * S**2) - (X - W * z) ** 2 / (2 * S**2)


rng = np.random.default_rng(42)
REPEATS = 2_000

print("| `K` (samples of z) | `ELBO estimate: mean` | `std` | `dELBO/dm estimate: mean` | `std` |")
print("|---:|---:|---:|---:|---:|")
for k in (1, 10, 100, 1000):
    eps = rng.standard_normal((REPEATS, k))
    z = M + SIGMA * eps                               # the reparameterization trick
    elbo = log_lik(z).mean(1) - KL
    grad = (W * (X - W * z) / S**2).mean(1) - M       # dz/dm = 1, KL part = -m
    print(f"| {k} | {elbo.mean():.4f} | {elbo.std():.4f} | {grad.mean():.4f} | {grad.std():.4f} |")
print(f"| `exact` | **{EXACT_ELBO:.4f}** | 0 | **{EXACT_GRAD:.4f}** | 0 |")
A estimativa é não viesada em todo \(K\): as médias caem sobre os valores exatos, \(-2.7371\) e \(1.0\), a menos do ruído de 2 000 repetições. A dispersão cai como \(1/\sqrt{K}\) — 1.29, 0.38, 0.12, 0.04 — ou seja, cem vezes mais amostras compram dez vezes menos ruído. Com \(K = 1\) uma única estimativa do gradiente pode até ter o sinal errado e o treino ainda funciona: o SGD só precisa de gradientes certos em média e um lote de 128 imagens já tira a média de 128 sorteios independentes de \(\epsilon\). É por isso que todo VAE usa uma amostra por imagem.
Experimente
Faça V = 0.01 (um chute estreito) e rode de novo. A dispersão em \(K = 1\) despenca. Por quê? Ligue a resposta ao \(4v\) do termo de reconstrução: o ruído do estimador é o ruído \(\sigma\epsilon\) que o encoder escolheu injetar.
Passo 3 — ajustando q com o truque
Agora treine \(q\). Comece no prior (\(m = 0\), \(\log v = 0\)) e suba o ELBO por subida estocástica do gradiente, uma amostra de \(\epsilon\) por passo, com os dois gradientes do truque da reparametrização. As curvas de nível são o ELBO exato; a linha branca é o que o SGD enxerga.
"""Lab 3 — fitting q by stochastic gradient ascent, one sample of z per step.

Same toy model (p(z) = N(0,1), p(x|z) = N(2z, 1), x = 3). q = N(m, e^s)
starts at the prior (m = 0, s = 0) and climbs the ELBO with the
reparameterization trick and K = 1, exactly as a VAE encoder would, but for a
single x. The contours are the exact ELBO; the path is what SGD sees.
"""

from io import StringIO

import matplotlib.pyplot as plt
import numpy as np

W, S, X = 2.0, 1.0, 3.0
VAR_X = W**2 + S**2
M_POST, V_POST = W * X / VAR_X, S**2 / VAR_X


def elbo(m, s):
    v = np.exp(s)
    rec = -0.5 * np.log(2 * np.pi * S**2) - ((X - W * m) ** 2 + W**2 * v) / (2 * S**2)
    return rec - 0.5 * (m**2 + v - 1 - s)


rng = np.random.default_rng(42)
m, s, lr, steps = 0.0, 0.0, 0.02, 1500
path = [(m, s)]
for _ in range(steps):
    eps = rng.standard_normal()
    sigma = np.exp(s / 2)
    z = m + sigma * eps
    dz = W * (X - W * z) / S**2                        # d log p(x|z) / dz
    gm = dz * 1.0 - m                                  # reconstruction + KL parts
    gs = dz * 0.5 * sigma * eps - 0.5 * (np.exp(s) - 1)
    m, s = m + lr * gm, s + lr * gs                    # ascent: maximize the ELBO
    path.append((m, s))
path = np.array(path)
tail = path[-500:].mean(0)

mm, ss = np.meshgrid(np.linspace(-0.5, 2.5, 300), np.linspace(-6, 1, 300))
fig, ax = plt.subplots(figsize=(7.5, 4.6))
cs = ax.contourf(mm, ss, elbo(mm, ss), levels=np.linspace(-12, -2.6, 25), cmap="viridis", extend="min")
cs.set_rasterized(True)
fig.colorbar(cs, ax=ax, label="ELBO", ticks=[-12, -10, -8, -6, -4, -2.62])
ax.plot(path[:, 0], path[:, 1], c="w", lw=0.8, alpha=0.9)
ax.plot(*path[0], "o", c="C0", ms=9, mec="w", label="start: $p(z) = \\mathcal{N}(0, 1)$")
ax.plot(*tail, "o", mfc="none", mec="C3", mew=2.2, ms=17,
        label=f"SGD, mean of last 500 steps: $m = {tail[0]:.2f}$, $v = {np.exp(tail[1]):.2f}$")
ax.plot(M_POST, np.log(V_POST), "*", c="k", ms=14, mec="w", zorder=5,
        label=f"$p(z\\mid x) = \\mathcal{{N}}({M_POST:.1f},\\ {V_POST:.1f})$")
ax.plot(1.5, np.log(0.01), "s", c="C1", ms=8, mec="w", label="$q_B = \\mathcal{N}(1.5,\\ 0.1^2)$")
ax.set_xlabel("$m$ (mean of $q$)")
ax.set_ylabel("$s = \\log v$ (log-variance of $q$)")
ax.set_title(f"{steps} steps, $K = 1$, $\\eta = {lr}$")
ax.legend(loc="lower left", fontsize=8.5, framealpha=0.85)
fig.tight_layout()
buf = StringIO()
fig.savefig(buf, format="svg", transparent=True, dpi=110)
print(buf.getvalue())
O caminho sobe direto pela encosta e depois vagueia numa nuvem pequena em volta do ótimo, porque cada passo vê um só \(\epsilon\). Na média dos últimos 500 passos ele fica em \(m = 1.20\), \(v = 0.20\): a posterior verdadeira, encontrada sem nunca calcular \(p(x)\) nem \(p(z \mid x)\). Só a KL o teria mantido no prior; só a reconstrução o teria levado até o quadrado \(q_B\).
Um encoder de verdade faz a mesma coisa para todas as imagens ao mesmo tempo, com uma diferença importante: em vez de números livres \((m, s)\) por imagem, ele aprende uma função \(x \mapsto (\mu, \log\sigma^2)\) compartilhada por todas. Essa função não consegue acertar cada posterior exatamente e a sobra se chama folga de amortização (amortization gap).
Experimente
Mude lr para 0.2 e depois para 0.002. Com o passo grande, olhe o tamanho da nuvem no fim; com o pequeno, veja se o caminho chegou depois de 1 500 passos. Essa troca é a taxa de aprendizado de um VAE.
Passo 4 — o β move o ótimo
Troque o ELBO pelo objetivo ponderado por \(\beta\), \(\mathbb{E}_q[\log p(x \mid z)] - \beta\,\text{KL}(q \,\|\, p(z))\). Neste modelo o melhor chute tem fórmula exata, obtida igualando as duas derivadas a zero:
As cinco primeiras colunas são para \(x = 3\). A última tira a média da KL sobre um conjunto de 10 000 observações \(x \sim p(x)\): é quantos nats sobre \(x\) o código guarda.
beta | m* | v* | E_q[log p(x∣z)] | KL(q ‖ p(z)) | mean KL over the dataset |
|---|---|---|---|---|---|
| 0.01 | 1.496 | 0.0025 | -0.924 | 3.618 | 3.121 |
| 0.1 | 1.463 | 0.0244 | -0.970 | 2.440 | 1.965 |
| 1 | 1.200 | 0.2000 | -1.499 | 1.125 | 0.805 |
| 4 | 0.750 | 0.5000 | -3.044 | 0.378 | 0.253 |
| 16 | 0.300 | 0.8000 | -5.399 | 0.057 | 0.037 |
| 100 | 0.058 | 0.9615 | -7.003 | 0.002 | 0.001 |
"""Lab 4 — what beta does to the best q, in closed form.

Same toy model (p(z) = N(0,1), p(x|z) = N(w z, s^2), w = 2, s = 1). Maximizing
E_q[log p(x|z)] - beta * KL(q || p(z)) over q = N(m, v) has an exact answer:

    m* = w x / (w^2 + beta s^2)        v* = beta s^2 / (w^2 + beta s^2)

The first block is the single observation x = 3. The second averages over a
whole dataset x ~ p(x): the mean KL(q || p(z)) is how many nats about x the
code keeps.

Printed as a markdown table, in identifiers only, so one artifact serves both
the English and the Portuguese page.
"""

import numpy as np

W, S, X = 2.0, 1.0, 3.0
BETAS = (0.01, 0.1, 1.0, 4.0, 16.0, 100.0)


def best_q(x, beta):
    m = W * x / (W**2 + beta * S**2)
    v = beta * S**2 / (W**2 + beta * S**2)
    return m, v


def terms(x, m, v):
    rec = -0.5 * np.log(2 * np.pi * S**2) - ((x - W * m) ** 2 + W**2 * v) / (2 * S**2)
    kl = 0.5 * (m**2 + v - 1 - np.log(v))
    return rec, kl


rng = np.random.default_rng(42)
data = W * rng.standard_normal(10_000) + S * rng.standard_normal(10_000)   # x ~ p(x)

print("| `beta` | `m*` | `v*` | `E_q[log p(x∣z)]` | `KL(q ‖ p(z))` | `mean KL over the dataset` |")
print("|---:|---:|---:|---:|---:|---:|")
for beta in BETAS:
    m, v = best_q(X, beta)
    rec, kl = terms(X, m, v)
    dm, dv = best_q(data, beta)
    mean_kl = terms(data, dm, dv)[1].mean()
    bold = "**" if beta == 1.0 else ""
    print(f"| {bold}{beta:g}{bold} | {m:.3f} | {v:.4f} | {rec:.3f} | {kl:.3f} | {mean_kl:.3f} |")
Os três regimes de O β é a história inteira, em números:
- \(\beta \to 0\): \(v^* \to 0\) e \(m^* \to x/2 = 1.5\) — o ponto \(q_B\). A reconstrução é a melhor possível (\(-0.92\)) e o código guarda mais de 3 nats por observação. Um autoencoder.
- \(\beta = 1\): \(\mathcal{N}(1.2,\ 0.2)\), a posterior verdadeira. O código guarda 0.805 nats em média — exatamente \(\tfrac12\log 5\), a informação mútua entre \(x\) e \(z\) neste modelo.
- \(\beta \to \infty\): \(m^* \to 0\) e \(v^* \to 1\) — o prior. Em \(\beta = 100\) o código guarda 0.001 nat: ele não diz nada sobre \(x\). Colapso do posterior.
Aqui o decoder é fixo, então o colapso é só o encoder desistindo. Num VAE de verdade o decoder também aprende e isso piora as coisas: quando os códigos não carregam nada, o decoder aprende a ignorá-los — e aí, como o Experimente do passo 1 mostrou, o prior passa a ser mesmo a melhor resposta. Esse laço de realimentação é por que é difícil sair do colapso depois que ele começa e por que o annealing da KL começa com \(\beta\) em zero.
O que o lab está de fato ensinando
O ELBO não é uma perda que alguém adivinhou. Ele é \(\log p(x)\) menos uma folga que dá para medir, estimado com uma amostra ruidosa, escalado com o truque da reparametrização e entortado pelo \(\beta\) na direção de uma de duas falhas. Todo VAE que você treinar é este brinquedo com mais dimensões — a única diferença é que você nunca mais vai ver \(\log p(x)\) para conferir.
Adicional
Relação entre Log Variância e Desvio Padrão
Relação entre Log Variância e Desvio Padrão
- Nos VAEs, o encoder produz a média \( \mu \) e a log variância \( \log(\sigma^2) \) da distribuição do espaço latente.
- O desvio padrão \( \sigma \) pode ser derivado da log variância usando a relação:
- A rede prevê \(\log \sigma^2\) em vez de \(\sigma\) porque o log é irrestrito: uma saída sem limites mapeia para uma variância garantidamente positiva, sem clipping e sem risco de um desvio padrão negativo aparecer no meio do treino.
Para \(z \sim \mathcal{N}(\mu, \sigma^2)\), escreva \(s = \log \sigma^2\) para a log variância, como no diagrama passo a passo. Então
| Grandeza | Símbolo | Em termos de \(s = \log \sigma^2\) |
|---|---|---|
| Variância | \(\sigma^2\) | \(e^{s}\) |
| Desvio padrão | \(\sigma\) | \(e^{s/2}\) |
| Log variância | \(s\) | \(2 \log \sigma\) |
A escala log também é numericamente mais suave: variâncias de \(10^{-4}\) a \(1\) são log variâncias de \(-9.2\) a \(0\), uma faixa que uma camada linear alcança sem nenhum peso extremo.
Apêndice: a divergência KL
A divergência de Kullback–Leibler4 aparece três vezes neste capítulo — como a folga do ELBO, como o termo que puxa cada código na direção do prior e no argumento da KL para frente que explica o borrão. Vale conhecê-la por si só.
O que ela mede
Leia como um procedimento: sorteie \(x\) de \(q\), pergunte o quanto \(q\) o acha mais provável do que \(p\) acha (em escala log) e tire a média. Em termos de informação, é o número de nats extras por amostra que se paga quando dados que vêm de fato de \(q\) são codificados com um código feito para \(p\).
Três propriedades, todas visíveis no painel abaixo:
- Ela nunca é negativa e só é zero quando \(q = p\) (desigualdade de Gibbs).
- Ela não é simétrica: em geral \(\text{KL}(q \,\|\, p) \neq \text{KL}(p \,\|\, q)\), então não é uma distância.
- O integrando pode ser negativo onde \(p > q\), mas o total nunca é.
Entre duas gaussianas
Para duas gaussianas a integral tem forma fechada:
Cada pedaço tem um significado: a razão entre as duas larguras, a dispersão de \(q\) medida em unidades de \(p\) e a distância ao quadrado entre as médias, também em unidades de \(p\). Faça \(p = \mathcal{N}(0, 1)\) e ela vira \(\tfrac12\big(\mu^2 + \sigma^2 - 1 - \log \sigma^2\big)\) — o termo KL da perda do VAE, deduzido no passo 5 a partir da esperança e aqui lido direto da fórmula geral.
Mova você mesmo
O que experimentar:
- Posterior do VAE vs prior coloca \(q = \mathcal{N}(1.2,\ 0.2)\), a posterior exata do exemplo resolvido, contra o prior. \(\text{KL}(q \,\|\, p) = 1.1247\): a coluna KL da tabela daquele exemplo.
- q estreita dentro de p dá \(\text{KL}(q \,\|\, p) = 0.318\) mas \(\text{KL}(p \,\|\, q) = 0.807\). Uma \(q\) estreita parada onde \(p\) tem massa é barata numa direção e cara na outra. Essa assimetria é a história de busca de modo contra cobertura de modos do capítulo 16.
- Bem afastadas coloca as médias em \(\pm 2\) com larguras iguais: as duas direções dão 8, porque com dispersões iguais a KL é simétrica, \((\mu_q - \mu_p)^2 / 2\sigma^2\). Arraste uma das larguras e veja os dois números se separarem.
- Aperte \(\sigma_q\) até 0.25 em cima de \(p = \mathcal{N}(0, 1)\): \(\text{KL}(q \,\|\, p)\) cresce como \(\log(1/\sigma_q)\). É o preço que um VAE paga por um encoder que vira autoencoder, um ponto nítido por entrada.
-
Sharma, A. “Introduction to Autoencoders,” PyImageSearch, 2023. ↩
-
Bandyopadhyay, H. "Autoencoders in Deep Learning: Tutorial & Use Cases," V7 Labs. ↩
-
Sharma, A. “A Deep Dive into Variational Autoencoders with PyTorch,” PyImageSearch, 2023. ↩
-
Higgins, I., et al. (2017). β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework — ICLR. Onde o botão β é nomeado e estudado. ↩
-
Bowman, S., et al. (2016). Generating Sentences from a Continuous Space — CoNLL. O primeiro relato cuidadoso do colapso do posterior e do annealing da KL como correção. ↩
-
Variational AutoEncoders (VAE) with PyTorch — uma implementação limpa e mínima para ler junto com este capítulo. ↩
-
Kingma, D. P., & Welling, M. (2014). Auto-Encoding Variational Bayes — ICLR 2014 (no arXiv desde dezembro de 2013). O ELBO e o truque da reparametrização. ↩
-
Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-Resolution Image Synthesis with Latent Diffusion Models — CVPR. Stable Diffusion; a seção 3 é o autoencoder e é a parte do artigo sobre a qual este capítulo fala. ↩
-
van den Oord, A., Vinyals, O., & Kavukcuoglu, K. (2017). Neural Discrete Representation Learning — NeurIPS. VQ-VAE. ↩
-
Esser, P., Rombach, R., & Ommer, B. (2021). Taming Transformers for High-Resolution Image Synthesis — CVPR. VQGAN: a receita perceptual + adversarial que tornou autoencoders latentes nítidos. ↩
-
Rezende, D. J., Mohamed, S., & Wierstra, D. (2014). Stochastic Backpropagation and Approximate Inference in Deep Generative Models — ICML. O mesmo estimador, encontrado de forma independente. ↩
-
Dayan, P., Hinton, G. E., Neal, R. M., & Zemel, R. S. (1995). The Helmholtz Machine — Neural Computation 7(5). Um encoder e um decoder treinados contra um limite variacional, dezoito anos antes do VAE. ↩