O caminho desta parte
- Mapear o campocada técnica pelo trabalho que faz; quatro caminhos
- Reusar, não recomeçartransfer learning, modelos de fundação, prompts
- Achar o clássico por dentrosoftmax, k-NN, regressão logística, vazamento
- Rotear o problemaonde o clássico vence; o que usar quando
Um mapa do campo
As fichas cheias foram vistas na disciplina (o selo é o código da aula); as tracejadas ficam além. Clique em uma técnica: o que ela é, no que se apoia, o que se apoia nela, onde ler mais. O mapa rola.
O mapa está na página da aula.
Lendo o mapa: quatro caminhos
geração aumentada por recuperação (RAG)
apoia-se no k-NN e nos embeddings densos: uma ideia de 1951 e uma de 2013 formam a metade de busca de um sistema de 2020
alinhamento (RLHF)
aprendizado por reforço com feedback humano. O modelo de recompensa: \(P(\text{A preferida a B}) = \sigma(r_A - r_B)\), com \(r\) o escore de uma resposta e \(\sigma\) a sigmoide: uma regressão logística
avaliação de sistemas de LLM
LLMs (grandes modelos de linguagem) são avaliados com métricas de classificação; um benchmark cujas perguntas vazaram para o treino é um scaler ajustado antes da divisão, em escala de internet
modelos de fundação tabulares
o único ponto em que a fronteira ataca de frente o gradient boosting (abordagem avançada)
Transfer learning: pare de começar do zero
Pré-treine um modelo grande num corpus genérico enorme e depois adapte-o à sua tarefa.
extração de atributos
congele o modelo e use suas representações como atributos para uma cabeça clássica. Você fez isso: sentence embeddings alimentando uma regressão logística ou um agrupamento.
fine-tuning
continue treinando alguns ou todos os pesos com seus dados rotulados: tipicamente 10²–10⁴ exemplos em vez de 10⁶.
LoRA: fine-tuning de uma fatia fina
Adaptação de baixo posto (low-rank adaptation; Hu et al., 2022): mantenha a matriz de pesos \(W\) congelada e treine só uma correção \(BA\), com \(B\) e \(A\) finas.
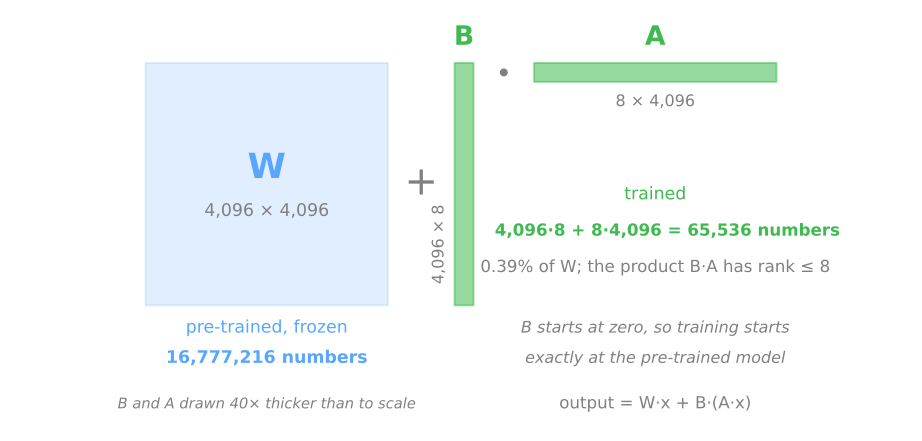
\(B\): \(4096 \times 8\); \(A\): \(8 \times 4096\). Juntas, \(2 \times 4096 \times 8 = 65.536\) números, contra 16.777.216 em \(W\): 0,39%.
Modelos de fundação
- Transformers, pré-treino autossupervisionado (prever tokens mascarados ou o próximo token: os rótulos são grátis), bilhões de parâmetros.
- Um único modelo muito grande adaptado a muitas tarefas (Bommasani et al., 2021): GPT, Claude, Gemini, Llama para texto; CLIP para visão e linguagem; Whisper para fala.
- Por que escalar? A perda de teste cai como uma lei de potência suave em parâmetros, dados e computação (Kaplan et al., 2020).
Com LLMs, a adaptação fica ainda mais leve
| adaptação | dados rotulados necessários | o que acontece |
|---|---|---|
| zero-shot | nenhum | descreva a tarefa no prompt |
| few-shot / em contexto | um punhado | exemplos no prompt; nenhum peso muda |
| fine-tuning (completo / LoRA) | centenas+ | atualiza os pesos ou uma fatia de baixo posto |
| RAG | nenhum (precisa de documentos) | recupera trechos por busca de vizinhos mais próximos sobre embeddings e os põe no contexto |
fit() e continua sendo preciso um conjunto de teste rotulado para saber se ele funciona.A caixa de ferramentas clássica, dentro da pilha de LLMs
- A camada de saída é uma regressão softmax sobre o vocabulário; o treino é gradiente descendente em mini-batch com weight decay (uma penalidade L2) sobre a entropia cruzada.
- Os sistemas RAG são k-NN sobre embeddings; um banco de dados vetorial é um motor de vizinhos mais próximos aproximados.
- O modelo de recompensa do RLHF é uma regressão logística sobre pares de respostas.
- Avaliar um sistema de LLM é pensar em precisão e revocação mais um desenho honesto com dados separados; perguntas de teste vazadas são o problema de vazamento atual do campo.
- O BERTopic já compunha embeddings de modelos de fundação com UMAP, HDBSCAN e TF-IDF.
Onde o ML clássico ainda vence
| situação | por que o clássico vence |
|---|---|
| dados tabulares | o gradient boosting ainda lidera em tabelas de tamanho médio (Grinsztajn et al., 2022); LLMs são ruins com tabelas de números |
| latência, custo, escala | uma regressão logística pontua uma linha em microssegundos |
| decisões reguladas | razões de chances e valores SHAP (SHapley Additive exPlanations) podem ser mostrados a um auditor; um prompt não |
| problemas pequenos e estruturados | 2.000 linhas precisam de controle de viés–variância, não de um trilhão de parâmetros |
| determinismo | modelo fixo + entrada fixa = saída fixa; LLMs amostram |
Um desafiante nas tabelas pequenas: o TabPFN, um transformer pré-treinado em tabelas sintéticas que prevê em uma única passada (abordagem avançada).
Roteamento: o que usar quando
| o pedido | rota |
|---|---|
| texto livre, imagens ou som, poucos rótulos | modelo de fundação: primeiro um prompt; com algumas centenas de rótulos, embeddings + uma cabeça clássica; fine-tuning (LoRA) se nenhum dos dois bastar |
| a resposta tem de sair dos seus documentos | RAG: um k-NN sobre os embeddings deles alimenta o prompt |
| uma tabela de números e categorias | pilha clássica: gradient boosting como padrão; regressão logística para auditar ou pontuar em microssegundos |
| os dois tipos de entrada | os dois: o modelo de fundação transforma o texto em colunas, o modelo clássico decide |
Resumo
- Toda técnica tem um lugar no mapa; a maior parte da fronteira se apoia em fichas que esta disciplina ensinou.
- Transfer learning: um modelo congelado como extrator de atributos ou ajustado com fine-tuning (a LoRA treina uma fatia fina).
- Modelos de fundação: pré-treino autossupervisionado em escala; adaptados por um prompt, alguns exemplos, trechos recuperados ou fine-tuning.
- Dentro da pilha de LLMs: regressão softmax, gradiente descendente, busca por k-NN, um modelo de recompensa logístico, vazamento.
- Roteie: linguagem para modelos de fundação, tabelas para a pilha clássica, sistemas reais para os dois.
Rotear o problema, passos 1 a 4
- Sem notebook: copie o código de cada passo da página da aula para um notebook novo no Colab, em ordem. Os passos 1 e 4 não têm código.
- Passo 1: ache a sua disciplina no mapa · passo 2: a metade de busca do RAG é um k-NN · passo 3: o modelo de recompensa é uma regressão logística · passo 4: rotear seis pedidos.
- Em todo passo, responda ao Preveja antes de rodar ou de abrir a solução.
- Simulações: a mesma pergunta, com outras palavras (passo 2) e eleitores que gostam de respostas longas (passo 3).
Ritmo: passo 1 em 5 min; passo 2 e sua simulação em 10 min; passo 3 e sua simulação em 10 min; passo 4 em 5 min.