Uma pergunta que parece simples
- Ninguém rotula os documentos nem lista os temas: é não supervisionado, o irmão textual do agrupamento.
- Usos: um ano de avaliações ou de chamados de suporte, um arquivo de notícias, redes sociais, uma literatura científica.
LDA
alocação latente de Dirichlet: uma história probabilística de como as palavras são escritas
NMF
fatoração de matrizes não negativas da matriz TF-IDF (frequência do termo × frequência inversa nos documentos)
BERTopic
sentence embeddings + UMAP + HDBSCAN + uma variante do TF-IDF
Dois corpora: 11 frases escritas à mão e 2.155 posts reais de quatro fóruns (o fórum fica escondido dos modelos, para conferi-los).
O caminho desta aula
- O que é um tópico?palavras que andam juntas ou documentos que andam juntos
- LDAalocação latente de Dirichlet: uma história de como as palavras são escritas
- NMFfatoração de matrizes não negativas: um documento como soma de partes
- BERTopicembeddings, redução, agrupamento, descrição
- Comparar e escolheros três lado a lado; as armadilhas
O que é um tópico? Duas respostas
uma distribuição sobre palavras
"Esportes" dá probabilidade alta a team, game, goal e quase nenhuma a oven. Um documento é uma mistura: 80% esportes, 20% espaço.
LDA e também a NMF, com pesos não negativos
um grupo de documentos
Cada documento pertence a um tópico ou a nenhum; as palavras do tópico são calculadas depois, para descrever o grupo.
BERTopic
O corpus escrito à mão, como contagens
| doc | team | game | goal | rocket | launch | moon | bread | bake |
|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 1 | 1 | 0 | 0 | 0 | 0 | 0 |
| 3 | 0 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 6 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 1 |
| 9 | 1 | 1 | 0 | 1 | 1 | 0 | 0 | 0 |
| 10 | 0 | 0 | 0 | 0 | 0 | 1 | 1 | 0 |
11 frases, 53 palavras mantidas, um vocabulário de 33 (sem as stop words do inglês).
Três temas: esportes, espaço e culinária; as duas últimas frases os misturam.
LDA: uma história de como as palavras chegaram lá
Latent Dirichlet Allocation (Blei, Ng & Jordan, 2003):
- cada tópico \(k\) é uma distribuição \(\varphi_k\) sobre o vocabulário;
- cada documento \(d\) tem sua própria mistura \(\theta_d\), por exemplo \((0{,}8;\ 0{,}2)\);
- para cada posição de palavra: sorteie um tópico \(z\) de \(\theta_d\) e depois uma palavra de \(\varphi_z\).
Não é uma afirmação de que as pessoas escrevem assim. A ordem das palavras não entra: contagens de bag-of-words bastam.
A história à mão
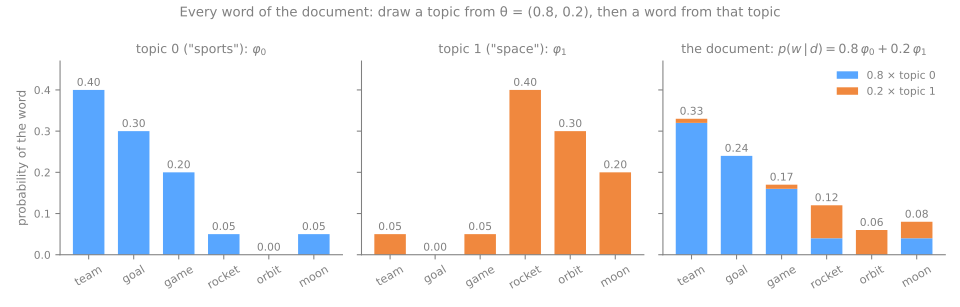
Um documento 80% esportes, 20% espaço:
\(p(\textit{team}) = 0{,}8 \times 0{,}40 + 0{,}2 \times 0{,}05 = 0{,}33\)
\(p(\textit{rocket}) = 0{,}8 \times 0{,}05 + 0{,}2 \times 0{,}40 = 0{,}12\)
Seguindo a história, 4 das 12 posições sortearam o tópico espaço; são exatamente aquelas onde aparecem moon, orbit, rocket, orbit.
A priori de Dirichlet: quão misturado é um documento?
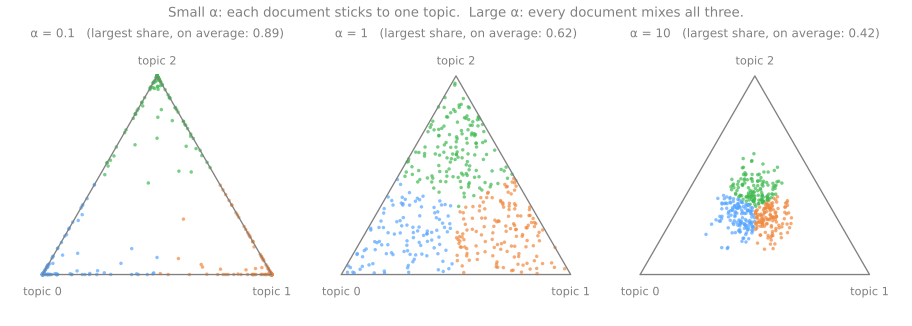
| \(\alpha\) | maior fatia |
|---|---|
| 0,1 | 0,89 |
| 1 | 0,62 |
| 10 | 0,42 |
No scikit-learn: doc_topic_prior e topic_word_prior, ambos \(1/k\) por padrão: poucos tópicos por documento, poucas palavras por tópico.
Simulador: escreva um documento do jeito da LDA
Preveja. Com \(\alpha = 0{,}1\), os documentos sorteados saem de uma cor só ou das três?
Ajustando a LDA: a história de trás para a frente
- Gere um corpus com a própria história (300 documentos, 30 palavras cada), para conhecer os tópicos verdadeiros.
- A LDA recupera os pesos verdadeiros (0,35, 0,30 e 0,25 nas palavras de cada tópico) com erro de 0,01.
- As misturas estimadas têm correlação de 0,97 com as verdadeiras.
E nas 53 palavras escritas à mão?
- Semente 0: bread fresh game oven · team goal game orbit · rocket launch bread delayed: os temas misturados.
- Cada documento ainda vai com confiança (0,86 a 0,88) para um tópico.
- Em 20 sementes, só 1 separa limpo as nove frases de um tema só.
A LDA em 2.155 posts reais
Quatro fóruns do 20 Newsgroups (computação gráfica, hóquei, espaço, religião); 5.725 palavras de 3+ letras em pelo menos 5 posts e no máximo em metade deles.
| jpeg don pts like think play period gif |
| god space people think just jesus time like |
| team game hockey season games nhl play year |
| image edu data graphics space available software program |
NMF: \(X \approx WH\), sem nada negativo
\[ X_{\,n \times V} \;\approx\; W_{\,n \times k}\; H_{\,k \times V}, \qquad W \ge 0,\; H \ge 0 \]linhas de \(H\)
os tópicos: um peso para cada palavra
linhas de \(W\)
quanto de cada tópico um documento contém
Lee & Seung (1999): o mesmo formato da PCA (análise de componentes principais), mais a restrição de toda entrada ser \(\ge 0\). Aqui \(X\) é a TF-IDF.
A NMF nas 11 frases
Tópicos: launch rocket satellite orbit · bread oven bake fresh · team game goal won
Divisão limpa, onde a LDA falhou 19 vezes em 20.
init='nndsvda' parte de uma SVD (decomposição em valores singulares), não de um ponto aleatório: um dos motivos da estabilidade.
| frase | espaço | culinária | esportes |
|---|---|---|---|
| 0 (esportes) | 0,00 | 0,00 | 0,71 |
| 3 (espaço) | 0,62 | 0,00 | 0,00 |
| 9 team watched the rocket launch… | 0,29 | 0,00 | 0,45 |
| 10 astronauts ate fresh bread… | 0,10 | 0,41 | 0,00 |
Por que não negativa? Uma comparação com a SVD
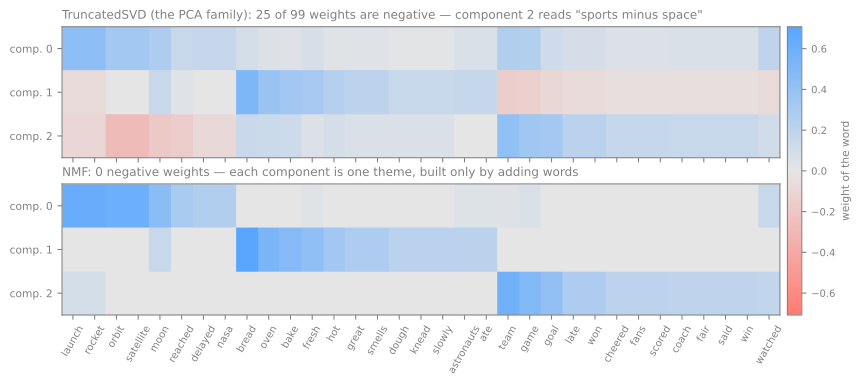
Simulador: partes da NMF contra direções da SVD
Preveja. A partir de pesos aleatórios, aperte passo: as linhas da NMF terminam como temas inteiros ou como contrastes, como as da SVD? O erro dela chega ao da SVD?
A NMF nos posts
| graphics thanks files image program file know windows |
| god jesus people believe christ faith bible christians |
| game team hockey players play games season nhl |
| space nasa launch shuttle moon orbit lunar earth |
LDA
NMF
Uma rodada em um corpus: o lab encontra um corpus em que a ordem se inverte.
Quantos tópicos? E eles são bons?
Não há rótulos para validar: a nota precisa vir dos próprios documentos.
perplexidade
o quanto a LDA se surpreende com posts separados; menor é melhor; só para modelos probabilísticos
coerência (NPMI)
a informação mútua pontual normalizada: as palavras do topo aparecem juntas nos documentos?
À mão: dos 2.155 posts, 304 têm god, 159 jesus e 101 as duas; se fossem independentes, seriam 1,04%; observado 4,69%: NPMI = 0,492.
Escolhendo o \(k\)
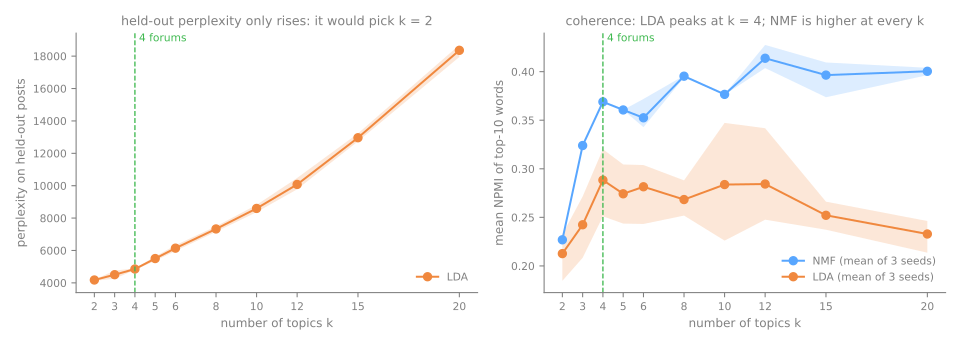
Com \(k = 4\): coerência da LDA 0,224 e diversidade 0,85; da NMF, 0,369 e 1,00.
A perplexidade só sobe: lida ao pé da letra, recomenda \(k = 2\); e ela não acompanha o que as pessoas acham interpretável.
Documentos curtos: onde as contagens acabam
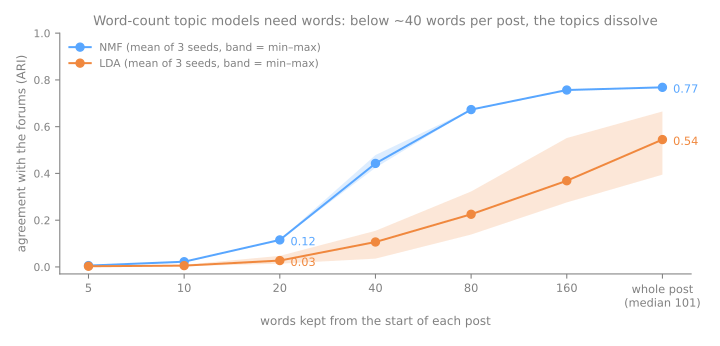
Com as 20 primeiras palavras de cada post: NMF 0,12, LDA 0,03.
Significado como distância
cosseno na TF-IDF
cosseno dos embeddings
Nos posts de 20 palavras, um k-means simples nos embeddings chega a ARI 0,582, cinco vezes o da NMF.
BERTopic: quatro passos, cada um uma aula que você conhece
Etapa 1 — embeddings
Cada post → 384 números com o all-MiniLM-L6-v2 (pequeno, em inglês, rápido numa CPU).
TF-IDF
embeddings
Etapa 2 — reduzir com UMAP
- Em 384 dimensões as distâncias se concentram: o agrupamento por densidade sofre.
- UMAP (Uniform Manifold Approximation and Projection) para 5 dimensões, não 2: o objetivo é agrupar, não desenhar.
min_dist=0.0junta bem os pontos parecidos, que é o que um agrupador por densidade quer.
random_state.Etapa 3 — agrupar com HDBSCAN
grupos
min_cluster_size=10 e da densidadeoutliers (−1)
puros
Hóquei (516) e religião (554) viram um grupo grande cada; computação gráfica e espaço se quebram em muitos pequenos (formatos de arquivo, placas de vídeo, a Lua…).
Simulador: min_cluster_size, um valor por vez
Preveja. Suba min_cluster_size de 2 a 40: o número de tópicos cai aos poucos?
Etapa 4 — descrever cada grupo com c-TF-IDF
Junte os documentos de um grupo num pseudodocumento; depois, um TF-IDF por classe (c-TF-IDF):
\[ \text{c-TF-IDF}(t, c) = \frac{n_{t,c}}{\sum_{t'} n_{t',c}} \times \log\!\Big(1 + \frac{A}{f_t}\Big) \]À mão, três grupos das frases escritas à mão: 16, 13 e 14 palavras, \(A = 14\).
team (3×, todas em esportes)
\(\tfrac{3}{16} \times \log(1 + 14/3) = 0{,}325\)
game (2×)
\(\tfrac{2}{16} \times \log 8 = 0{,}260\)
O transformador do próprio BERTopic dá exatamente a mesma matriz.
Os grupos dos posts, com nome
| grupo | posts | palavras do topo |
|---|---|---|
| −1 | 431 | space jpeg launch image (os outliers) |
| 1 | 567 | god jesus people church |
| 0 | 520 | team game hockey play |
| 15 | 66 | image graphics package processing |
| 9 | 55 | card mode vesa vga |
| 23 | 52 | moon lunar prize money |
A classe BERTopic encadeia os mesmos quatro passos: mesma partição (ARI 1,0), mesmas palavras do topo, só renumeradas por tamanho.
Etapa 5 — ajustar as palavras, não os grupos
| tópico 2, nomeado por… | palavras do topo |
|---|---|
| vetorizador padrão | image and for of to it or the graphics with |
| sem stop words | image graphics package processing software data analysis … |
| KeyBERTInspired | graphical graphics rtrace plots tools interactive plotting … |
update_topics as troca e as atribuições de post a tópico ficam idênticas.LDA vs NMF vs BERTopic, medidos
Os mesmos 2.155 posts, 24 tópicos para os três, duas sementes cada. Preveja antes: de quem são os tópicos mais puros?
| modelo | semente | tópicos | outliers | coerência | diversidade | homogeneidade |
|---|---|---|---|---|---|---|
| LDA | 42 | 24 | 0% | 0,265 | 0,72 | 0,526 |
| NMF | 42 | 24 | 0% | 0,391 | 0,92 | 0,646 |
| BERTopic | 42 | 24 | 20% | 0,251 | 0,88 | 0,927 |
| LDA | 43 | 24 | 0% | 0,276 | 0,70 | 0,574 |
| NMF | 43 | 24 | 0% | 0,407 | 0,91 | 0,644 |
| BERTopic | 43 | 16 | 10% | 0,295 | 0,82 | 0,662 |
Lendo a tabela
- Homogeneidade: BERTopic 0,927, mas nos 80% de posts que ele manteve; com a semente 43 ele acha 16 tópicos mais amplos e cai para 0,662.
- Coerência e diversidade favorecem a NMF: a NPMI premia palavras que aparecem juntas, que é o que a NMF reconstrói; o BERTopic escolhe palavras distintivas.
- Estabilidade entre sementes (ARI): LDA 0,164, NMF 0,736, BERTopic 0,324, com até o número de tópicos mudando.
A comparação geral
| LDA | NMF | BERTopic | |
|---|---|---|---|
| um tópico é | uma distribuição sobre palavras | uma linha não negativa de \(H\) | um grupo, nomeado pelo c-TF-IDF |
| número de tópicos | fixado de antemão | fixado de antemão | encontrado pelo HDBSCAN |
| documentos curtos | fraca | fraca | forte |
| outliers | nenhum | nenhum | explícitos (−1) |
| dependência da semente | forte | menor (início por SVD) | sim, até o número de tópicos |
| custo | barato, CPU | o mais barato, CPU | modelo de embeddings; uma GPU ajuda |
Armadilhas: stop words e outliers
stop words
Sem uma lista, os tópicos são nomeados por the, of, to. Uma lista na língua errada não ajuda: o tópico 6 aqui é van, het, een, de posts em holandês.
outliers demais
O reduce_outliers reatribui os 431. Homogeneidade em todos os posts: 0,822 (c-TF-IDF) ou 0,882 (embeddings), abaixo de 0,927.
Armadilha: a granularidade é um degrau, não um botão giratório
min_cluster_size de 10 para 15: alguns tópicos a menos ou muitos?| min_cluster_size | tópicos | outliers |
|---|---|---|
| 5 | 96 | 28% |
| 10 | 24 | 20% |
| 15 | 5 | 0% |
| 25 | 3 | 0% |
Varra alguns valores e leia os tópicos; para juntar tópicos sem reagrupar, reduce_topics.
Armadilha: reprodutibilidade
Some aos embeddings um ruído de cerca de um milionésimo (o tamanho das diferenças entre CPU e GPU), mantendo todas as sementes:
| ruído, semente 0 | 24 tópicos, ARI com o original 0,908 |
| ruído, semente 1 | 24 tópicos, ARI 0,910 |
| ruído, semente 2 | 3 tópicos, ARI 0,514 |
Resumo
- Um tópico é uma distribuição sobre palavras (LDA, NMF) ou um grupo de documentos (BERTopic).
- LDA: uma história generativa; precisa de muitos documentos com palavras suficientes.
- NMF: partes aditivas da matriz TF-IDF; estável, barata e coerente.
- Escolha o \(k\) pela coerência e lendo os tópicos; a perplexidade engana.
- BERTopic: embeddings → UMAP → HDBSCAN → c-TF-IDF; forte em textos curtos, outliers explícitos, frágil às sementes e ao
min_cluster_size.
Tópicos em cinco fóruns, de três jeitos
- Cinco outros fóruns do 20 Newsgroups: 2.613 posts, entre 495 e 551 por fórum.
- Passos 2–3: LDA e NMF. Passos 4–7: o BERTopic passo a passo e depois em uma chamada. Passos 8–10: inspecionar os tópicos, compará-los com os fóruns e lidar com os outliers.
- Baixe o notebook do lab e abra no Jupyter ou no Colab; no Colab, rode
!pip install bertopicantes. - Rode os blocos em ordem, numa sessão só; quase todo o tempo vai no passo 4.